La tienda permite comprar. Estupendo. Ahora llegan más visitas, el catálogo tarda en cargar y un cliente asegura que ha pagado dos veces. "En mi ordenador iba bien" empieza a tener poco recorrido.
La arquitectura también debe responder a cómo necesita funcionar el sistema y a cómo sabremos qué está pasando cuando algo falle. Podemos conectar tres preguntas: qué esperamos de una compra, cómo comprobaremos ese comportamiento y qué pistas dejará cuando ocurra de verdad.
Poner nombre a lo que esperamos
Los atributos de calidad describen propiedades del sistema que influyen en su utilidad. Algunos de los más habituales son:
- Rendimiento: cuánto tarda una operación y qué recursos consume.
- Escalabilidad: cómo responde al crecer la carga y qué recursos necesita para hacerlo.
- Disponibilidad: en qué medida está accesible cuando lo necesitamos.
- Fiabilidad: con qué consistencia cumple correctamente su función durante unas condiciones y un periodo dados.
- Seguridad: cómo protege el acceso, los datos y las operaciones.
- Mantenibilidad: cuánto cuesta comprenderlo, corregirlo y modificarlo.
Estas propiedades se relacionan, pero cada una plantea preguntas distintas. Una tienda puede estar disponible y mostrar precios incorrectos. También puede responder rápido con diez usuarios y sufrir cuando llegan diez mil.
Para tomar decisiones necesitamos expresar las expectativas con suficiente precisión. "El catálogo debe ir rápido" deja bastante margen. Podemos concretarlo así:
En el escenario de prueba acordado, con 500 usuarios simultáneos, al menos el 95 % de las consultas de catálogo debe responder en menos de 300 milisegundos.
Es un ejemplo de objetivo. Las cifras útiles dependerán del producto y del contexto. Lo valioso es disponer de una condición que podamos evaluar.
El percentil 95 tampoco es la media: resume el tiempo que no supera aproximadamente el 95 % de las observaciones. Nuestro objetivo admite que hasta un 5 % de las consultas tarde 300 milisegundos o más. Para interpretar la medición necesitamos fijar duración, datos, mezcla de operaciones y entorno de la prueba.
También hace falta definir qué consultas cuentan y medir sus errores. Responder enseguida con un fallo no resuelve la búsqueda del cliente. Una prueba de carga aporta evidencia sobre el escenario ejecutado; observar después el catálogo real permite comprobar cómo se comporta con el tráfico que recibe.
Cada mejora tiene consecuencias
Los compromisos de diseño, también llamados trade-offs, aparecen cuando una decisión aporta ventajas y añade costes.
Guardar resultados en caché puede reducir la latencia. Después habrá que decidir cuánto tiempo toleramos información desactualizada y cómo la renovamos. En nuestra tienda, mostrar una descripción antigua puede tener consecuencias distintas de mostrar un stock incorrecto.
Añadir componentes puede repartir trabajo y permitir escalar ciertas tareas por separado. También añade comunicación, operación y nuevas situaciones de fallo.
El presupuesto, los plazos y la experiencia del equipo forman parte de esta evaluación. Una solución que nadie sabe mantener puede resultar bastante cara aunque el diagrama quede precioso.
Testabilidad: cuánto cuesta comprobar una regla
La testabilidad es la facilidad que ofrece el sistema para comprobar su comportamiento. Puede darnos pistas sobre cómo están organizadas sus piezas.
Si probar un descuento exige levantar la web, preparar una sesión y conectarse al proveedor de pagos, el cálculo arrastra bastante contexto.
Podemos separar la regla de sus interacciones con el exterior. Una función pura devuelve siempre el mismo resultado para los mismos datos de entrada y carece de efectos secundarios. Esto facilita explorar casos del cálculo sin preparar todo el entorno.
Guardar un pedido o enviar un correo son efectos secundarios: modifican algo fuera del cálculo. Consultar la hora o leer un servicio externo introduce además entradas que pueden variar. Hacer explícitas esas entradas y localizar las interacciones ayuda a comprobar qué parte falla.
La aplicación seguirá necesitando esas operaciones. Tendremos que comprobar las reglas aisladas, las integraciones y los recorridos importantes. Que el cálculo esté bien no demuestra que el pedido se haya guardado correctamente.
Elegir la prueba según la pregunta
Una prueba unitaria puede comprobar el cálculo sin red ni base de datos. Una prueba de integración puede verificar que el adaptador de pagos interpreta las respuestas del proveedor, utilizando su entorno de pruebas. Una prueba de extremo a extremo recorre una compra a través de la aplicación y comprueba el resultado que ve el cliente y el estado guardado del pedido.
Conviene reproducir también un rechazo y una respuesta que no llega. Un sustituto controlado del proveedor permite provocar esos casos, aunque no demuestra que la conexión real esté bien configurada. Si el importe es correcto pero el pedido permanece pendiente tras una confirmación, repetir pruebas del descuento nos dará poca información.
Tener todas las pruebas en verde aporta confianza sobre los casos comprobados. Quedan otras preguntas: cómo responde el catálogo bajo carga o qué ocurre si alguien intenta consultar un pedido ajeno. La calidad necesita comprobaciones relacionadas con cada expectativa.
Observabilidad: entender lo que sucede en marcha
La observabilidad permite deducir el estado interno del sistema a partir de las señales que produce.
Si un pedido sigue pendiente, necesitamos averiguar si el cobro fue rechazado, si se interrumpió una llamada o si falta procesar una confirmación. Un mensaje que diga «Ha ocurrido un error» aporta poco para distinguirlo.
Podemos utilizar señales complementarias:
- Los registros conservan eventos con su contexto, como un intento de pago y su referencia.
- Las métricas muestran medidas agregadas, como la tasa de errores o la duración de las operaciones.
- Las trazas permiten seguir el recorrido de una operación entre componentes.
Relacionar esas señales mediante identificadores ayuda a reconstruir lo ocurrido. También necesitamos elegir qué información evitamos registrar para proteger datos sensibles.
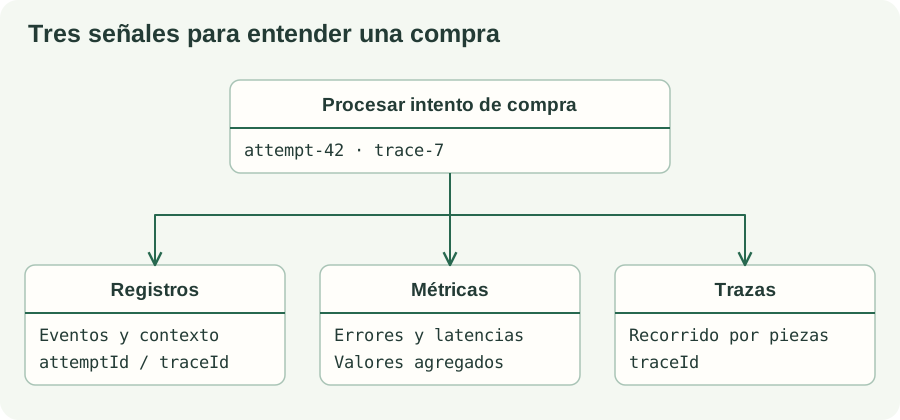
Las flechas indican señales emitidas por la aplicación. Podemos buscar attempt-42 en los registros y localizar el recorrido en una traza. Una métrica como la tasa de errores muestra si el problema es general. Conviene mantener identificadores únicos fuera de las etiquetas de las métricas agregadas: crear una serie por pedido dispararía su cantidad y su coste.
Un registro estructurado mínimo podría tener este aspecto:
{
  "event": "payment_outcome",
  "attemptId": "attempt-42",
  "traceId": "trace-7",
  "outcome": "UNKNOWN",
  "durationMs": 812
}
Ese evento aporta contexto para investigar una respuesta incierta. UNKNOWN indica que todavía no conocemos el resultado: el evento por sí solo no demuestra un rechazo ni autoriza a repetir el cobro. durationMs expresa la duración en milisegundos; los identificadores son simplificaciones didácticas. Una integración real utilizará el formato de identificadores de su sistema de trazas.
Elegimos campos técnicos y evitamos incluir credenciales o datos completos de pago. Registrar más información requiere valorar su utilidad, su acceso y su conservación.
Disponer de estas señales tampoco garantiza encontrar la causa. Hay que emitirlas donde aportan contexto y conservar la relación entre componentes. Una alerta puede avisarnos de que aumentan los pagos con resultado incierto; los registros y las trazas ayudan a investigar en qué punto se interrumpen. Un panel lleno de gráficas puede seguir dejando esa compra sin explicación.
Aplicarlo a una compra
Podemos escoger un recorrido importante y revisar tres cosas: qué esperamos de él, cómo lo comprobaremos y qué señales necesitaremos si falla.
En un cobro, eso puede traducirse en un contrato claro sobre sus resultados, pruebas de los casos relevantes y registros que permitan seguir cada intento sin exponer sus datos sensibles.
Así, los atributos de calidad empiezan a convertirse en decisiones concretas. Cuando llegue la siguiente incidencia, tendremos algo más útil que una captura de pantalla y la esperanza de poder reproducirla.