Vamos a completar una aplicación web personal para organizar una búsqueda de empleo. Ya permite guardar candidaturas, cambiar su estado y llevar una agenda de tareas y entrevistas. Ahora queremos distinguir el puesto que nos interesa de cada intento de presentarnos, encontrar nuevas ofertas y recibir avisos sin tener que revisar todo a mano.
Puedes abrir el repositorio del taller en GitHub y consultar el código mientras lees. Incluye la aplicación, las pruebas y las decisiones de arquitectura documentadas.
El funcionamiento completo será este:
- Guardamos un puesto como oportunidad. Cuando nos presentamos, abrimos una candidatura relacionada con él. El gestor impide mantener dos procesos activos para esa misma oportunidad y conserva los intentos anteriores.
- Configuramos nuestras preferencias y la búsqueda de ofertas. La aplicación puede consultar Greenhouse, un servicio donde las empresas publican vacantes, e incorporar los anuncios nuevos. Importar una oferta no envía una candidatura por nosotros.
- Pedimos avisos cuando nos interesen. Si hay novedades o recordatorios y hemos autorizado las notificaciones, el gestor guarda una solicitud pendiente. Después comprueba si corresponde enviarla y utiliza ntfy, un servicio de distribución de avisos. Guardar una solicitud y entregar el mensaje son pasos distintos; necesitamos poder saber qué ocurrió en cada uno.
Todo vive en la misma aplicación: un servidor Java con Spring Boot genera las páginas HTML mediante Thymeleaf y conserva los datos en PostgreSQL. Es un monolito modular: el código se divide en componentes con responsabilidades distintas, que se ejecutan juntos. Greenhouse y ntfy son los servicios externos con los que se comunica.
Aplicaremos DDD —diseño guiado por el dominio— para convertir las decisiones de la búsqueda en reglas del modelo. La arquitectura limpia separará esas reglas de los formularios, la base de datos y las llamadas externas. Primero seguiremos una candidatura hasta su guardado; después, una importación hasta su aviso. Así podremos justificar cada separación a partir de una operación concreta.
Partimos del gestor modular y conservamos sus funciones anteriores, incluidas importación CSV, exportaciones y estadísticas. El repositorio contiene la aplicación completa; no hace falta reconstruir el taller anterior para seguir este recorrido.
Una oportunidad, varios intentos y una regla
Supongamos que Example Labs busca una persona para backend. Guardamos estos datos:
| Dato | Valor del ejemplo |
|---|---|
| Oportunidad | O-1 |
| Empresa contratante | Example Labs |
| Puesto | Java Backend Developer |
| Modalidad | Remoto |
| Salario bruto publicado | 40.000–50.000 EUR al año |
| Objetivo de nuestro perfil | Al menos 45.000 EUR brutos al año, en remoto |
Usaré O-1 y P-1 como nombres breves para leer los ejemplos. La aplicación genera UUID para identificar oportunidades y candidaturas; estas etiquetas no son identificadores que debamos introducir en sus formularios.
Nos presentamos directamente a la empresa. Llamaremos canal a esa vía de presentación, que también podría ser una agencia. El gestor abre la candidatura P-1: copia empresa, puesto, enlace, ubicación y modalidad de la oportunidad, añade el canal y registra la fecha de hoy y el estado «Presentada». El salario sigue en la oportunidad; esa operación no crea una copia histórica de su rango salarial en la candidatura.
Después, la agencia propone presentarnos al mismo puesto. Si confirmamos que se trata de O-1, el gestor encuentra P-1 activa y rechaza otro proceso para esa oportunidad. El intento incompatible no queda guardado. Para otro puesto de Example Labs sí podemos abrir una candidatura: compartir empresa no demuestra que sea la misma vacante.
Más adelante P-1 termina en rechazo. Podemos iniciar P-2 para O-1, con otro canal, otra fecha y su propio historial. El resultado es una oportunidad relacionada con dos procesos sucesivos: P-1 rechazada y P-2 presentada. No borramos el primer intento ni cambiamos su historia para reutilizar la fila.
La regla es, por tanto, como máximo un proceso activo por oportunidad confirmada. En este gestor están activos los estados presentada (APPLIED), en proceso (IN_PROGRESS) y oferta recibida (OFFER_RECEIVED). Archivar solo cambia la visibilidad: una candidatura archivada que sigue activa continúa ocupando ese lugar.
La palabra «confirmada» importa. Si guardamos dos oportunidades distintas que en realidad representan la misma vacante, el programa todavía no conoce esa equivalencia. No la deduce porque se parezcan sus títulos. Tendremos que revisar su identidad y relacionar los procesos correctamente.
Qué estamos modelando con DDD
La introducción a DDD proponía convertir una conversación sobre el negocio en reglas. Aquí hemos hecho algo parecido: concretar qué identifica un puesto, cuándo sigue abierto un proceso y qué significa volver a presentarse. Son escenarios definidos para el taller; no los presentamos como una investigación realizada con usuarios.
Tres conceptos tienen trabajos distintos:
Opportunityrepresenta el puesto que decidimos tratar como una misma identidad. Conserva sus datos revisables y su procedencia.JobApplicationrepresenta un proceso concreto. Conserva su estado, canal, fechas, tareas, entrevistas e historial.SearchProfilereúne las preferencias actuales del único propietario: búsqueda, salario, automatización y avisos. No es una cuenta adicional ni cambia la contraseña de acceso.
También distinguimos empresa contratante, agencia y canal. employer nombra a quien ofrece el empleo; agency, al intermediario conocido. El canal pertenece al proceso: una presentación directa y otra por agencia pueden referirse a una misma oportunidad. Guardar la agencia en la oportunidad no abre automáticamente un segundo proceso.
Cada separación responde a una pregunta del ejemplo. No añadimos un catálogo de empresas ni convertimos cada campo en un objeto nuevo. WorkMode sigue siendo un enum porque remoto, híbrido, presencial y sin confirmar bastan para las reglas actuales.
La oportunidad y la candidatura tienen identidad: podemos corregir sus datos sin que dejen de ser O-1 o P-1. En DDD llamamos entidades a los objetos que distinguimos por esa continuidad. Otros datos, como un rango salarial, se comparan por los valores que contienen; no necesitan un identificador propio.
Comparar salarios después de decidir qué significan
En el perfil hemos indicado que queremos cobrar al menos 45.000 EUR brutos al año. Es un mínimo aceptable, no una cantidad exacta que deba coincidir con el salario del anuncio.
45.000 sí está dentro del rango de 40.000–50.000 EUR. La duda es cuánto nos ofrecerían a nosotros dentro de esa horquilla. Si la propuesta concreta fuese de 42.000 EUR, estaría dentro del rango publicado, pero por debajo de nuestro mínimo. Si fuese de 47.000 EUR, cumpliría el objetivo salarial.
Por eso el gestor muestra «Objetivo salarial pendiente de confirmar»: la horquilla permite alcanzar lo que buscamos, pero también incluye cantidades inferiores. Nos invita a aclarar el importe con la empresa antes de dar por cumplida esa preferencia.
OpportunityFit devuelve motivos de revisión para explicar esas diferencias. No rechaza ofertas ni calcula una puntuación que pretenda decidir por nosotros.
| Salario de la oportunidad | Motivo o resultado al compararlo con el objetivo |
|---|---|
| 40.000–50.000 EUR al año | «Objetivo salarial pendiente de confirmar»: 45.000 está dentro, pero aún podrían ofrecernos menos. |
| 30.000–40.000 EUR al año | «Salario por debajo del objetivo»: ni el máximo de 40.000 alcanza nuestro mínimo de 45.000. |
| Desde 30.000 EUR al año, sin máximo | «Objetivo salarial pendiente de confirmar»: falta conocer el techo. |
| Desde 45.000 EUR al año, o con un mínimo superior | No añade una advertencia salarial: todo el rango publicado alcanza nuestro mínimo aceptable. |
| 4.000 EUR al mes o 50.000 USD al año | «Salario sin datos comparables»: cambia el periodo o la moneda. |
| Sin salario publicado | «Salario sin datos comparables»: falta información. |
Para esos datos utilizamos un objeto de valor: un objeto cuyo significado está en sus valores, no en una identidad propia. SalaryRange reúne mínimo, máximo opcional, moneda y periodo. Dos rangos con esos mismos valores representan el mismo rango salarial. Rechaza negativos, extremos invertidos, fracciones inferiores al céntimo y cantidades que no caben en la persistencia. Las cantidades son brutas; no redondeamos una entrada inválida en silencio.
Antes de comparar importes, el servicio comprueba que sus unidades coincidan. Este método recibe el otro rango y responde si ambos usan la misma moneda y periodo:
public boolean comparableTo(SalaryRange other)
{
    return currency.equals(other.currency) && period == other.period;
}
El método no convierte meses en años ni dólares en euros. Tampoco interpreta un máximo vacío como cero o como una promesa de salario ilimitado. Son decisiones sobre el significado de los datos, como las que vimos en entidades y objetos de valor.
El perfil compara también modalidad, ubicación y puesto. En estos dos últimos utiliza coincidencias de texto sencillas: una advertencia invita a revisar el anuncio, no demuestra una incompatibilidad geográfica o profesional.
Quién puede cambiar cada cosa
Un agregado reúne datos y operaciones que deben respetar unas reglas al guardarse. Su raíz es el objeto por el que entramos para modificarlos: por ejemplo, pedimos a la candidatura que complete una tarea para que también registre el cambio en su historial. Estas reglas que siempre deben cumplirse son sus invariantes. Compartir una consulta SQL no obliga a reunir todos sus resultados en un agregado.
Opportunity permite capturar y revisar datos manteniendo identidad y procedencia. SearchProfile tiene su propia versión, de modo que cambiar el salario objetivo no modifica las oportunidades. JobApplication sigue siendo la entrada para añadir una nota, completar una tarea o registrar una entrevista.
Los guardados comprueban un contador de versión. Si abrimos un formulario con la versión 3 y otra pestaña guarda la versión 4, el envío que todavía lleva el 3 se rechaza. Así evitamos sobrescribir una corrección posterior con una copia antigua. La candidatura también utiliza este control.
Para guardar y recuperar esos modelos usamos repositorios. OpportunityRepository declara las operaciones de oportunidades; ProfileRepository, las del perfil. Son interfaces Java: especifican lo que necesita el código que las utiliza. La implementación que accede a PostgreSQL queda en otra clase. Una consulta de pantalla puede reunir datos de ambos modelos sin convertirlos en un único agregado.
Conservamos tareas, entrevistas e historial dentro de la candidatura. Por ahora sus operaciones y su registro histórico necesitan guardarse juntos. El precio es que dos cambios simultáneos en actividades diferentes del mismo proceso pueden entrar en conflicto. Separarlos tendría sentido si apareciesen reglas y escrituras realmente independientes, no solo porque las colecciones hayan crecido.
Abrir P-1: del formulario al guardado
Ya sabemos qué debe permitir el modelo. Ahora seguiremos una petición de la pantalla hasta la base de datos. Un caso de uso realiza una operación completa, como abrir una candidatura: obtiene los datos necesarios, pide al modelo que compruebe sus reglas y solicita su guardado.
Un puerto es una interfaz que declara lo que necesita ese caso de uso, por ejemplo consultar los procesos activos. Un adaptador conecta ese contrato con una tecnología o una entrada concreta. El controlador web traduce el formulario; el adaptador de persistencia ejecuta las operaciones SQL. Esa separación permite leer la decisión de negocio sin tener que leer también HTTP o JDBC, la API de Java para acceder a la base de datos.
La pantalla envía la oportunidad elegida, un identificador para el nuevo proceso y el canal. El controlador los entrega a ManageOpportunities. Este caso de uso carga O-1 y prepara un objeto Offer con los datos de candidatura; utiliza ApplicationsApi para pedir la apertura al componente que gestiona los procesos. Aquí «API» nombra una interfaz Java dentro de la misma aplicación: la llamada no viaja a otro servidor.
La clase ApplicationsFacade implementa esa interfaz. Traduce el mensaje Offer a ApplicationDetails, el objeto de valor que reúne los datos de la candidatura, y delega en OpportunityProcesses. Este último consulta cuántos procesos activos tiene O-1, aplica la regla, registra P-1 y la relaciona con O-1. Esas escrituras participan en una transacción local: se confirman juntas o se deshacen juntas si la operación falla.
Puedes pulsar cualquier diagrama para abrirlo a tamaño completo y ampliarlo con el zoom del navegador.
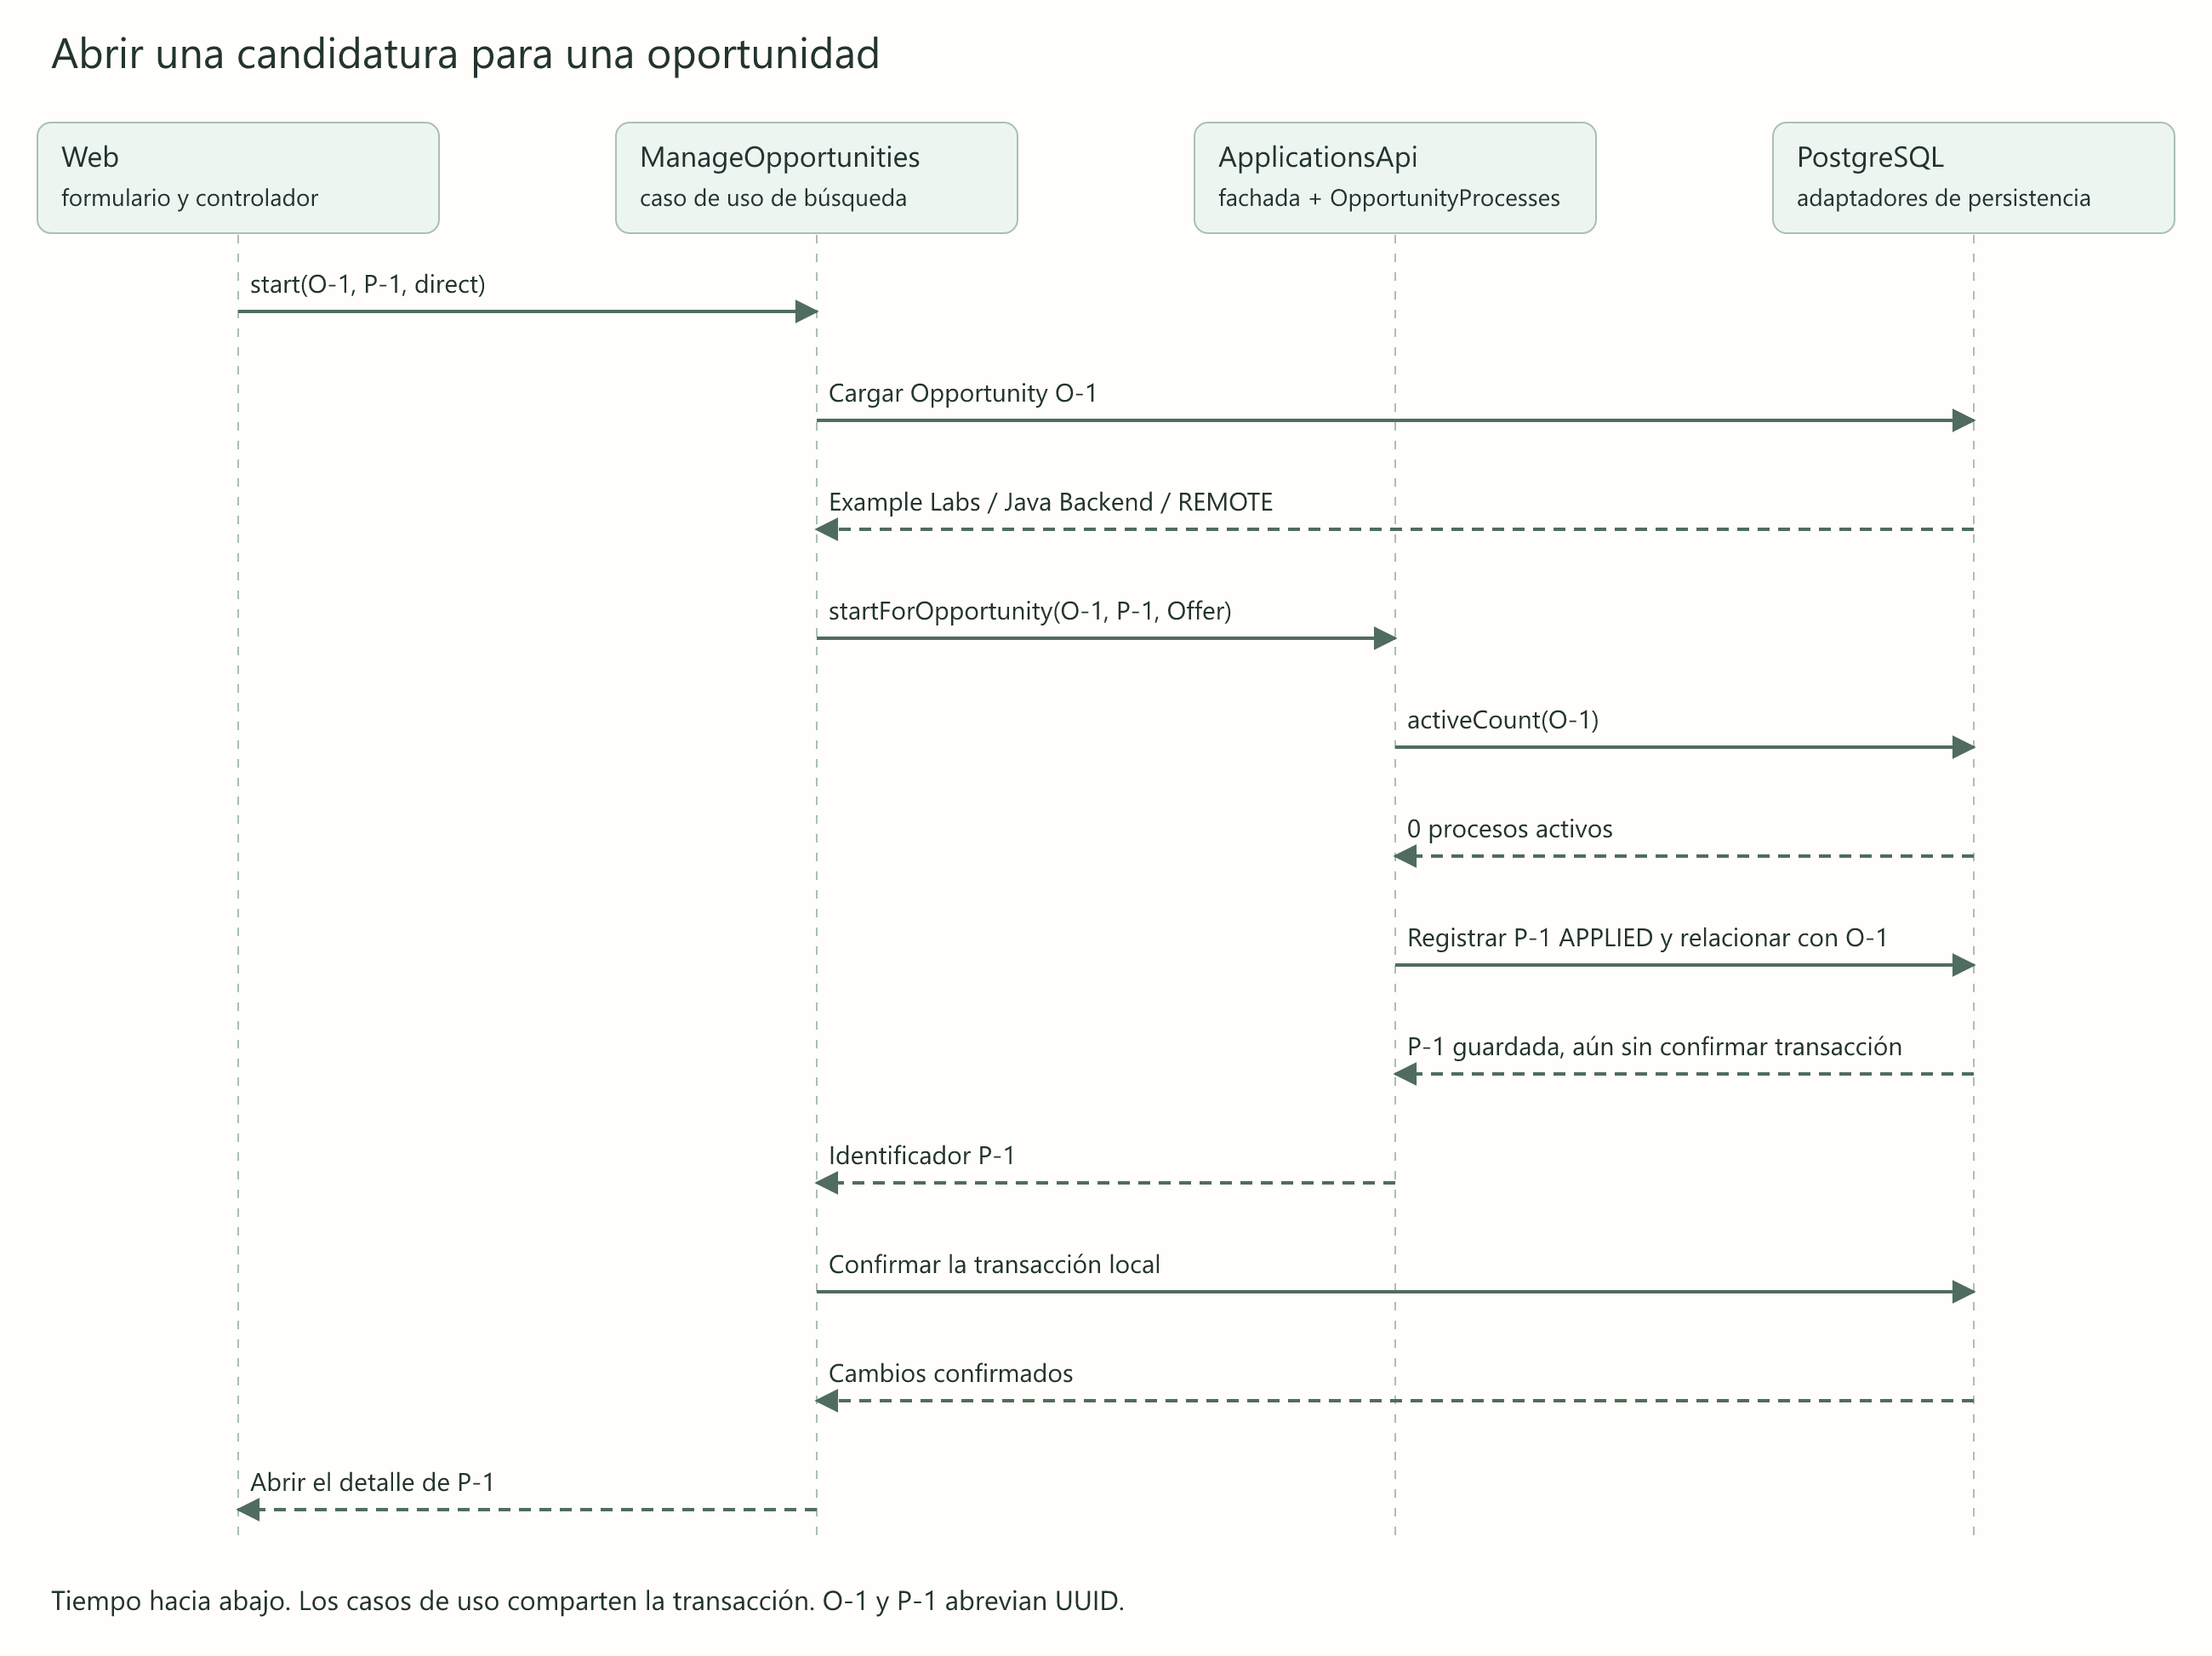
En el diagrama el tiempo avanza hacia abajo. Las llamadas muestran los datos relevantes y las respuestas, su resultado. La API y la fachada aparecen agrupadas con el caso de uso de procesos para no añadir una columna que solo delega.
ActiveProcessPolicy expresa la regla que vimos en el caso inicial. Recibe el número de procesos activos: cero permite continuar; cualquier otro valor provoca un error. La clave activeOpportunity identifica ese error en el código; la pantalla lo traduce como «Ya existe un proceso activo para esta oportunidad. Cierra el anterior antes de abrir otro».
public void requireAvailable(long activeProcesses)
{
    if (activeProcesses != 0) {
        throw new RuleViolation("activeOpportunity");
    }
}
El caso de uso recibe los identificadores y los datos ya preparados. work.required ejecuta el bloque dentro de la transacción; store es el puerto de persistencia y register registra la candidatura. El reloj se recibe como dependencia para fijar la fecha y poder comprobar el mismo comportamiento en pruebas:
public UUID start(UUID opportunityId, UUID processId, ApplicationDetails details)
{
    return work.required(() -> {
        long activeProcesses = store.activeCount(opportunityId);
        new ActiveProcessPolicy().requireAvailable(activeProcesses);

        LocalDate appliedOn = LocalDate.now(clock);
        register.execute(processId, details, Status.APPLIED, appliedOn);
        store.attachNew(processId, opportunityId);

        return processId;
    });
}
La separación visual refleja las fases: comprobar la regla, crear y relacionar el proceso, devolver su identificador. attachNew añade la relación; no intenta descubrir por su cuenta si dos anuncios representan el mismo puesto.
Dos peticiones pueden leer cero a la vez
La política anterior expresa lo permitido, pero dos peticiones pueden consultar cero procesos activos antes de que ninguna confirme su cambio. Las dos pasarían el if. Necesitamos que el almacenamiento impida confirmar las dos relaciones incompatibles.
PostgreSQL aplica este índice único: para un mismo opportunity_id solo admite una candidatura en los estados activos. La condición no comprueba si está archivada, porque ocultar una candidatura no la cierra.
CREATE UNIQUE INDEX one_active_process_per_opportunity ON job_applications(opportunity_id)
  WHERE status IN ('APPLIED','IN_PROGRESS','OFFER_RECEIVED');
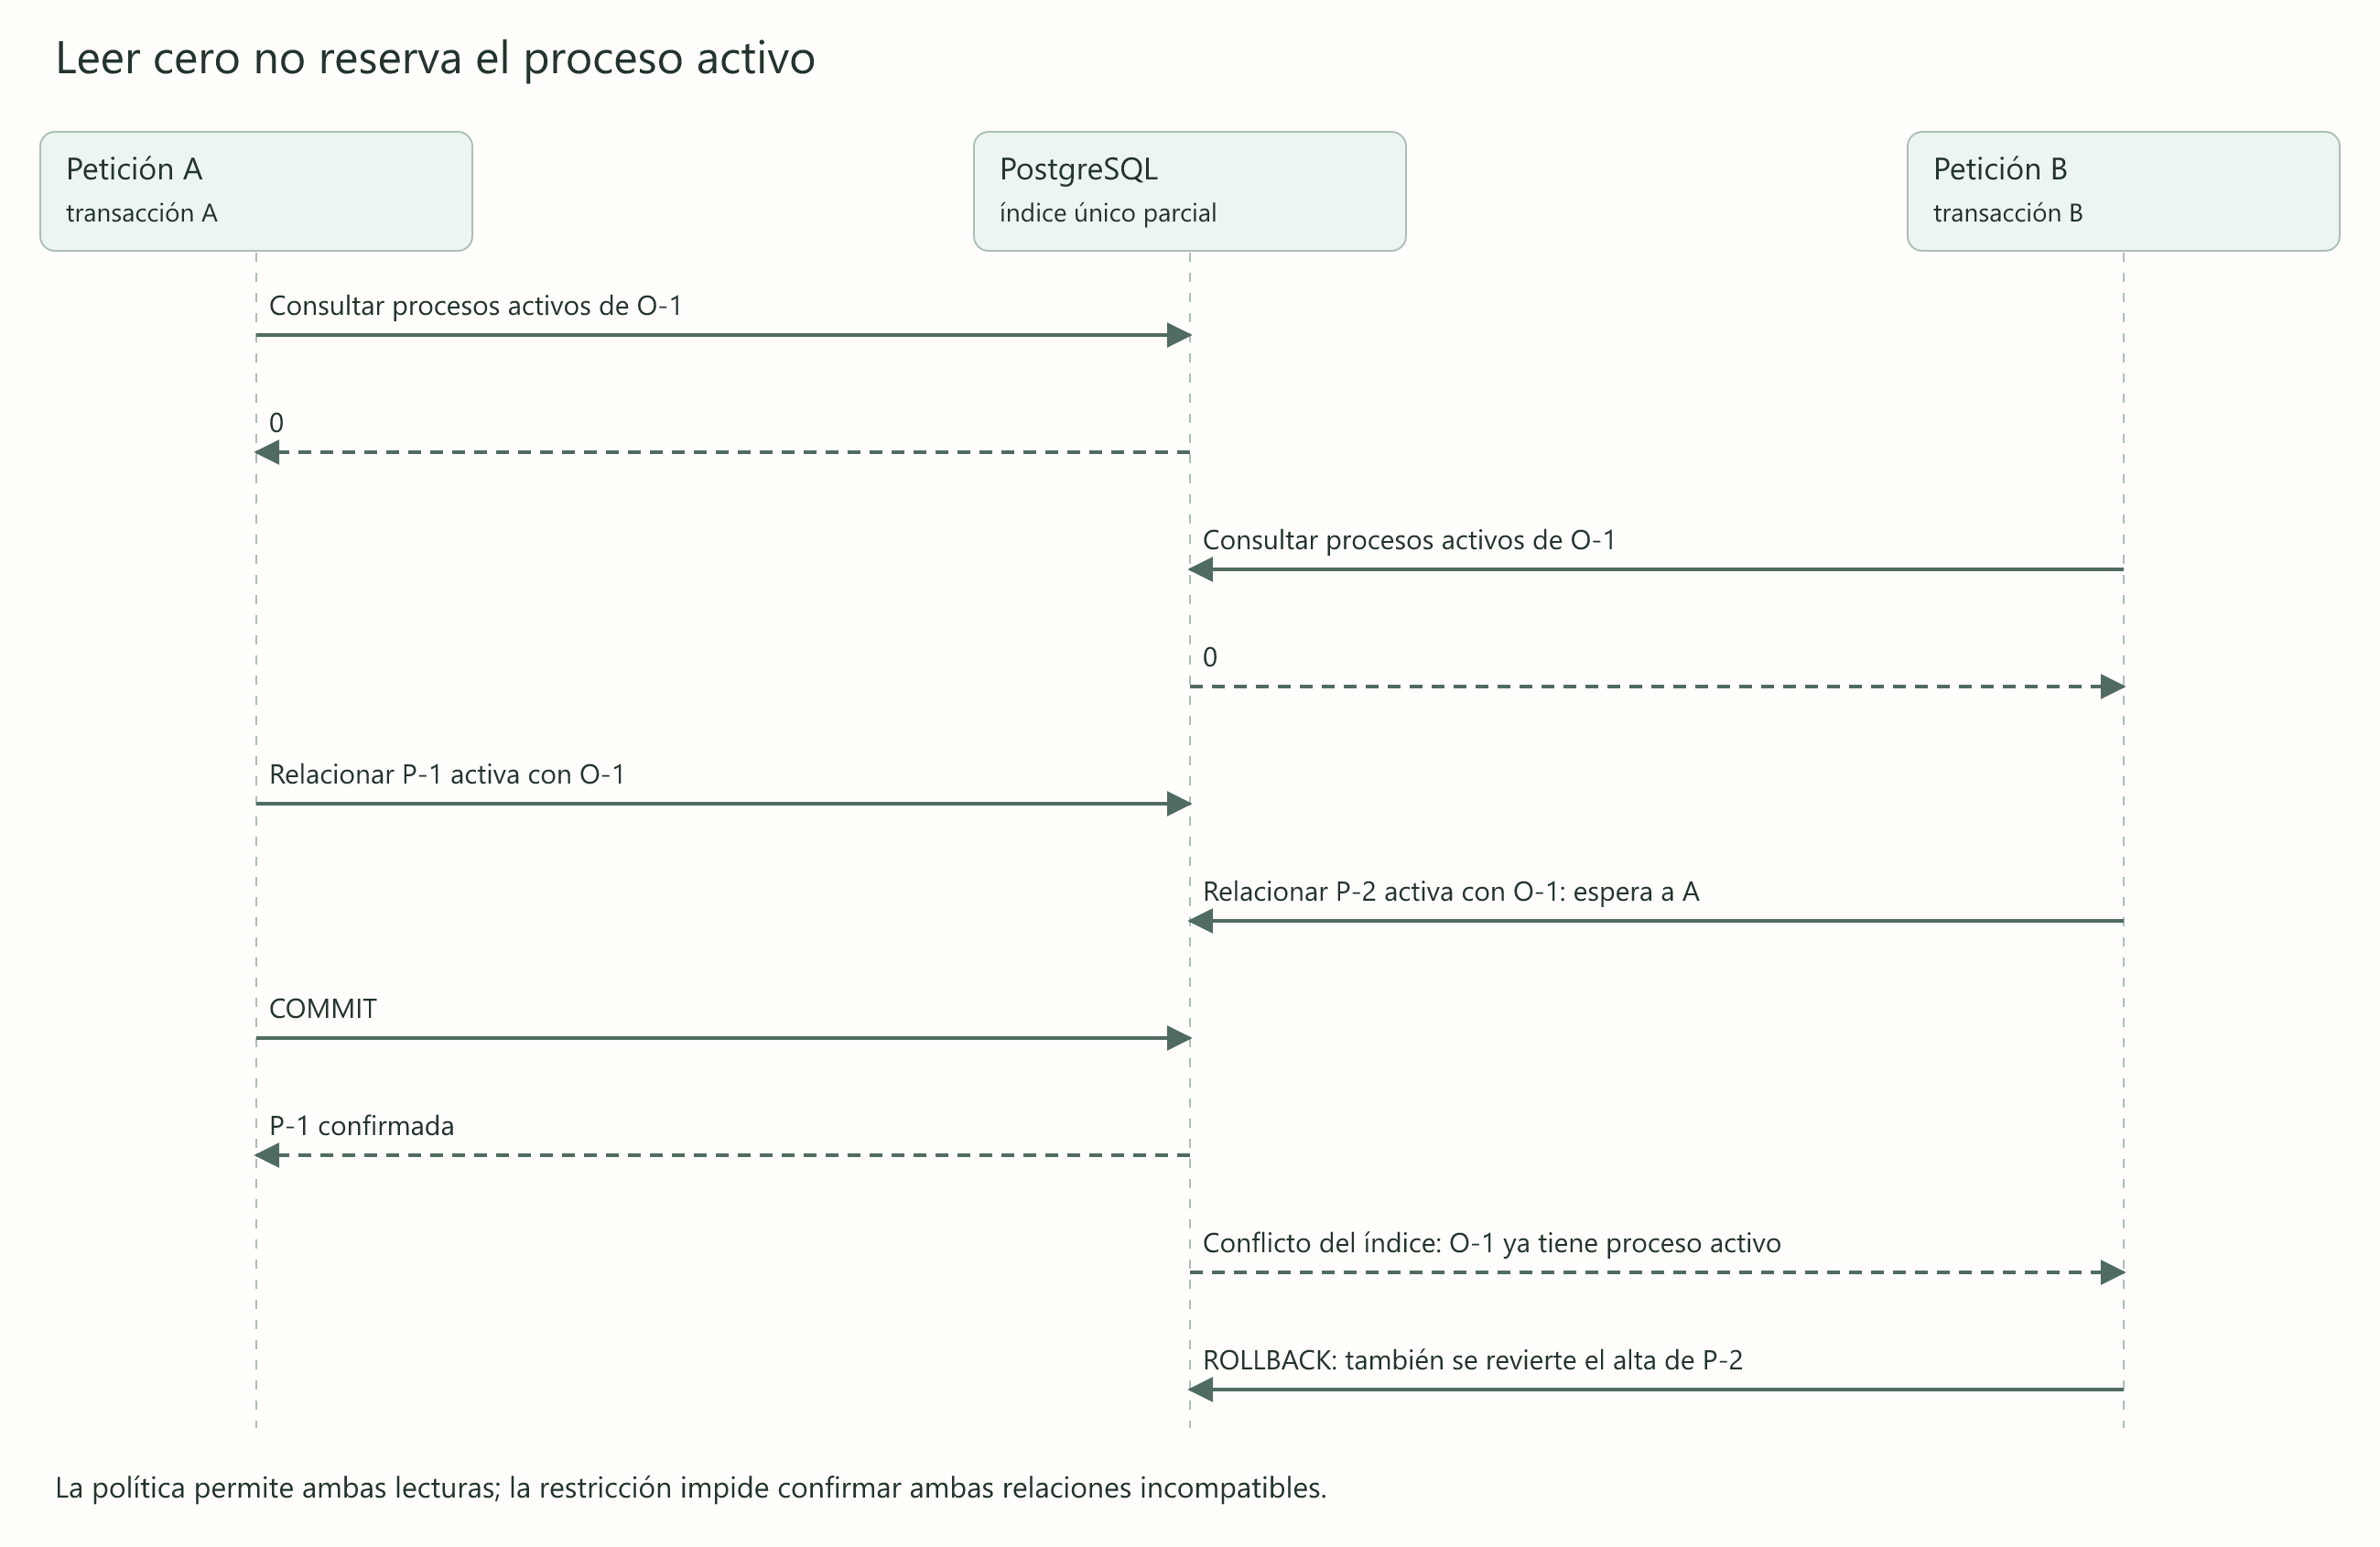
Si compiten las dos escrituras, una confirma y la otra recibe el conflicto. El adaptador lo traduce y la transacción rechazada revierte también la candidatura que acababa de registrar. No queda un proceso sin relación por haber fallado el último paso. La misma restricción impide devolver a activo un proceso cerrado si ya hay otro ocupando esa oportunidad.
Es la distinción de servicios de dominio y repositorios: la política dice qué se permite; el almacenamiento arbitra decisiones simultáneas. Ambas partes deben proteger la misma identidad y los mismos estados.
Revisar los datos anteriores sin inventar su identidad
¿Qué pasa con las candidaturas del taller anterior? La migración crea una oportunidad provisional por cada registro y conserva sus identificadores, fechas, notas y actividades. Dos filas con la misma empresa no se fusionan: podrían ser puestos distintos o intentos sucesivos.
En Oportunidades podemos buscar un proceso existente y relacionarlo con la oportunidad correcta. La petición incluye su versión. El adaptador bloquea esa fila, comprueba la versión, cambia la relación y añade la revisión al historial de identidades dentro de una transacción.
Si descubrimos dos procesos activos para la misma vacante, primero hay que decidir cuál cerrar. La revisión no puede saltarse la restricción. Las oportunidades anteriores se conservan como procedencia; no hay una fusión automática de historiales.
Las altas clásicas y el CSV siguen funcionando sin exigir una identidad revisada desde el primer momento. Mientras no relacionemos esos registros, la aplicación no puede garantizar que representen vacantes diferentes. Es un límite deliberado de compatibilidad, no una deduplicación por similitud que haya fallado.
También conservamos las actividades al guardar. CollectionChanges, una ayuda del adaptador de persistencia, mantiene los elementos que no cambian y añade o sustituye los necesarios. Una prueba con un historial de 501 entradas comprueba que añadir otra no reescribe una fila anterior. Eso verifica una propiedad del guardado; el agregado sigue cargando su historial completo.
Greenhouse: qué recibimos y qué incorporamos
Hasta aquí hemos seguido una oportunidad introducida a mano. Ahora automatizaremos su entrada: consultaremos un tablón de vacantes de Greenhouse y convertiremos sus anuncios en oportunidades del gestor. En la configuración de la aplicación indicamos el tablón y la empresa contratante. La consulta utiliza su Job Board API pública: esta sí es una llamada HTTP a un servicio externo.
Supongamos que el tablón configurado es example, la empresa es Example Labs y recibimos esta respuesta abreviada con dos publicaciones nuevas:
{
  "jobs": [
    {
      "id": 42,
      "title": "Platform Developer",
      "location": {"name": "Madrid"},
      "absolute_url": "https://example.test/jobs/42"
    },
    {
      "id": 43,
      "title": "Data Engineer",
      "location": {"name": "Valencia"},
      "absolute_url": "https://example.test/jobs/43"
    }
  ]
}
El caso de uso de importación pide ofertas mediante OfferFeed, un puerto cuyo método fetch devuelve una lista con la procedencia y los datos de cada anuncio. GreenhouseFeed es el adaptador que implementa ese contrato: consulta Greenhouse y traduce su respuesta. Para la primera publicación produce estos datos:
| Campo que recibe la importación | Valor y procedencia |
|---|---|
sourceKey |
greenhouse:example:42: proveedor, tablón e ID de publicación. |
employer |
Example Labs, de la configuración; no se deduce del nombre del tablón. |
role / location / url |
Platform Developer, Madrid y el enlace de la respuesta. |
workMode / salary |
Sin confirmar y ausente: esta respuesta no permite determinarlos. |
El ID es el de la publicación, no una identidad universal de la vacante. Tampoco convertimos la palabra «Remote» de una ubicación en una política de teletrabajo. El HTML remoto queda fuera del contenido que mostramos.
El adaptador limita tiempos y cuerpo recibido, no sigue redirecciones y rechaza respuestas mayores de 2 MiB, listas de más de 1.000 publicaciones o datos sin identidad válida. Obtiene y comprueba el lote antes de abrir la transacción que guardará las oportunidades.
ImportFeed guarda las claves desconocidas y omite las conocidas. En el ejemplo añade dos oportunidades. Al consultar otra vez los mismos IDs, añade cero y no sobrescribe nuestras correcciones. El coste de esa decisión es visible: un cambio legítimo del proveedor no se incorpora solo. Aceptarlo exigiría comparar versiones o mostrar diferencias.
Del lote nuevo a un mensaje concreto
Podemos importar sin enviar avisos. Para seguir el recorrido completo, supongamos que el perfil permite notificaciones externas, activa su generación automática y marca las novedades de oportunidades. También hay un destino ntfy configurado y estamos fuera del intervalo de silencio, las horas en que aplazamos los envíos.
Para separar el guardado del envío usamos una cola persistente: solicitudes pendientes conservadas en PostgreSQL. Si la aplicación se apaga, esas solicitudes siguen guardadas para revisarlas al volver a arrancar.
La importación del ejemplo crea una ejecución —la llamaré R-1— con dos altas. En la misma transacción guarda las oportunidades, el resultado de R-1 y una solicitud de resumen mediante el contrato NotificationRequests. La solicitud empieza en estado PENDING, pendiente de envío. Esta llamada guarda trabajo para después; todavía no envía HTTP.
La solicitud conserva una clave derivada de R-1, el tipo de aviso NEW_OPPORTUNITIES, el recuento 2, su fecha de creación y una caducidad de 24 horas. No guarda el texto completo de los anuncios para transmitirlo después. Si falla el guardado de la solicitud, también se revierten las oportunidades y el resultado de éxito.
Después interviene DispatchNotifications, el caso de uso que entrega los avisos. Lee las solicitudes pendientes, comprueba si todavía se pueden enviar y pide el envío al canal externo. Se ejecuta dentro de la misma aplicación, en un momento distinto al de la importación.
Este procesador revisa la cola cada minuto, en lotes de hasta 25. Antes de enviar comprueba preferencias y caducidad. Reclama la solicitud cambiando PENDING a SENDING —envío iniciado— mediante una actualización que solo se acepta si seguía pendiente. Confirma ese cambio antes de llamar al proveedor: solo quien consigue la transición puede enviar y ninguna transacción queda abierta durante esa llamada HTTP.
NotificationChannel es el puerto de salida: recibe un mensaje con su tipo y, para este resumen, el número de oportunidades nuevas. NtfyChannel lo implementa y convierte ese mensaje en esta petición abreviada, según el contrato de publicación de ntfy:
POST /private-topic HTTP/1.1
Content-Type: text/plain; charset=utf-8
Title: Job Tracker

Job Tracker found 2 new opportunities.
Ese es el contenido del aviso: un recuento. No salen la empresa, los salarios, las notas ni los detalles de las entrevistas. El destino y el token opcional se configuran fuera del perfil. Una respuesta HTTP 2xx deja el resultado SENT: el proveedor aceptó la petición, no sabemos si una persona la leyó.
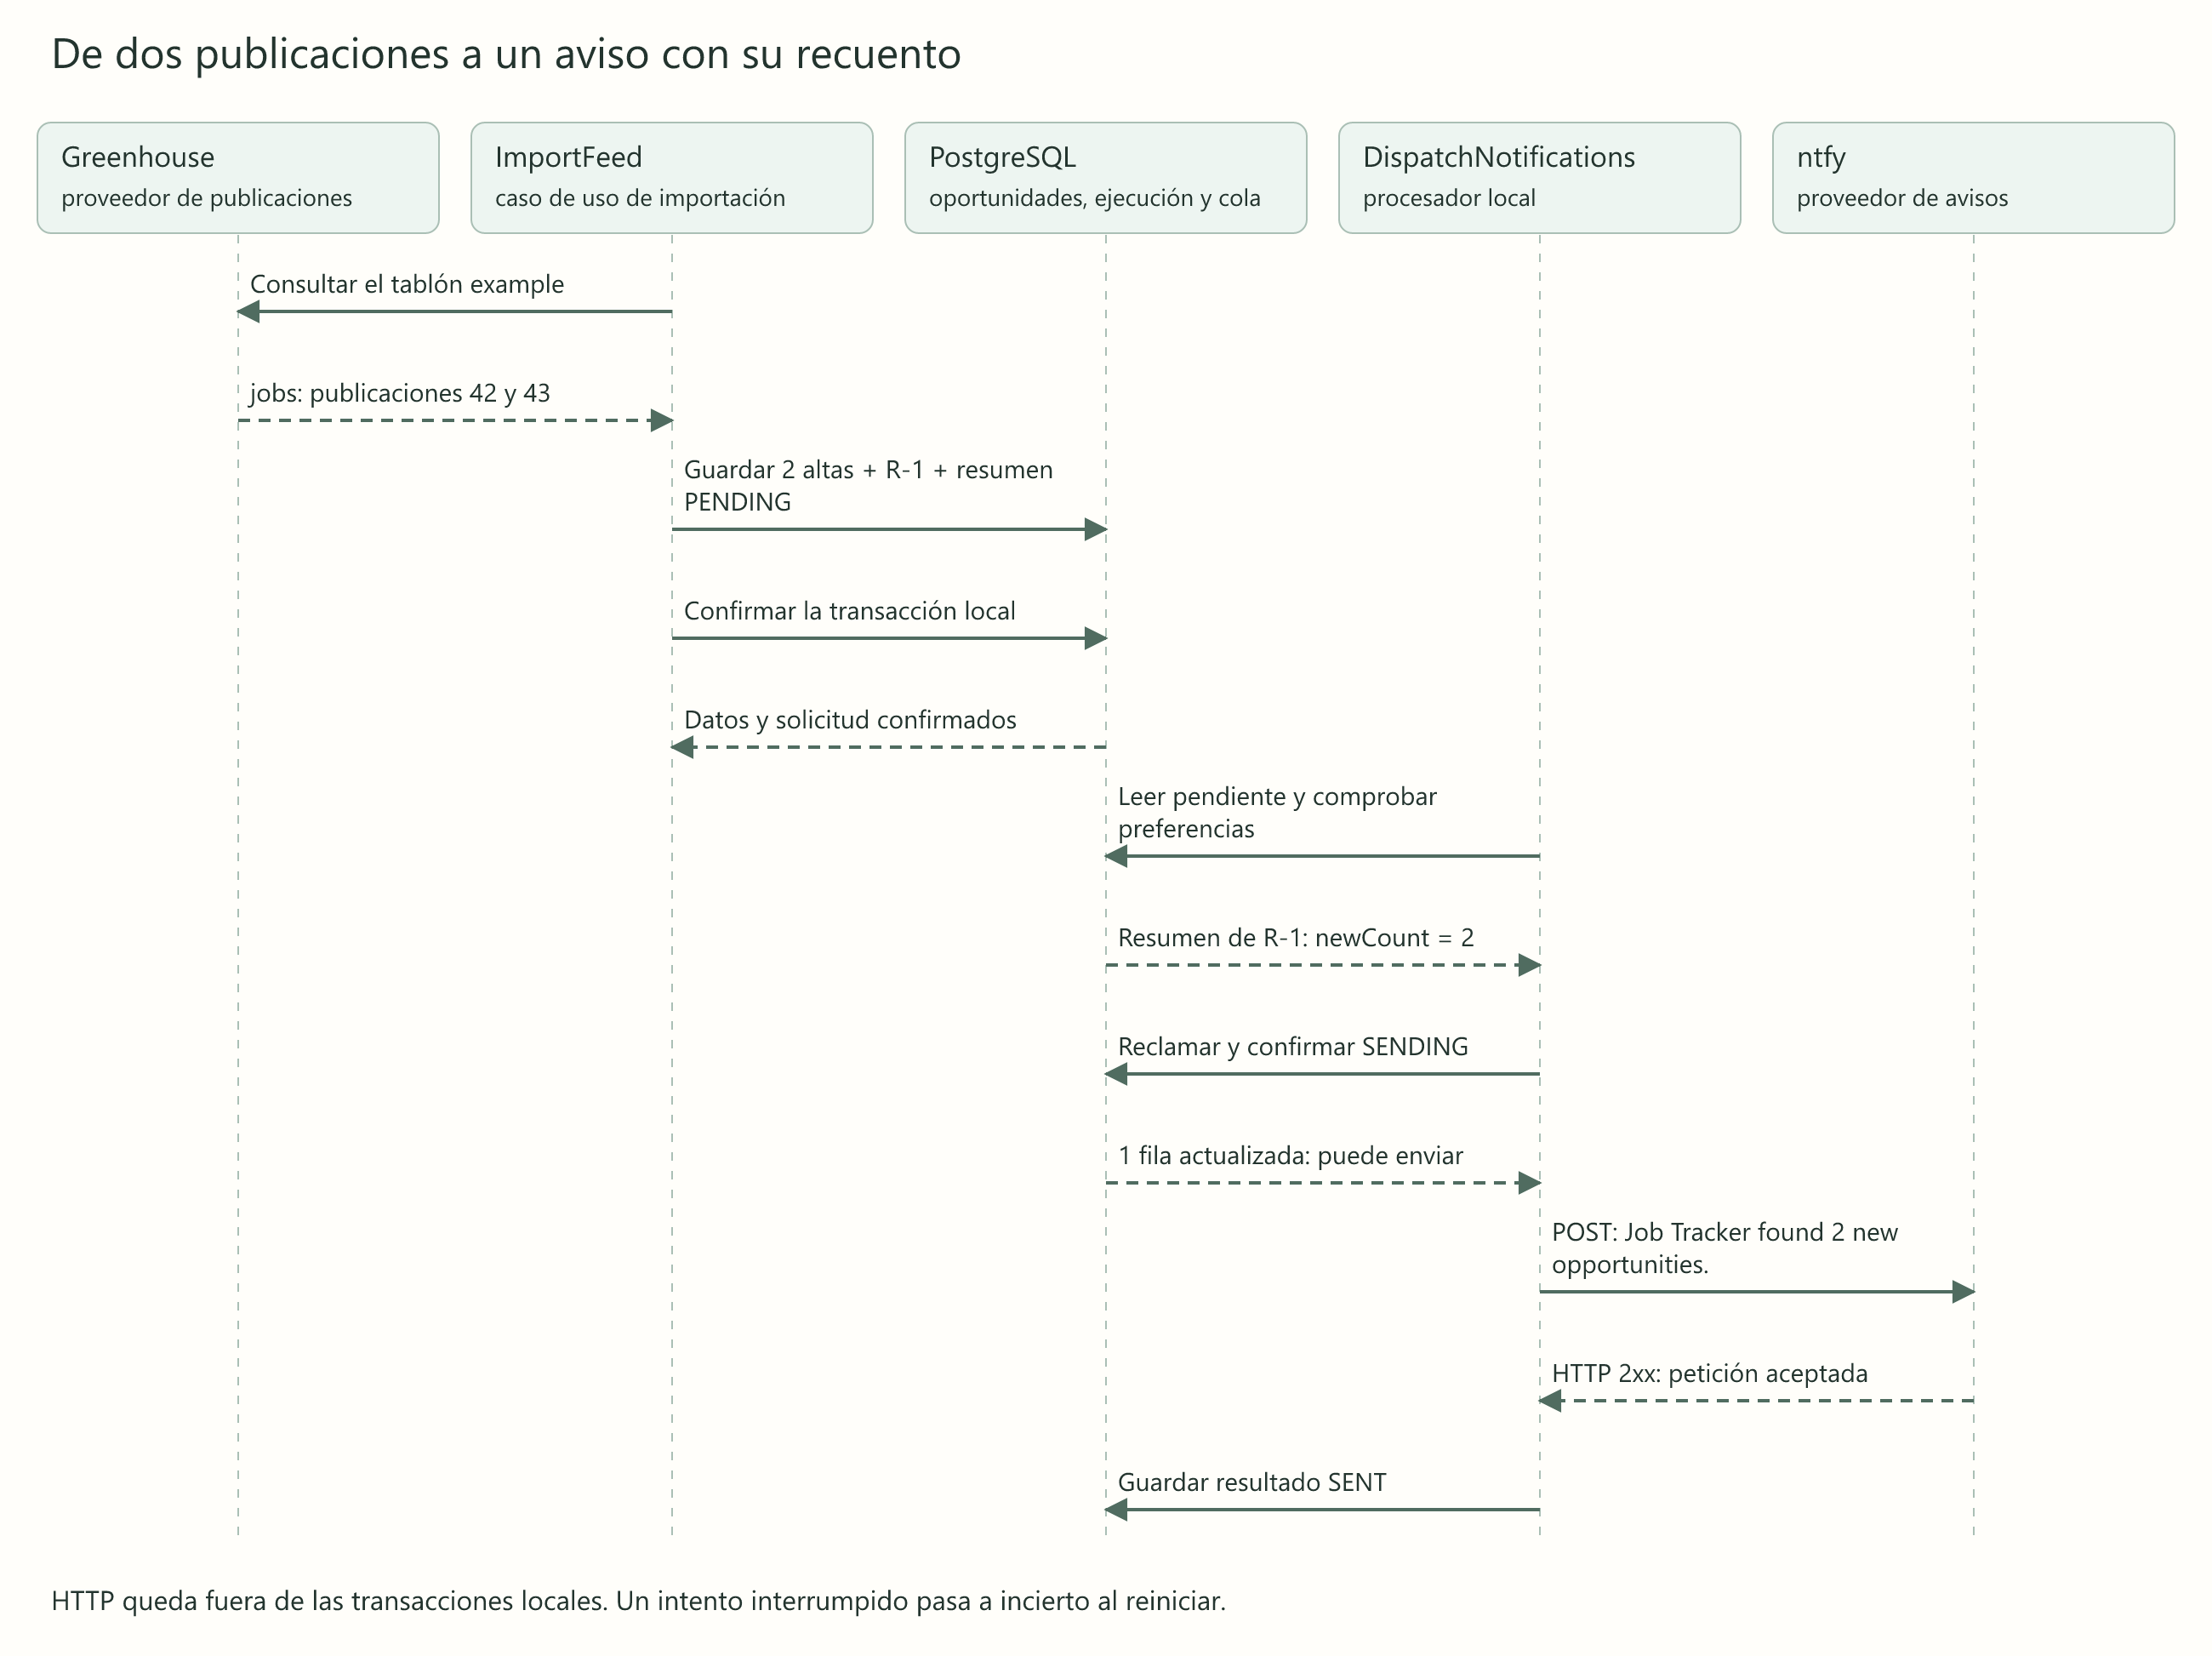
La siguiente importación de las publicaciones 42 y 43 encuentra las dos claves y añade cero oportunidades. Por eso no solicita otro resumen. En cambio, otra ejecución que incorpore publicaciones nuevas tendrá su propia identidad y podrá producir su aviso.
Pendiente, enviado e incierto significan cosas distintas
Una cola no convierte la base y el proveedor en una sola transacción. Si el proceso cae después de confirmar SENDING, no sabemos si ntfy recibió el mensaje. Al reiniciar lo marcamos UNCERTAIN y no lo repetimos automáticamente. Elegimos evitar duplicados admitiendo que algún aviso pueda perderse.
| Estado | Qué sabemos y qué hacemos |
|---|---|
PENDING |
No ha empezado el intento. Puede recuperarse tras reiniciar. |
SENDING |
El intento está reservado. Otro procesador no puede reclamarlo. |
SENT |
ntfy respondió con aceptación; no acredita lectura. |
REJECTED |
Recibimos un rechazo HTTP 4xx. Se conserva sin reintento automático. |
UNCERTAIN |
Hubo una respuesta ambigua, un corte o un intento interrumpido. Requiere revisión. |
CANCELLED / EXPIRED |
Las preferencias, la actividad o la caducidad impiden entregar. |
Los avisos de tareas y entrevistas recorren la misma cola. El contrato ReminderNotifications proporciona el identificador de actividad, el tipo de aviso y la fecha que lo origina. Selecciona tareas vencidas y entrevistas en las próximas 24 horas. Para ellas el texto externo es You have a pending reminder in Job Tracker.
La clave combina el identificador de actividad, el tipo de aviso y la fecha que lo origina. Solicitar el mismo recordatorio desde la web y generarlo automáticamente produce una sola fila. Antes de entregarlo se vuelve a comprobar su vigencia: completar una tarea o reprogramar una entrevista puede volver obsoleto el aviso pendiente.
El silencio usa la zona del perfil. De 22:00 a 08:00 incluye las diez de la noche y termina a las ocho de la mañana; durante ese intervalo el aviso espera. Dos horas iguales desactivan el silencio. Revocar el consentimiento cancela los pendientes; desactivar una categoría o la generación automática cancela sus solicitudes automáticas. Los cancelados conservan su clave y no se reactivan al volver a marcar una casilla.
También podemos solicitar un aviso manualmente sin activar la generación automática. La petición respeta consentimiento y silencio y queda en cola para el siguiente ciclo. Cambiar las preferencias después de que empiece una llamada HTTP no puede retirar esa petición de la red.
Automatización con un alcance concreto
El perfil activa por separado la consulta periódica del tablón y la generación de avisos. Ambas comienzan desactivadas. El intervalo del tablón va de 15 a 1.440 minutos, con 60 como valor inicial.
Cada minuto el trabajo de importación consulta la fecha del último intento y decide si corresponde otra consulta. Un fallo también espera el intervalo elegido. Tras dos días apagado, el gestor realiza una consulta cuando le toca; no reproduce todas las que omitió. Integraciones muestra origen, fechas, resultado y cantidades de cada ejecución.
Las entradas manuales y automáticas pasan por el mismo caso de uso sincronizado. Ese bloqueo pertenece a una instancia de la aplicación. El planificador, que lanza los trabajos periódicos, dispone de tres hilos para que una importación que espera a la red no ocupe toda la capacidad de agenda y avisos. Esto no añade soporte para varias réplicas ni ejecución con el programa apagado.
Dónde quedan DDD y la arquitectura limpia
Ya hemos recorrido las dos operaciones completas. Ahora podemos situar sus fronteras. En DDD, un contexto delimitado es un ámbito donde un modelo y su vocabulario tienen un significado acordado. Aquí, el seguimiento de la búsqueda comparte oportunidades, procesos y actividades; notificaciones utiliza un modelo más pequeño, de solicitudes y resultados.
Los módulos Maven son las unidades en que se organiza y compila el proyecto. No se convierten automáticamente en contextos delimitados: importaciones, exportadores y estadísticas siguen siendo capacidades del monolito.
Notificaciones define NotificationPreferences, el puerto de preferencias que necesita. Un adaptador de búsqueda traduce el perfil a ese contrato. Búsqueda utiliza NotificationRequests para solicitar avisos; notificaciones no importa SearchProfile. Así evitamos una dependencia circular entre ambos módulos.
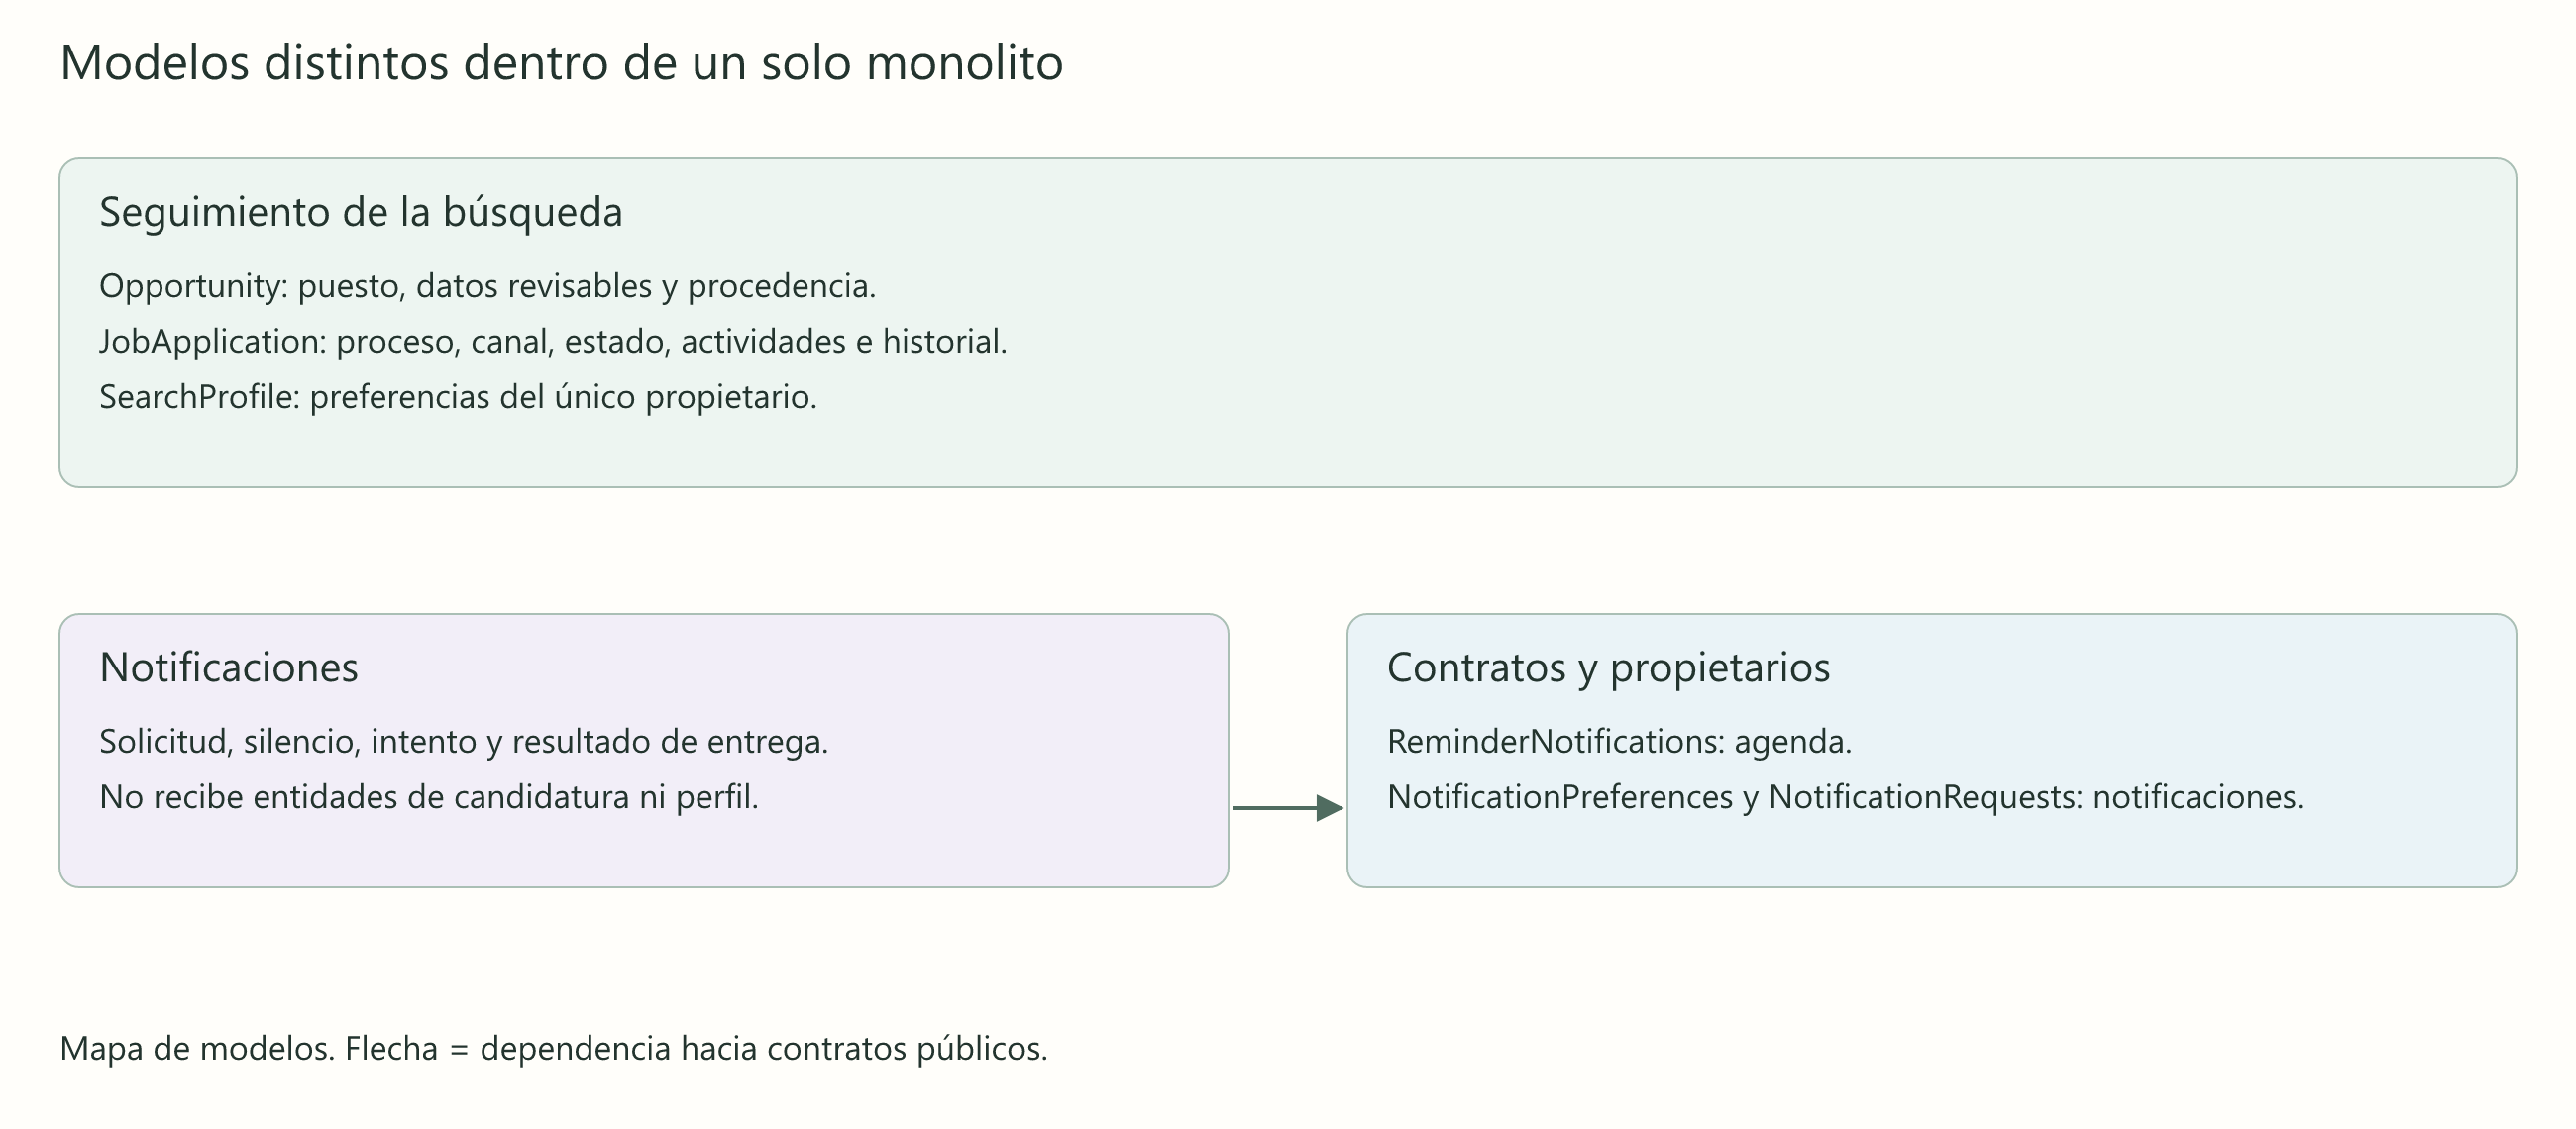
Dentro de cada capacidad, los casos de uso conocen reglas y contratos. JDBC, HTTP y formularios quedan en adaptadores. Por ejemplo, OpportunityProcesses puede terminar ejecutando SQL durante una petición, pero su código solo conoce el contrato OpportunityProcessStore. La composición —el código de configuración que crea y conecta las piezas— asigna a ese contrato su implementación.
En el siguiente mapa las flechas representan dependencias de código: qué tipos necesita conocer cada parte para compilar. No representan el recorrido de una petición ni llamadas entre servidores.
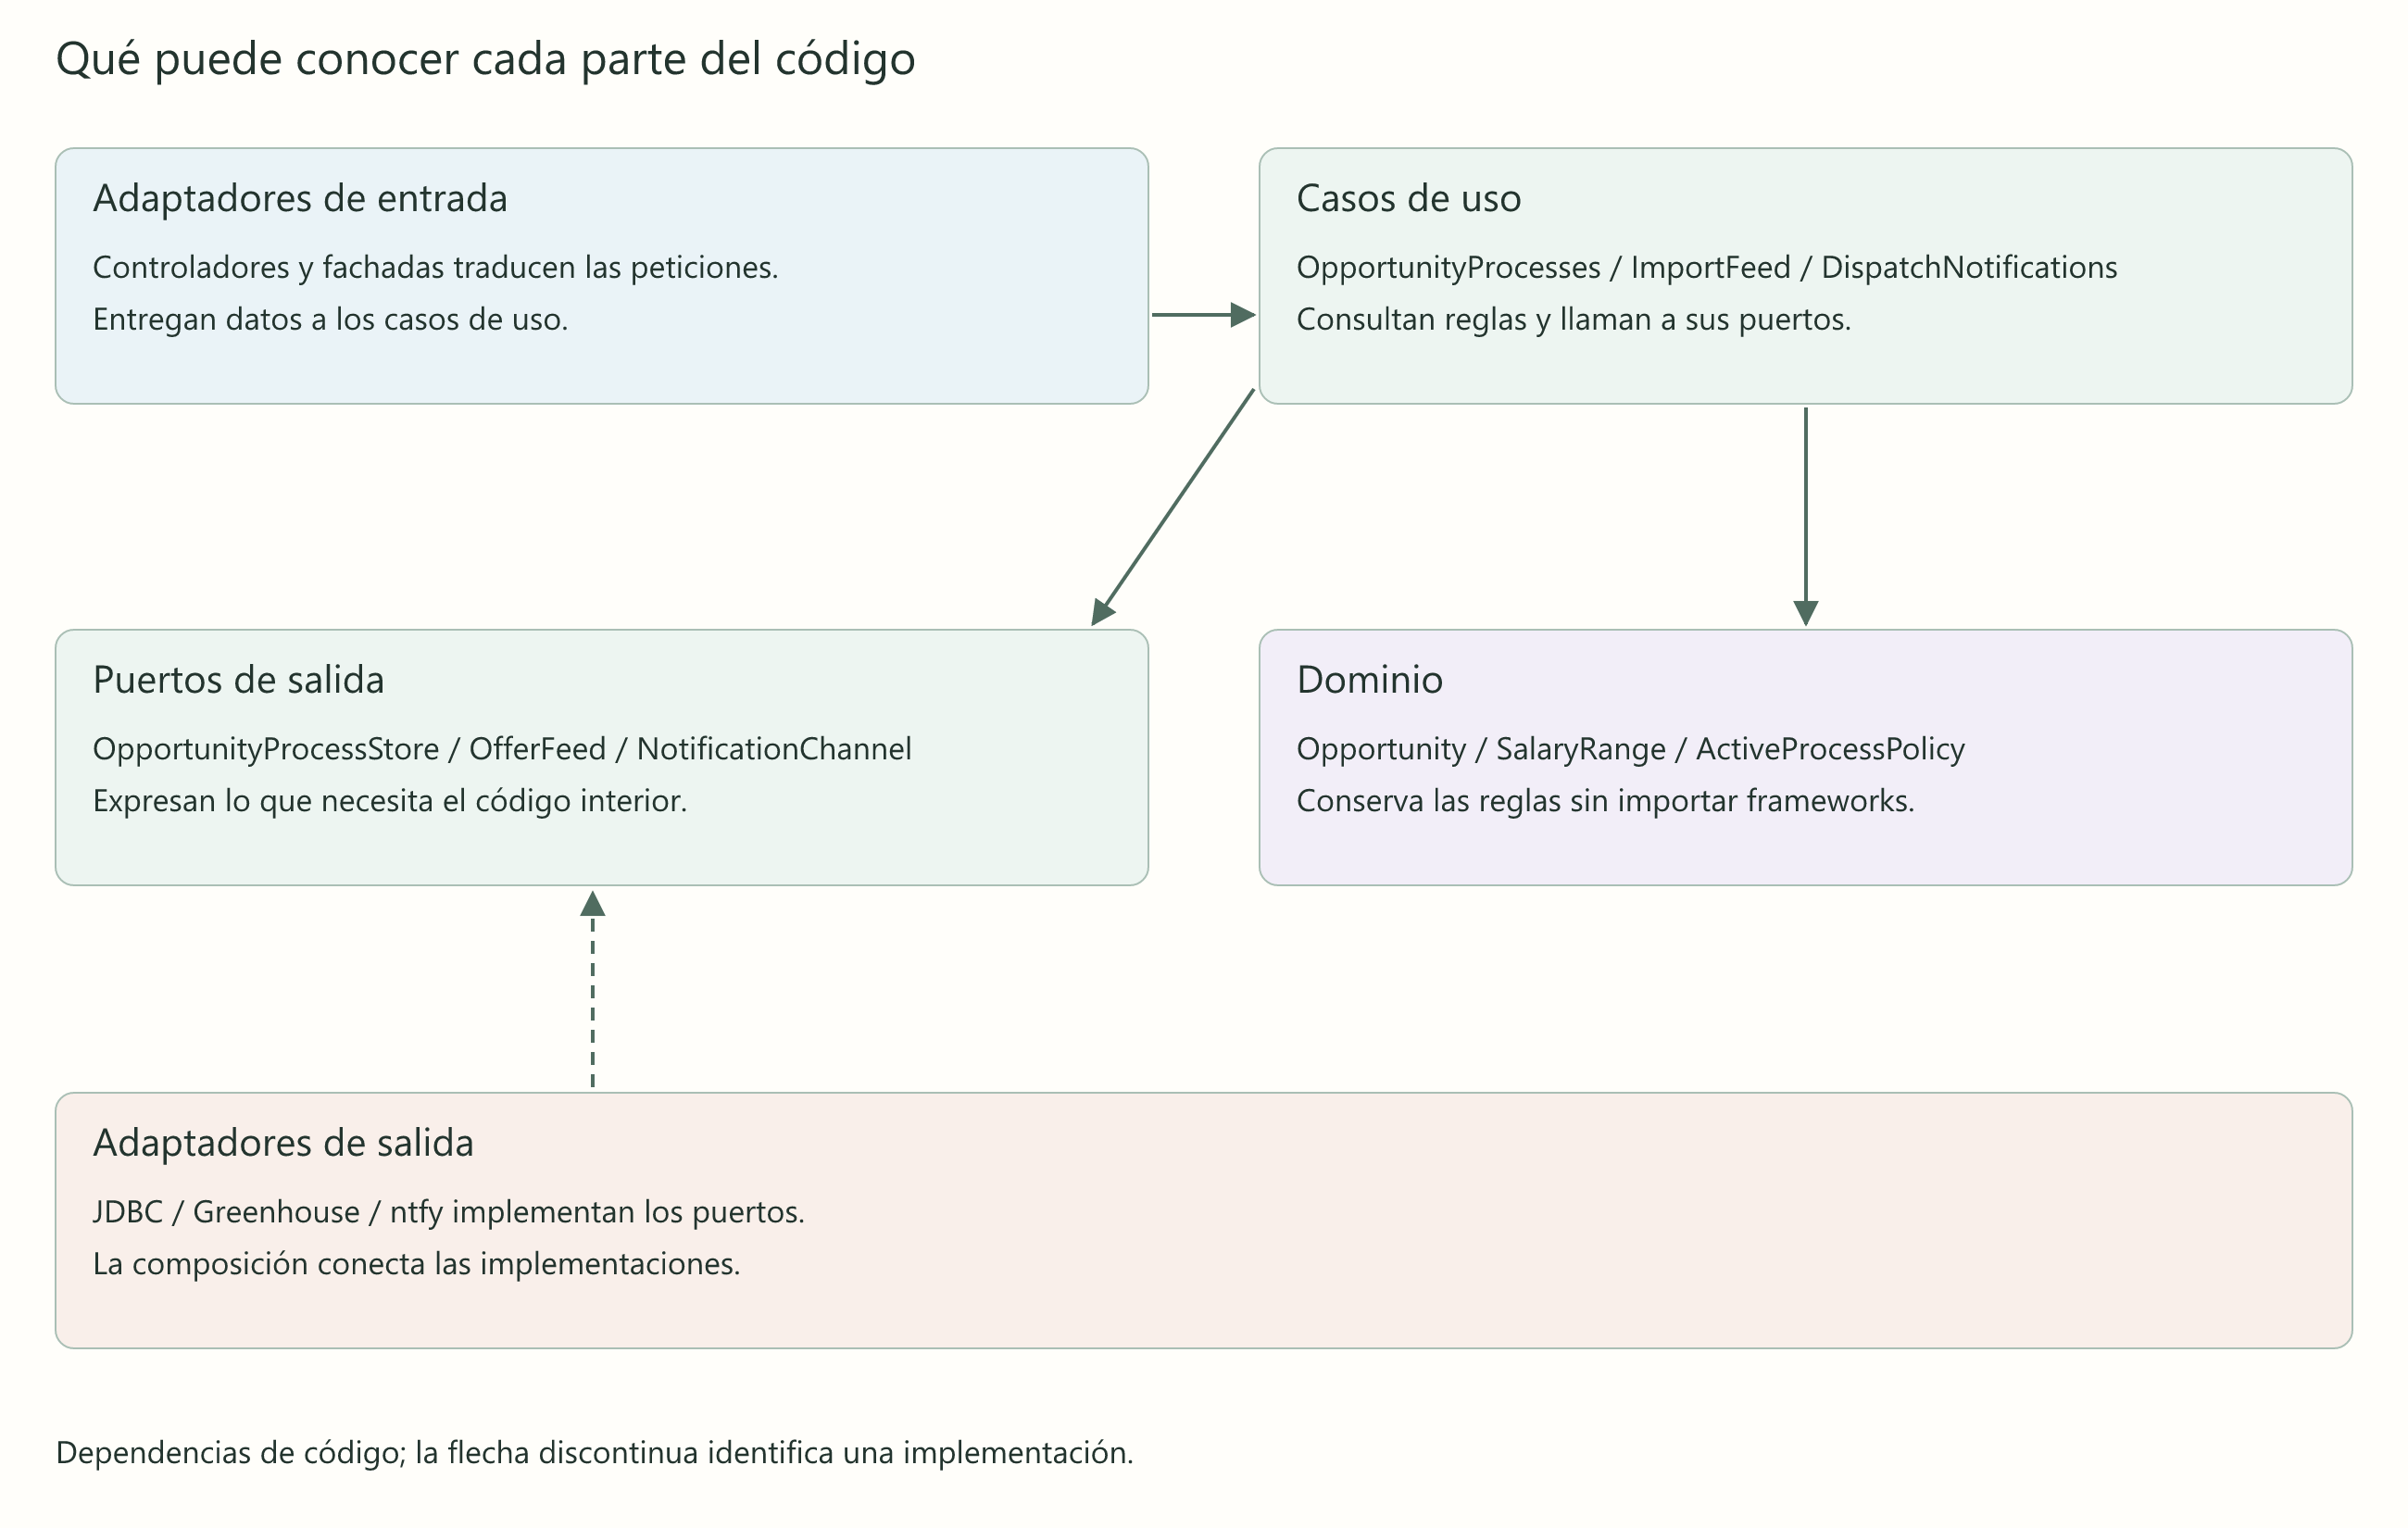
ArchUnit, una herramienta que inspecciona las dependencias del código Java, comprueba que dominio y aplicación no importen Spring, JPA —el mecanismo de persistencia de objetos utilizado en candidaturas— o adaptadores, que los consumidores usen las APIs públicas y que no aparezcan ciclos.
La regla de dependencias de Clean Architecture no exige cuatro capas idénticas para cada formulario. Tampoco elimina decisiones prácticas: oportunidades y aviso comparten una transacción porque comparten base y gestor de transacciones. Extraer notificaciones a otro servicio obligaría a revisar esa garantía.
Ordenar las carpetas dentro del componente
El módulo de candidaturas contiene tipos con trabajos distintos. JobApplication es la raíz del agregado; ApplicationDetails, un objeto de valor. Checks normaliza y valida campos. Compartir la carpeta inicial no los convierte en la misma categoría DDD.
Al crecer el componente, agrupamos esas responsabilidades dentro de domain:
applications/domain/
  candidacy/
    JobApplication.java
    ApplicationDetails.java
    WorkMode.java
  activity/
    Interview.java
    FollowUpTask.java
  history/
    TimelineEntry.java
    TimelineEvent.java
  status/
    Status.java
    StatusChange.java
  policy/
    ActiveProcessPolicy.java
  validation/
    Checks.java
  RuleViolation.java
Podemos encontrar la regla de proceso activo en policy y los datos de la candidatura en candidacy. Una tarea y una entrevista siguen siendo partes del mismo agregado aunque sus archivos estén en activity. La carpeta no decide qué se guarda junto ni añade otra transacción.
En application conservamos los grupos de actividades, detalles, estados y consultas; añadimos el de procesos y distinguimos puertos, errores y coordinación común. En los adaptadores web agrupamos pantallas de candidatura, seguimiento, seguridad y apoyo compartido. Las filas JPA y su guardado permanecen juntas para conservar su acceso interno.
Java representa esas subcarpetas mediante subpaquetes. Algunas operaciones que antes tenían visibilidad de paquete necesitan ser públicas para que JobApplication pueda utilizarlas desde candidacy. ArchUnit restringe las llamadas de edición de actividades y generación de historial a esa raíz; una prueba introduce accesos indebidos y comprueba que se rechazan. Es una restricción comprobada en calidad, no privacidad garantizada por el compilador.
Búsqueda distingue oportunidad, perfil, compatibilidad y validación; sus valores salariales y de modalidad siguen compartidos. Notificaciones separa generación, entrega y puertos. Su dominio conserva solo dos tipos y no necesita otra subdivisión. El criterio es que cada grupo permita reconocer un trabajo, manteniendo los contratos y las reglas que ya explicamos.
Probar el caso en el proyecto
El README de la revisión explicada reúne las instrucciones de arranque, configuración de integraciones, estilo, pruebas y recuperación de datos.
Una vez en la aplicación, puedes reproducir la regla central: guardar tus preferencias en Mi perfil, añadir una oferta en Oportunidades y abrir una candidatura. Intenta abrir otra para la misma oportunidad: debe rechazarse. Cierra la primera y vuelve a intentarlo: ahora debe permitirlo, conservando ambos intentos. Archivar la candidatura, por sí solo, no libera el proceso activo.
El coste añadido tiene una razón: conservar intentos sucesivos, impedir procesos incompatibles, comparar información sin mezclar unidades y saber qué ocurrió al pedir un aviso externo. Las extensiones también tendrán que justificar su coste. Antes de permitir dos procesos activos para O-1, por ejemplo, habría que decidir qué distinguiría esas convocatorias y qué caso concurrente debería impedir la base. Cambiar solo el if dejaría la decisión a medias.