Subes un cambio, pasan las pruebas y la aplicación arranca. Todo parece listo. Pero todavía quedan unas cuantas preguntas: ¿qué versión está funcionando en el servidor?, ¿quién puede desplegar otra?, ¿cómo te enteras de que las peticiones empiezan a fallar? Y, si ocurre, ¿cómo recuperas el servicio?
DevSecOps reúne desarrollo, seguridad y operación para cuidar ese recorrido completo. El equipo acuerda cómo entregar los cambios, automatiza las comprobaciones que puede repetir y utiliza lo que ocurre en producción para mejorar la siguiente entrega. La seguridad acompaña esas decisiones desde el diseño hasta el mantenimiento.
Del cambio a una aplicación que sigue funcionando
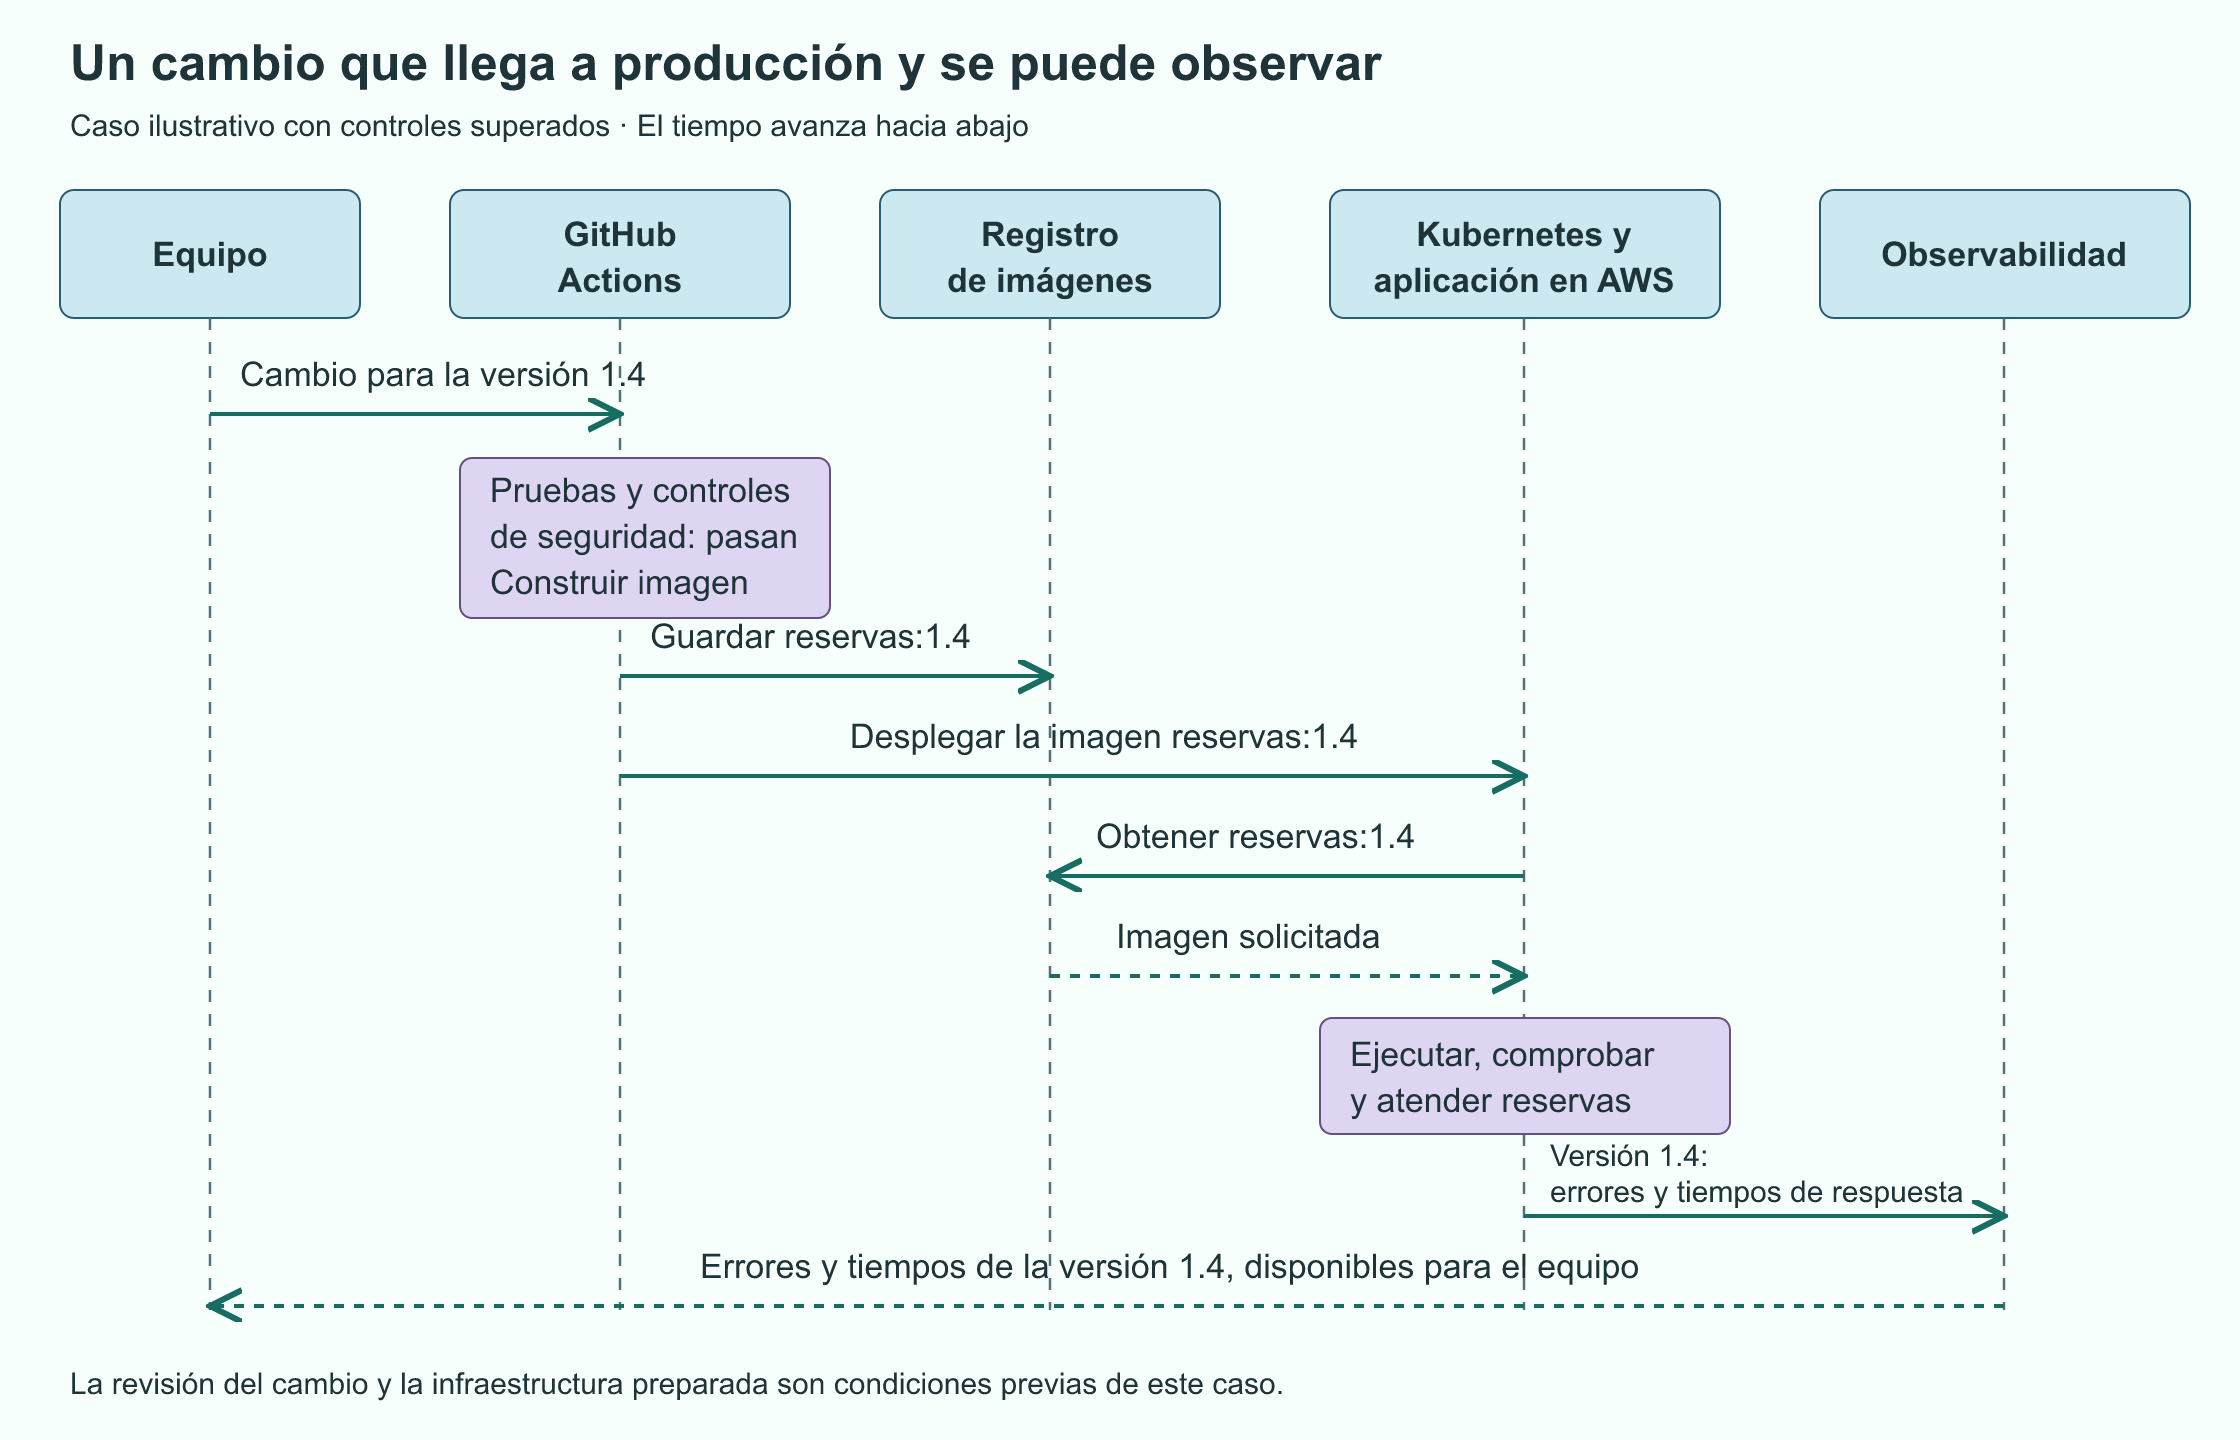
Imagina una aplicación de reservas. Acabamos de corregir un error y queremos desplegar la versión 1.4. Un recorrido posible sería este:
- Proponemos el cambio en GitHub y otra persona lo revisa. GitHub Actions ejecuta las pruebas y los controles de seguridad acordados.
- Si esos controles pasan, construye una imagen con Docker: un paquete con la aplicación y las dependencias necesarias para ejecutarla. La guarda en un registro de imágenes con su identificador.
- El proceso de despliegue indica a Kubernetes que ejecute esa imagen en la infraestructura de AWS. La nueva versión se comprueba antes de recibir tráfico real.
- La aplicación empieza a atender reservas. Registra errores y tiempos de respuesta para comprobar si responde bien y avisar cuando aparece un problema.
La imagen de nuestro ejemplo se llama reservas:1.4. El siguiente diagrama muestra el caso en el que las comprobaciones pasan y el despliegue funciona; el tiempo avanza hacia abajo.
Las herramientas ejecutan partes del trabajo. El equipo sigue decidiendo qué comprobar, qué permisos conceder y qué hacer si el resultado no es aceptable. Un botón de desplegar necesita bastante criterio detrás.
Qué aporta DevSecOps
DevOps acerca el desarrollo y la operación: construir la aplicación y mantenerla disponible forman parte de una responsabilidad compartida. Esto implica colaborar, reducir pasos manuales difíciles de repetir y aprender de los fallos.
DevSecOps hace explícita la integración de la seguridad en ese trabajo. Por ejemplo, al añadir una dependencia revisamos sus riesgos; al preparar el despliegue limitamos sus permisos; al operar el servicio actualizamos componentes y atendemos vulnerabilidades. El marco de desarrollo seguro del NIST recoge prácticas que se integran en el ciclo de desarrollo con ese propósito.
Automatizar ayuda a repetir controles. También hace falta que alguien interprete sus resultados y asuma las decisiones pendientes. Un escáner puede encontrar una vulnerabilidad; corregirla, comprobar la solución y llevarla a producción sigue siendo trabajo del equipo.
Automatizar la entrega: CI/CD
La integración continua, o CI, comprueba los cambios con frecuencia mediante tareas automáticas, como pruebas y análisis del código. Así descubrimos pronto si una modificación rompe una reserva o introduce un problema conocido.
La entrega continua mantiene una versión preparada para desplegar, aunque su paso a producción pueda requerir una aprobación. El despliegue continuo automatiza también ese último paso cuando se cumplen las condiciones acordadas. Ambos aparecen bajo las siglas CD; conviene aclarar cuál estamos aplicando.
GitHub Actions permite definir esas tareas en un workflow. Su secuencia de comprobaciones, construcción y despliegue suele llamarse pipeline. Que termine en verde significa que ha superado los controles configurados; después tendremos que comprobar el comportamiento real del servicio.
Docker, Kubernetes, Terraform y AWS: cada pieza tiene su función
Los nombres suelen aparecer juntos, pero resuelven necesidades distintas:
| Pieza | Qué aporta al ejemplo de las reservas |
|---|---|
| Docker | Construye la imagen de la aplicación. Un contenedor es una ejecución de esa imagen, con su configuración y aislamiento. |
| Kubernetes | Gestiona las instancias de la aplicación: cuántas queremos, cómo actualizarlas y qué hacer cuando alguna deja de estar disponible. |
| Terraform | Describe recursos de infraestructura en archivos versionados y prepara los cambios necesarios para crearlos o modificarlos. |
| AWS | Proporciona servicios de cómputo, red, almacenamiento y otros recursos donde podemos alojar el sistema. |
Podemos utilizar Terraform para preparar una red y un clúster, y Kubernetes para gestionar la aplicación dentro de él. Esta separación sitúa la infraestructura como código de Terraform junto a la gestión de aplicaciones en contenedores de Kubernetes.
La elección depende del problema. Una aplicación pequeña puede funcionar con un contenedor en un servidor y un despliegue sencillo. Kubernetes añade capacidades y trabajo de operación; merece la pena poder explicar por qué lo necesitamos.
Observar lo que ocurre y avisar a tiempo
La observabilidad permite investigar el comportamiento interno del sistema a partir de las señales que produce. Tres señales habituales son los logs, las métricas y las trazas: los logs registran acontecimientos; las métricas resumen cantidades, como errores o tiempos de respuesta; las trazas siguen el recorrido de una petición entre sus operaciones.
En las reservas, una métrica puede revelar que las respuestas se han vuelto lentas. Una traza ayuda a localizar la espera en la base de datos y los logs aportan detalles del fallo. Relacionar esas señales con la versión desplegada facilita la investigación.
Sentry ayuda a investigar errores con su contexto. En una solución con Elastic, un recolector envía los logs, Elasticsearch los almacena e indexa y Kibana permite buscarlos y visualizarlos. Cada herramienta cubre necesidades que debemos configurar y comprobar.
Una alerta convierte una condición relevante en un aviso para alguien que puede actuar. Necesita un criterio, un destinatario y una respuesta prevista. Un gráfico que nadie consulta no va a llamar por teléfono cuando fallen las reservas.
Mantener la seguridad y poder recuperarse
En todo el recorrido debemos proteger credenciales, limitar accesos, revisar dependencias y actualizar imágenes. También hay que decidir qué datos recogemos: un log que incluye una contraseña crea un problema nuevo. En AWS, las responsabilidades de seguridad se reparten entre el proveedor y el cliente según el servicio.
Y necesitamos una salida cuando algo falla. Volver a una imagen anterior puede recuperar una versión defectuosa, pero una migración incompatible de la base de datos exige otro plan. Las copias de seguridad necesitan pruebas de restauración; las alertas, pruebas de que llegan a su destinatario.
Para nuestra aplicación, el trabajo queda bien encaminado cuando podemos identificar la versión en ejecución, explicar cómo llegó hasta allí, detectar que las reservas fallan y recuperar el servicio. Ese recorrido conecta el código con la responsabilidad de mantenerlo funcionando.