Un personaje de un juego encuentra un camino hasta una puerta. Una aplicación agrupa canciones que se parecen. Una cámara localiza piezas defectuosas y un asistente redacta una respuesta. En los cuatro casos alguien puede decir que está utilizando inteligencia artificial, pero sería extraño intentar explicarlos todos hablando únicamente de conversaciones con un modelo.
Para orientarnos conviene separar tres preguntas: qué problema queremos resolver, qué método utilizamos y con qué información trabajamos. No son tres nombres para lo mismo. Son tres perspectivas que permiten entender por qué técnicas muy distintas comparten espacio dentro de la IA.
La tarea va antes que el algoritmo
Imagina una biblioteca que quiere mejorar la atención. Recibe consultas como «¿Podría quedarme el libro una semana más?», necesita organizar los turnos del personal y dispone de fotografías de ejemplares pendientes de catalogar. «Vamos a poner IA» todavía no describe ninguna solución.
Podríamos distinguir estas tareas:
| Necesidad | Entrada | Resultado buscado |
|---|---|---|
| Derivar una consulta | Texto de una persona | Una categoría de atención |
| Organizar turnos | Disponibilidad y requisitos de cobertura | Un horario que cumpla restricciones |
| Catalogar una imagen | Fotografía de una cubierta | Un título candidato o una categoría |
| Preparar una respuesta | Consulta y datos autorizados | Un borrador para la persona que atiende |
Cada fila puede equivocarse de una manera diferente. Un horario puede dejar una franja sin personal; un clasificador puede enviar una consulta al equipo equivocado; una respuesta puede afirmar que un libro está disponible cuando no lo está.
La inteligencia artificial reúne formas de construir sistemas que perciben, razonan, aprenden o actúan para resolver tareas. Es un campo amplio, con fronteras que han cambiado con el tiempo. La utilidad de la etiqueta está en ayudarnos a estudiar esos mecanismos, no en decidir que cualquier programa con un if merece un departamento de investigación.
El índice de Artificial Intelligence: A Modern Approach, de Russell y Norvig, refleja esa amplitud: búsqueda, conocimiento, incertidumbre, aprendizaje, lenguaje, percepción y acción. Un modelo de lenguaje ocupa una parte del mapa.
Buscar una solución sin aprender de ejemplos
Supongamos que un carrito debe recoger libros en tres salas y volver al mostrador. Podemos representar cada situación con su ubicación y los libros que lleva. Una acción cambia de sala o recoge un libro; un objetivo indica cuándo ha terminado.
La búsqueda explora esas posibilidades. En lugar de adivinar una ruta, el sistema mantiene alternativas y decide cuál examinar después. Si importa el tiempo total, cada desplazamiento tendrá un coste. Una ruta con menos puertas puede ser más lenta si obliga a cruzar un pasillo largo.
Una heurística es una estimación que orienta la exploración. La distancia en línea recta puede servir para estimar lo que falta hasta un destino, aunque no explique las paredes que habrá por medio. A* combina el coste ya recorrido con una estimación del coste restante; sus garantías dependen de las propiedades de esa estimación y de cómo se gestione la búsqueda.
Nada de esto exige entrenar una red neuronal. Podemos escribir la representación, las acciones y la estimación a partir del conocimiento del problema. Si cambiamos el plano, la búsqueda debe trabajar con el plano nuevo; no necesita «recordar» todos los recorridos anteriores.
La planificación se ocupa de construir secuencias de acciones con requisitos y efectos. Para trasladar una caja quizá debamos localizarla, disponer de un carrito y abrir antes una puerta. Importa qué tiene que ser cierto para actuar y qué cambia después.
Representar conocimiento y obtener conclusiones
Otro problema sería decidir qué material necesita autorización especial. Podemos expresar hechos y reglas: los ejemplares de una colección son de consulta en sala; un libro pertenece a esa colección; por tanto, ese libro es de consulta en sala.
Un sistema de representación del conocimiento necesita una forma de expresar esos hechos y relaciones. Un mecanismo de inferencia utiliza lo representado para obtener conclusiones. La diferencia se parece a la que hay entre escribir las reglas de un juego y ejecutar un motor que comprueba qué movimientos permiten.
También podemos aprender reglas. En lugar de escribirlas todas, proporcionamos ejemplos y buscamos una definición que los explique. FOIL es un ejemplo de aprendizaje simbólico a partir de relaciones: trabaja con definiciones lógicas, no con la idea de que aprender siempre consiste en ajustar una red. El trabajo original de Quinlan desarrolla ese planteamiento.
Aquí hay una distinción útil: utilizar una regla y aprender una regla son operaciones diferentes. Un sistema puede ejecutar durante años un conjunto de reglas sin modificarlas. Otro puede inducirlas a partir de datos y después utilizarlas para clasificar casos nuevos.
Aprender a partir de datos
Volvamos a las consultas. Podemos intentar reconocer renovaciones buscando la palabra «renovar», pero alguien escribirá «¿me lo puedo quedar hasta el martes?». Mantener todas las formas de decir lo mismo puede resultar difícil.
En aprendizaje automático ajustamos un modelo utilizando datos y un objetivo. Un modelo es el mecanismo que transforma entradas en resultados; sus parámetros determinan parte de ese comportamiento. Entrenar significa modificar esos parámetros siguiendo un procedimiento, de manera que mejore un criterio sobre los ejemplos disponibles.
Un ejemplo numérico sencillo ayuda. Estimamos minutos de preparación con esta regla:
estimatedMinutes = baseMinutes + minutesPerBook * bookCount
Si baseMinutes vale 4 y minutesPerBook vale 2, preparar tres libros produce 4 + 2 × 3 = 10 minutos. Esos dos valores son parámetros. Elegirlos a mano construye un estimador; ajustarlos mediante tiempos observados sería un proceso de aprendizaje. El ejemplo explica la operación, no aporta datos reales de ninguna biblioteca.
Después utilizamos el modelo con una entrada nueva. Eso es inferencia. Calcular diez minutos no modifica automáticamente los parámetros. Recibir una corrección tampoco produce por sí solo un modelo mejor: hace falta un proceso que incorpore esa información y compruebe el resultado del cambio.
La señal disponible da lugar a distintas formas de aprendizaje:
- Supervisado: tenemos ejemplos con una respuesta de referencia, como consultas etiquetadas como renovación o información general.
- No supervisado: buscamos estructura sin esas etiquetas de la tarea, por ejemplo grupos de préstamos con patrones semejantes.
- Semisupervisado: combinamos una parte etiquetada y otra sin etiquetar para aprovechar ambas.
- Autosupervisado: construimos objetivos a partir de los propios datos, como ocultar parte de un texto y aprender a predecirla. No significa aprender sin objetivo.
- Por refuerzo: un sistema actúa en un entorno y aprende a partir de recompensas y consecuencias a lo largo del tiempo.
No son cinco niveles de dificultad ni cinco etapas obligatorias. Describen condiciones distintas del aprendizaje. Elegimos según la tarea, la información disponible y lo que podremos comprobar después.
Minería de datos: del conjunto de datos a una conclusión
Si analizamos préstamos históricos para descubrir patrones de uso, entramos en minería de datos. El recorrido incluye formular una pregunta, comprender los registros, preparar la información, aplicar técnicas y contrastar los hallazgos.
Podríamos encontrar grupos de lectores con usos parecidos, asociaciones entre tipos de libros o registros anómalos. Parte de las técnicas procede del aprendizaje automático; otras son estadísticas o reglas de exploración. El trabajo no termina al obtener un gráfico con tres grupos de colores.
Por ejemplo, que dos libros se presten juntos no demuestra que recomendar uno cause la lectura del otro. Quizá ambos sean obligatorios en la misma asignatura. Para interpretar un patrón necesitamos conocer cómo se recogieron los datos y qué alternativas podrían explicarlo.
Optimizar también es explorar
Organizar turnos puede exigir que cada franja tenga cobertura, que nadie esté en dos puestos a la vez y que se respeten disponibilidades. Hay muchas combinaciones y unas satisfacen mejor los objetivos que otras.
Los métodos de optimización buscan soluciones de buena calidad según una función objetivo. Una búsqueda local parte de una solución y prueba modificaciones. Los algoritmos evolutivos mantienen una población de candidatas, seleccionan algunas y producen variaciones mediante operadores como cruce y mutación.
Imagina que cada candidata es un horario. Su evaluación penaliza franjas descubiertas y conflictos. Combinar dos horarios no garantiza producir uno válido: la representación y los operadores deben conservar restricciones o permitir detectarlas y corregirlas.
Estos métodos pueden ajustar parámetros de un modelo, pero también resolver horarios sin aprender de ejemplos. «Evolutivo» describe una familia de mecanismos de búsqueda; no convierte cualquier uso en aprendizaje automático.
Redes neuronales y áreas de aplicación
Las redes neuronales componen transformaciones parametrizadas. Durante el entrenamiento se ajustan sus pesos para mejorar un objetivo. El aprendizaje profundo utiliza redes con múltiples capas que pueden aprender representaciones útiles. Sigue perteneciendo al aprendizaje automático.
En cambio, visión artificial, procesamiento del lenguaje, voz y robótica describen áreas de trabajo. Una cámara puede localizar una cubierta mediante características diseñadas a mano o utilizar una red entrenada. Una aplicación de lenguaje puede trabajar con reglas, conteos de palabras o un modelo generativo.
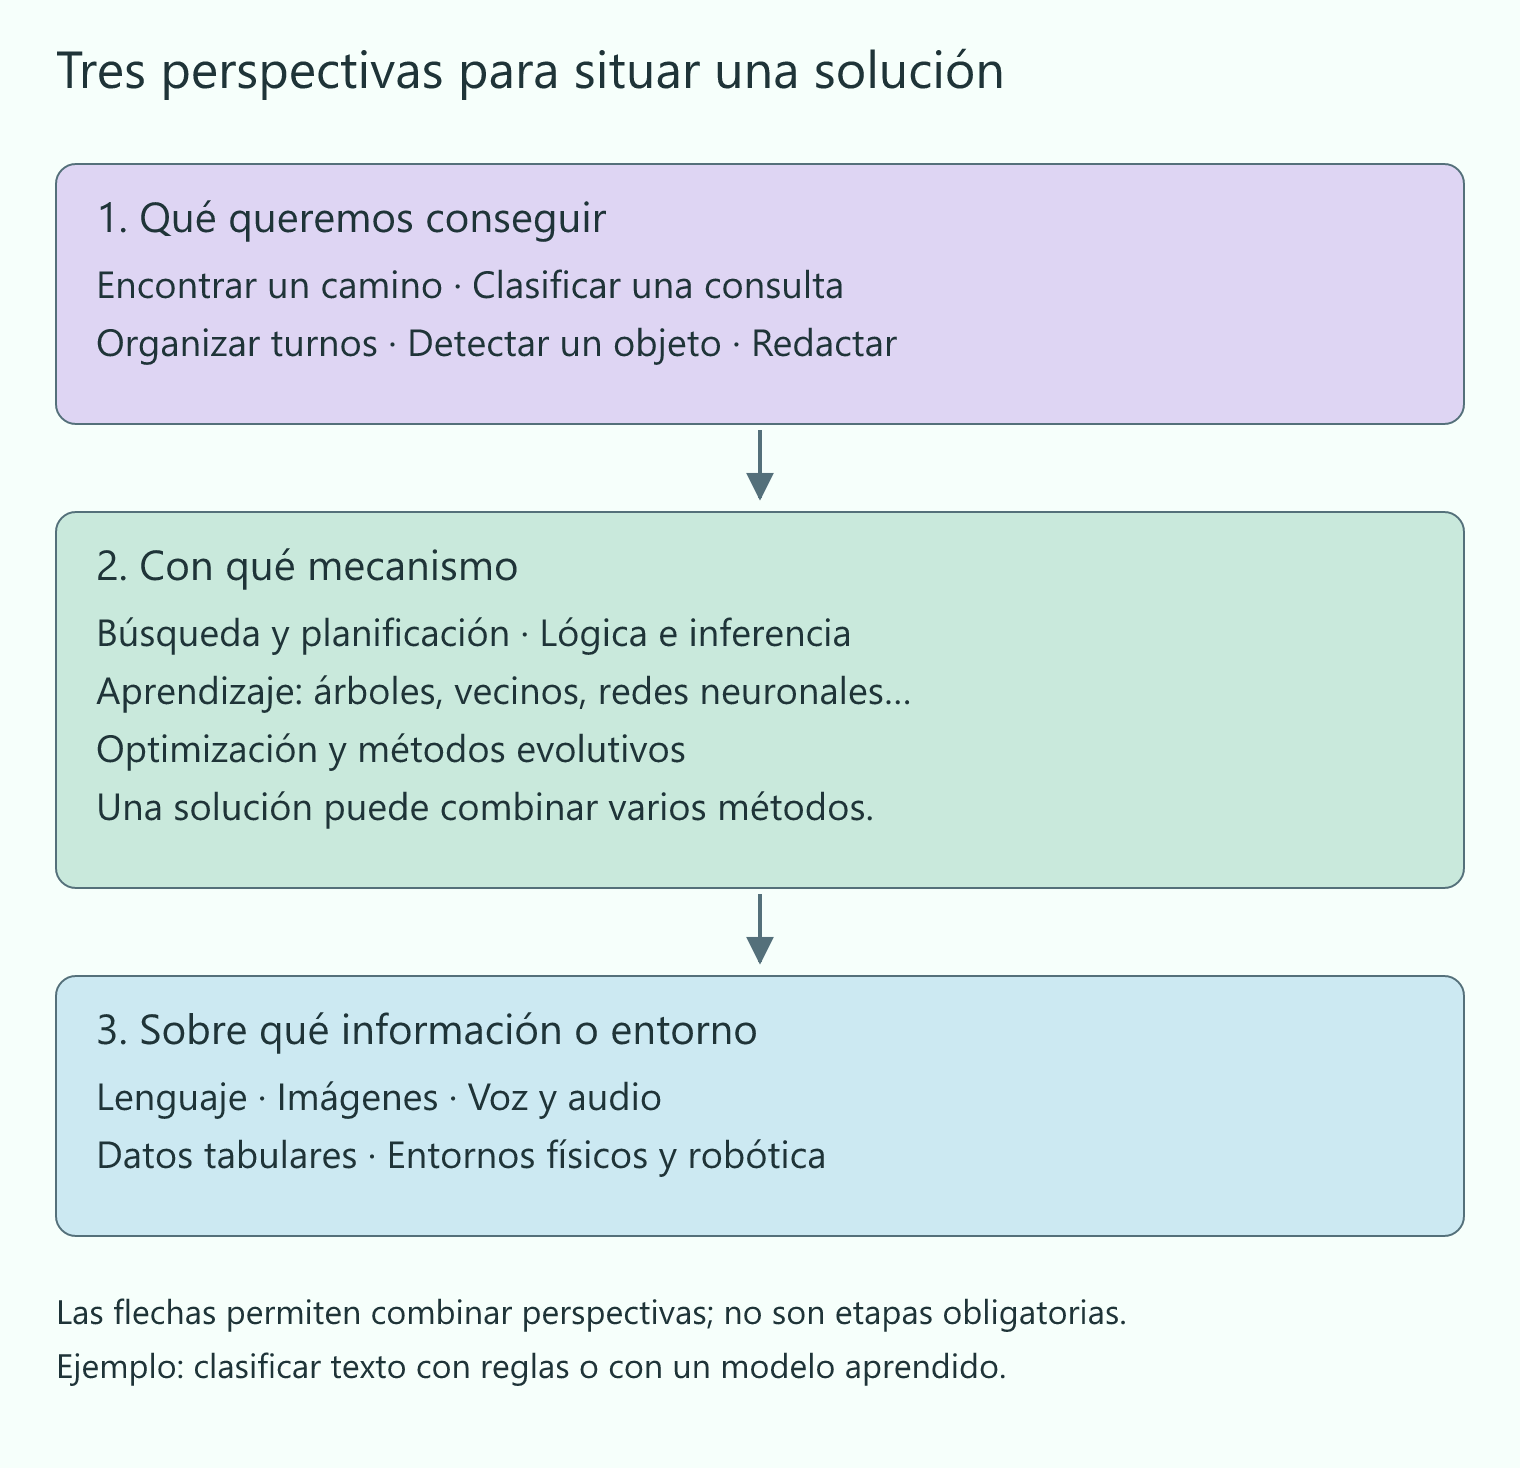
El diagrama se lee de arriba abajo: tarea, mecanismo y área. Las flechas muestran combinaciones posibles, no una clasificación exclusiva ni etapas que deban ejecutarse en ese orden. Las redes aparecen dentro del aprendizaje; visión y lenguaje pueden utilizar varias familias de métodos.
Qué hace un modelo de lenguaje
Un LLM, o modelo de lenguaje de gran tamaño, procesa una entrada y genera una continuación utilizando patrones aprendidos durante su entrenamiento. Trabaja con tokens, unidades en las que se representa el texto: un token puede corresponder a una palabra, a parte de ella o a otros signos. No podemos contar siempre una palabra como un token.
El contexto es la información que recibe en esa ejecución: instrucciones, mensaje, ejemplos, conversación seleccionada o documentos. Su capacidad es limitada. Añadir una política de préstamos al contexto puede cambiar la respuesta sin modificar los parámetros del modelo.
Supongamos que pedimos redactar una contestación sobre un préstamo. El modelo puede producir una frase fluida, pero esa fluidez no demuestra que haya consultado el catálogo ni que conozca la fecha real de devolución. Una aplicación debe obtener esos datos, controlar quién puede verlos y decidir qué operaciones permite. Generar texto y disponer de autoridad sobre el catálogo son responsabilidades distintas.
Tampoco conviene confundir comportamiento útil con conciencia o comprensión humana. Podemos evaluar si un sistema clasifica bien o sigue una instrucción sin resolver con ello todas las preguntas sobre cómo se relaciona con la inteligencia humana.
Elegir empieza por poder comprobar
Antes de escoger un método, escribiríamos algo así: «Con el texto de una consulta, queremos sugerir un equipo de atención y dejar los casos ambiguos para revisión». Ya tenemos entrada, resultado y uso.
Podemos comparar una regla sencilla y un modelo sobre las mismas consultas revisadas. Si de cien mensajes ochenta son generales, responder siempre «general» acierta el 80 %, pero no identifica ninguna renovación. Esa referencia muestra por qué un porcentaje aislado dice tan poco.
Los ejemplos utilizados para ajustar una solución no bastan para evaluar cómo generaliza. Necesitamos casos reservados y pertinentes para el uso; la separación de datos de entrenamiento, validación y prueba ayuda a evitar que confundamos mejorar sobre lo conocido con funcionar mejor ante casos nuevos.
También importa el resultado completo: errores, espera, recursos y capacidad de corregir. Una consulta bien clasificada que tarda varios minutos puede empeorar la atención. La formulación de problemas de Google distingue precisamente el objetivo del producto de la salida del modelo.
La próxima vez que aparezca «necesitamos IA», podemos desplegar el mapa sobre la mesa: qué información tenemos, qué queremos obtener, qué método podría servir y cómo reconoceremos una mejora. Elegir una técnica después de responder eso suele ahorrar bastantes dependencias y alguna reunión.