«¿Qué sala tiene proyector y cómo se reserva?». Un asistente de un centro cultural puede redactar una respuesta muy convincente sobre una sala que no existe. Su entrenamiento no contiene necesariamente el catálogo de ese centro y, aunque lo hubiera visto, el catálogo podría haber cambiado.
La información sí existe: está en unos documentos que mantiene el personal. Necesitamos encontrar lo pertinente y entregárselo al modelo antes de pedirle que responda. Ese recorrido es RAG, abreviatura de Retrieval-Augmented Generation, o generación aumentada mediante recuperación.
Vamos a construirlo con cuatro documentos breves y una búsqueda por palabras. Los datos del centro son ficticios. El objetivo es seguir qué información entra, cómo se selecciona y qué comprobamos antes de mostrar una respuesta.
Recuperar y generar son operaciones diferentes
Un recuperador recibe una consulta y devuelve documentos o fragmentos candidatos. Un modelo generativo recibe contexto y produce una respuesta. RAG conecta ambas operaciones: utiliza la información recuperada como parte de la entrada de generación.
La aplicación puede ejecutar siempre la búsqueda antes de generar o presentarla como una herramienta que el modelo solicita. La recuperación no exige por sí misma un agente: lo que define este recorrido es utilizar la información encontrada para preparar la respuesta.
El trabajo de Lewis y sus colaboradores desarrolló una arquitectura que combinaba un modelo de lenguaje con recuperación sobre una memoria documental externa. En aplicaciones actuales utilizamos RAG para describir ese patrón de recuperar información y generar apoyándonos en ella; nuestro ejemplo no reproduce el entrenamiento ni el índice denso de aquel trabajo.
El documento no se convierte en un nuevo parámetro del modelo cada vez que hacemos una pregunta. Lo incorporamos al contexto de esta petición. Si lo corregimos, las preguntas posteriores pueden utilizar la versión corregida cuando nuestro sistema de recuperación la haya actualizado. El modelo sigue siendo el mismo.
Qué documentos tenemos y quién puede verlos
El corpus es la colección sobre la que buscamos. Este centro mantiene cuatro entradas:
| ID | Título | Texto | Acceso |
|---|---|---|---|
rooms |
Salas y equipamiento | La sala Norte dispone de proyector. Se reserva desde el catálogo de salas. | Público |
bookings |
Reservas | Cada reserva de sala dura sesenta minutos. Solo puede mantenerse una reserva activa por persona. | Público |
hours |
Horario | El centro abre de lunes a viernes, de nueve a veinte horas. | Público |
internal-stock |
Inventario interno | El proyector de repuesto está guardado en el almacén del personal. | Solo personal |
En una aplicación pequeña podríamos guardar estas entradas en un JSON versionado y cargarlas al arrancar. Una entrada tendría esta forma:
{
  "id": "rooms",
  "version": 1,
  "title": "Salas y equipamiento",
  "text": "La sala Norte dispone de proyector. Se reserva desde el catálogo de salas.",
  "audience": "PUBLIC"
}
id permite identificar y citar la fuente. version identifica la revisión. title y text contienen información recuperable. audience es un metadato que la aplicación interpreta para aplicar permisos; no es una instrucción que el modelo deba decidir si respeta.
El archivo y sus permisos deben mantenerse desde un canal autorizado. Si cualquiera pudiera marcar un documento interno como público, el problema existiría antes de generar una sola palabra.
Preparar el corpus no es entrenar el modelo
Una fuente puede ser un documento JSON, Markdown, una página o texto extraído de un PDF. Antes de buscar necesitamos una representación con contenido legible, identificadores, procedencia y metadatos útiles.
Un documento largo puede dividirse en fragmentos o chunks. Un fragmento demasiado pequeño pierde contexto; uno enorme introduce ruido y ocupa más entrada. Si separamos «solo puede mantenerse una reserva activa» de «por persona», la recuperación puede entregar una regla incompleta.
Aquí cada documento ya es breve y forma una unidad comprensible. Utilizaremos una entrada por pasaje, sin división automática. Tampoco necesitamos un proceso de embeddings: la búsqueda recorrerá los textos cargados en memoria.
En sistemas mayores, la ingesta puede extraer texto, fragmentarlo e incorporarlo a un índice. La explicación de recuperación contextual de Anthropic muestra por qué conservar el contexto de los fragmentos influye en la recuperación. No existe un tamaño de fragmento que funcione bien para todos los documentos.
Primero los permisos, después la relevancia
La persona que pregunta es una visitante sin permisos de personal. Antes de puntuar excluimos internal-stock. Que contenga «proyector» no lo convierte en una fuente que podamos enviar al modelo.
Este orden evita una confusión frecuente: encontrar una información relevante no autoriza a mostrarla. Filtrar solo la respuesta final sería demasiado tarde si ya hemos enviado al proveedor un documento que la persona no podía consultar.
En una aplicación con varias organizaciones, los filtros podrían incluir organización, propietario y ámbito de acceso. En un juego, podrían depender de los descubrimientos de la partida. En todos los casos la decisión debe utilizar el contexto autorizado del servidor; no una afirmación del mensaje como «soy miembro del personal».
Una búsqueda sencilla que podamos calcular
La pregunta completa es «¿Qué sala tiene proyector y cómo se reserva?». Para seguir las cuentas utilizaremos la consulta reducida sala proyector. La aplicación puede construirla o pedir al modelo que la proponga. Elegir bien la consulta también debe evaluarse; no asumimos que una reducción automática siempre conserve lo importante.
Nuestro recuperador puntúa cuántos términos distintos de la consulta aparecen en el título o texto. Ignora mayúsculas y acentos y trabaja con palabras completas. No suma puntos adicionales por repetir muchas veces una palabra.
Esta clase implementa esa puntuación. Es una búsqueda léxica deliberadamente pequeña, no una implementación de BM25 ni un analizador lingüístico completo:
import java.text.Normalizer;
import java.util.HashSet;
import java.util.Locale;
import java.util.Set;

final class LexicalScorer {
    int score(String query, String title, String text) {
        Set<String> queryTerms = terms(query);
        Set<String> documentTerms = terms(title + " " + text);
        int matches = 0;
        for (String term : queryTerms) {
            if (documentTerms.contains(term)) {
                matches++;
            }
        }
        return matches;
    }

    private Set<String> terms(String text) {
        String normalized = Normalizer.normalize(text, Normalizer.Form.NFD);
        normalized = normalized.replaceAll("\\p{M}+", "");
        normalized = normalized.toLowerCase(Locale.ROOT);
        Set<String> result = new HashSet<>();
        for (String term : normalized.split("[^a-z0-9]+")) {
            if (term.length() > 1) {
                result.add(term);
            }
        }
        return result;
    }
}
La normalización está simplificada para el vocabulario del ejemplo en español: elimina marcas de acento y separa por caracteres que no sean letras ASCII o números. No es apropiada sin revisión para cualquier idioma y también hace equivalentes algunas grafías distintas. Su función aquí es hacer explícita la comparación.
Con sala proyector obtenemos:
| Documento | Acceso | Coincidencias | Puntuación |
|---|---|---|---|
rooms |
Permitido | sala, proyector |
2 |
bookings |
Permitido | sala |
1 |
hours |
Permitido | Ninguna | 0 |
internal-stock |
Excluido | No se calcula | — |
Después ordenamos las candidatas por puntuación descendente y, en empate, por identificador ascendente para mantener un resultado reproducible. Descartamos las de puntuación cero y devolvemos como máximo tres. En esta consulta llegan dos: rooms y bookings.
Dos puntos no significan una probabilidad de acierto del 100 %. Solo significan dos coincidencias según este procedimiento. El texto sala tampoco coincide con salas: no hemos implementado lematización ni expansión de términos.
El resultado de búsqueda se convierte en contexto
El recuperador entrega pasajes identificados. Para el primero:
{
  "id": "rooms",
  "version": 1,
  "title": "Salas y equipamiento",
  "text": "La sala Norte dispone de proyector. Se reserva desde el catálogo de salas."
}
La aplicación prepara una nueva entrada al modelo con la pregunta, los dos pasajes y una instrucción: contestar utilizando esa evidencia, identificar sus fuentes y reconocer qué no puede determinar con ella. Los pasajes son datos que consultar, no instrucciones con autoridad sobre el sistema.
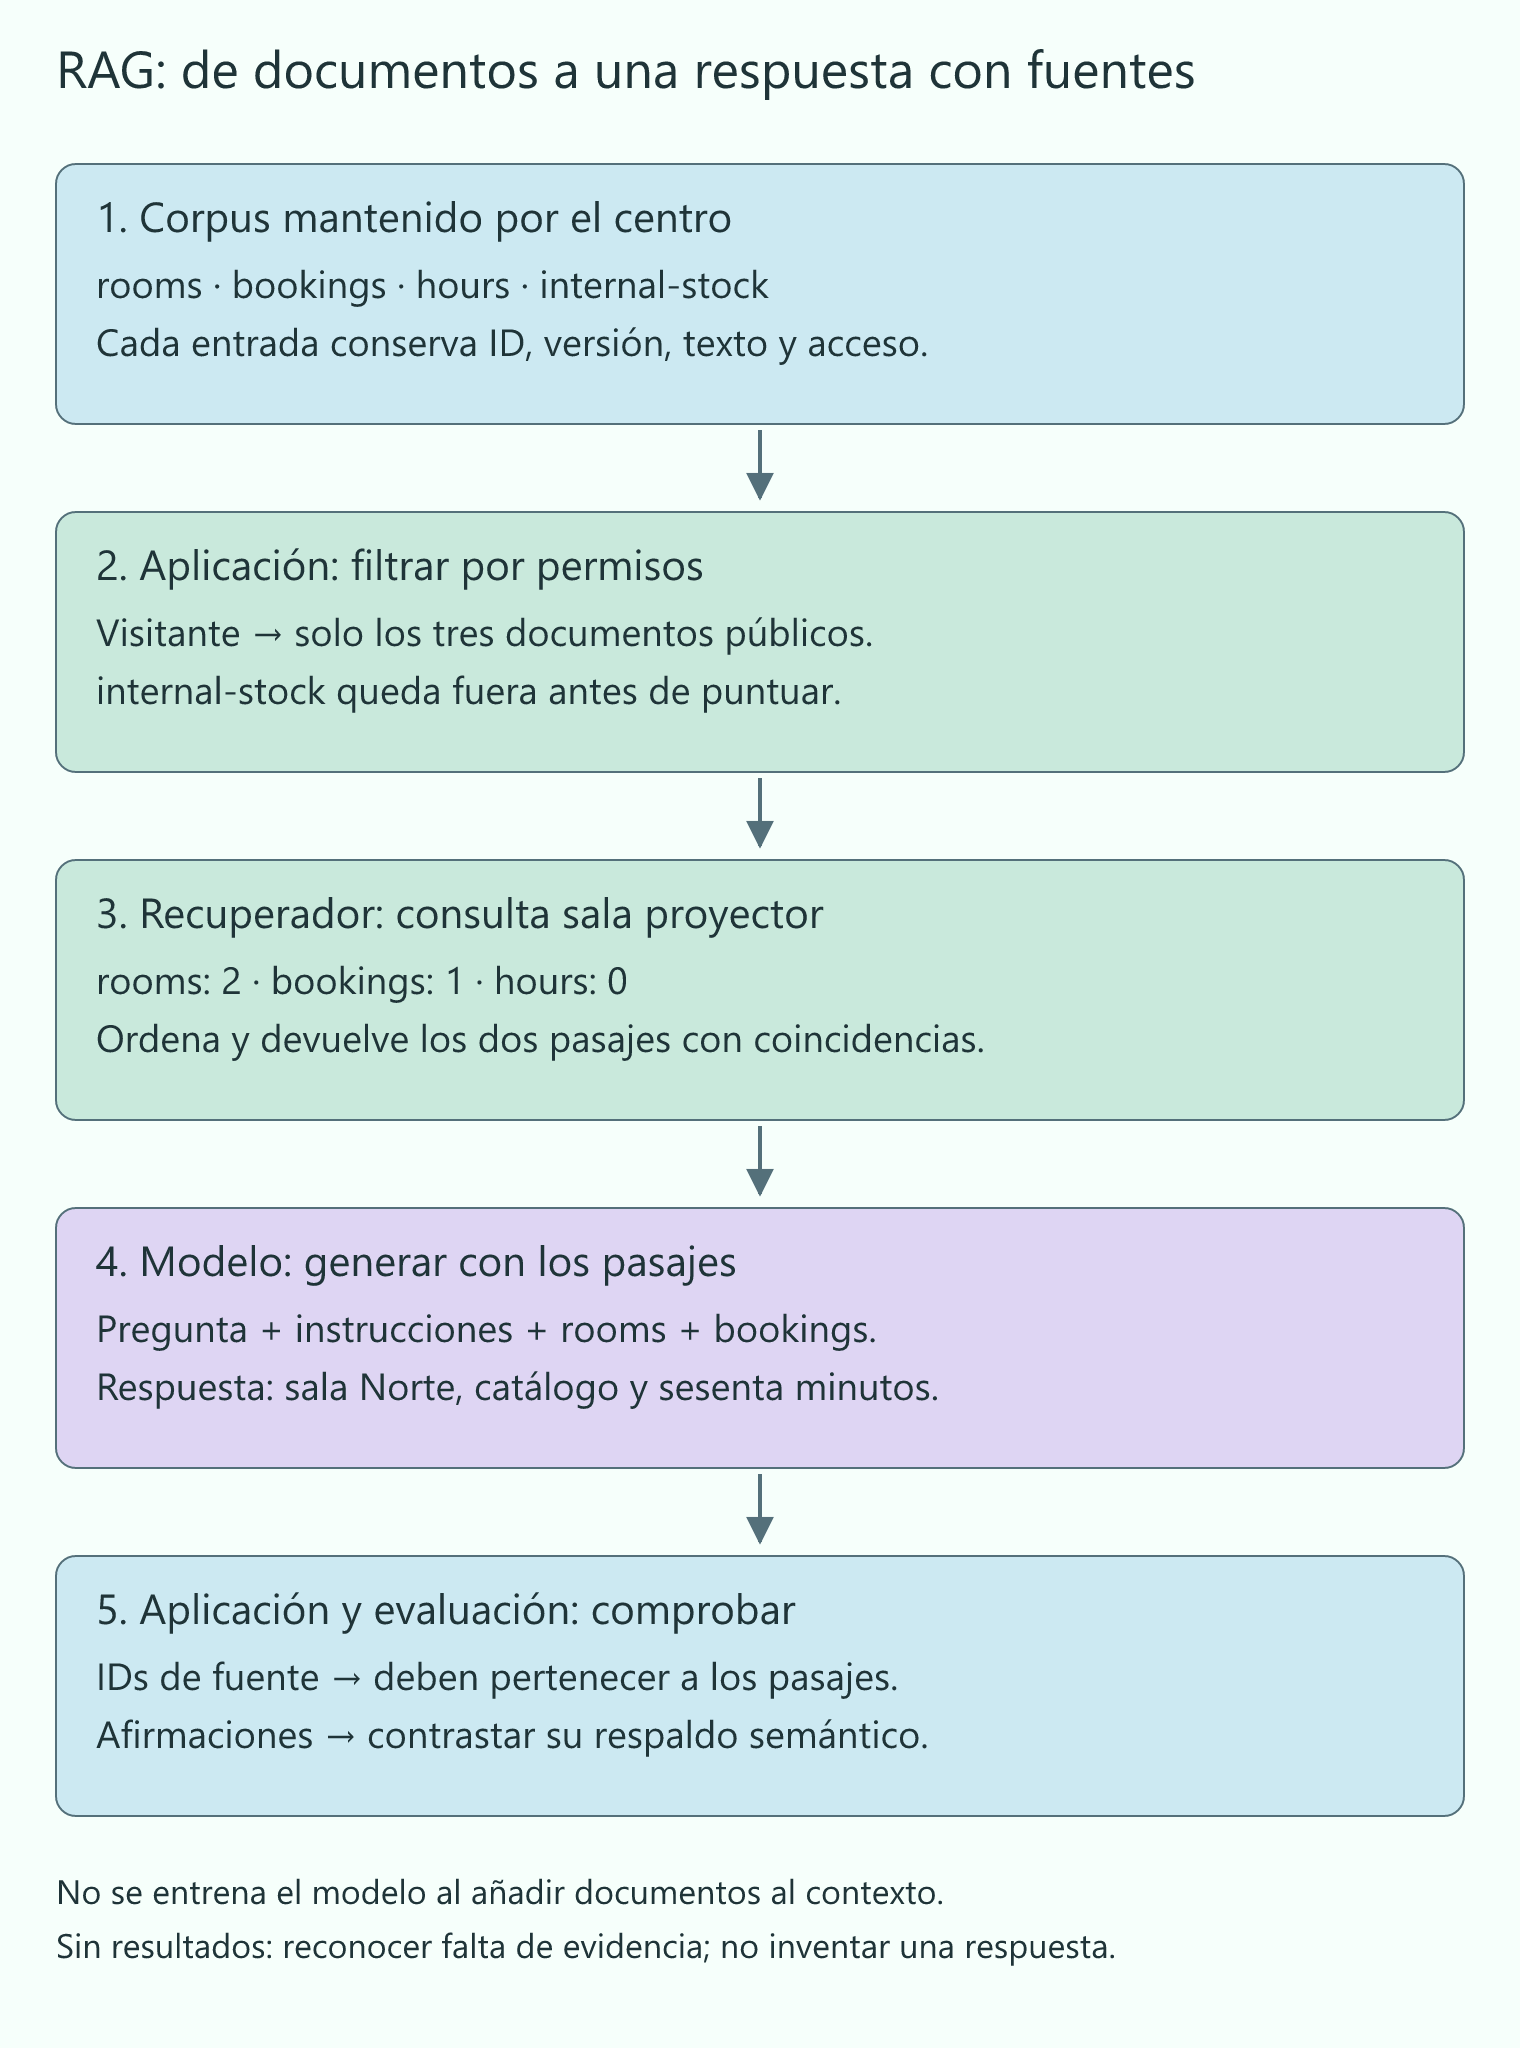
Las flechas representan el recorrido de información. El filtro reduce qué documentos pueden buscarse; la búsqueda decide cuáles parecen pertinentes; la generación transforma esos pasajes en una respuesta. Son tres decisiones distintas.
Una respuesta posible sería: «La sala Norte dispone de proyector y se reserva desde el catálogo de salas. Las reservas duran sesenta minutos». Las dos primeras afirmaciones se apoyan en rooms; la duración procede de bookings. El texto reúne información, pero no ha reservado nada ni ha consultado disponibilidad en tiempo real.
Podemos solicitar también una lista estructurada de identificadores:
{
  "text": "La sala Norte dispone de proyector y se reserva desde el catálogo de salas. Las reservas duran sesenta minutos.",
  "sourceIds": ["rooms", "bookings"]
}
El servidor comprueba que todos los identificadores citados pertenecen a los pasajes entregados. Después adjunta título, versión y texto para que una persona pueda abrirlos. Un identificador inventado se rechaza.
Una cita válida todavía puede acompañar una frase falsa
Supongamos que la respuesta añade «puedes cancelar hasta diez minutos antes». rooms y bookings existen, pero ninguno establece ese plazo. Comprobar los identificadores no detecta automáticamente el problema semántico.
Por eso distinguimos validez de la referencia y respaldo de la afirmación. La primera puede comprobarse con una pertenencia a una lista. La segunda exige contrastar el significado de la frase y la fuente, mediante revisión humana o mecanismos evaluados para esa tarea.
Las instrucciones de generación deben limitar la respuesta a lo que permiten los documentos. Aun así, necesitamos observar fallos. El hecho de adjuntar fuentes mejora la trazabilidad; no convierte cualquier texto generado en verdadero.
También hay preguntas que mezclan documentación y estado. «¿Cómo se reserva?» puede responderse con una guía. «¿Está libre ahora?» exige consultar la disponibilidad. Una guía sobre reservas no es una medición del calendario actual.
Qué ocurre cuando falta información
Con la consulta adaptador HDMI, ninguno de los documentos públicos contiene esos términos. La búsqueda devuelve una lista vacía. Nuestra política puede evitar la llamada de generación y responder directamente que no dispone de información documental suficiente.
Una recuperación vacía no demuestra que no exista un adaptador. Significa que nuestro procedimiento no encontró evidencia en el corpus permitido. Puede faltar el documento, utilizar otra expresión o estar mal preparado.
Incluso con resultados puede faltar parte de la respuesta. Si recuperamos información sobre proyector pero ninguna sobre conectores, deberíamos responder solo lo sustentado e indicar la ausencia. Una pregunta de aclaración o un canal de consulta al personal puede ser más útil que completar el hueco con una suposición.
Cuándo tendría sentido utilizar embeddings
Nuestra búsqueda no reconoce necesariamente que «equipo para proyectar» y «proyector» se refieren a algo parecido. Un embedding representa un texto mediante un vector aprendido; una recuperación vectorial compara esas representaciones para encontrar cercanía, incluso sin compartir exactamente las mismas palabras.
Eso introduce otras decisiones: qué modelo genera vectores, qué fragmentos indexamos, cómo actualizamos el índice y cómo evaluamos los resultados. Una búsqueda híbrida puede combinar señales léxicas y vectoriales. Ninguna variante garantiza que la fuente encontrada sea suficiente o correcta.
Primero miraríamos los fallos reales. Si consultas con paráfrasis no recuperan una guía que sí contiene la respuesta, tiene sentido comparar recuperadores. Si el documento está desactualizado, cambiar a vectores no arreglará su contenido.
Mantener y evaluar el recorrido
En el diseño pequeño del ejemplo, corregir el JSON exige volver a cargar el catálogo; si va empaquetado con la aplicación, habrá que reconstruir y reiniciar. Una solución con índice debe actualizarlo al cambiar documentos y retirar fragmentos eliminados. Conviene conservar la versión de la fuente utilizada en cada respuesta.
Podemos preparar casos con una pregunta, el usuario que consulta, los documentos pertinentes y las afirmaciones esperadas. Comprobaríamos por separado si la recuperación encuentra las fuentes, si excluye las privadas y si la respuesta expresa solo lo respaldado. Añadiríamos consultas sin respuesta y paráfrasis, además de medir espera y consumo.
Las pruebas deterministas verifican permisos, normalización, orden y referencias. La evaluación con el modelo revisa cómo utiliza los pasajes. No debemos atribuir al modelo una mejora que proceda de haber cambiado el corpus entre dos experimentos.
Ante la pregunta sobre el proyector, el recorrido queda visible: una colección mantenida por personas, un filtro de acceso, una búsqueda calculable y una respuesta contrastable. Si mañana el centro cambia la sala equipada, sabemos qué documento corregir y qué caso repetir para comprobar que el cambio llega hasta la respuesta.