Tienes una oferta guardada en un portal, una entrevista en el calendario y una nota que dice «preguntar por el remoto». Sabes que había una prueba técnica pendiente, pero ya no recuerdas de qué empresa. La búsqueda de empleo empieza a necesitar su propio buscador.
De ahí parte este proyecto: una aplicación para guardar ofertas, registrar las solicitudes enviadas y seguir lo que ocurre después. Un gestor personal, ejecutado en local, con entrevistas, tareas, notas e historial de cada candidatura. Está escrito en Java 25 con Spring Boot, Thymeleaf, JPA y PostgreSQL, y el código está publicado en GitHub: job-application-tracker-hexagonal.
También quería llevar a una aplicación utilizable lo que hemos visto en los diez primeros artículos de la serie, desde qué hay antes de las arquitecturas hasta Arquitectura Hexagonal. Hasta ahora hemos aislado conceptos para entenderlos. En este caso práctico toca juntarlos y asumir sus consecuencias: decidir dónde vive una regla, cuánto separar el código y qué hacer cuando dos operaciones intentan modificar la misma ficha.
El resultado es un monolito con arquitectura hexagonal: un núcleo de reglas y casos de uso, unos contratos que expresan lo que ese núcleo necesita y unos adaptadores para la web y la base de datos. Voy a explicar cómo llegué a esa organización, empezando bastante antes de elegir nombres para los paquetes, y enseñando el código donde se toma cada decisión.
Primero, concretar qué problema estaba resolviendo
La primera restricción era importante: iba a utilizarlo una persona en su ordenador. Necesitaba conservar información entre reinicios, encontrar candidaturas y registrar sus cambios. No necesitaba gestionar empresas clientes, equipos de selección o distintos permisos de usuario.
Eso delimitaba también qué significaba que funcionase bien. Si guardaba una candidatura, debía seguir allí al volver. Si cambiaba su estado, quería conservar el cambio y su explicación juntos. Si editaba una ficha antigua, la aplicación debía avisarme antes de perder información reciente. Y quería poder comprobar las reglas sin arrancar toda la infraestructura.
Estas condiciones permiten valorar decisiones concretas. Un diseño que reparte el código en muchas carpetas, pero pierde una entrevista al guardar desde otra pestaña, sigue incumpliendo una necesidad básica.
La siguiente distinción fue del propio negocio: guardar una oferta no equivale a haber enviado una solicitud. Si mezclaba ambas cosas, el contador de solicitudes ya empezaría mintiendo. Por eso el modelo distingue SAVED de APPLIED y de los estados posteriores del proceso.
Una oferta guardada no tiene fecha de solicitud. Una candidatura enviada sí la necesita. Retirar una oferta que nunca llegué a enviar es un caso válido y puede seguir sin fecha. Las entrevistas y tareas se registran aparte: tres entrevistas no requieren inventar tres estados generales nuevos.
Tampoco impuse un recorrido rígido por todas las fases. Cada empresa organiza su proceso de una manera. Permitir saltos tenía sentido; retroceder, reabrir un proceso cerrado o corregir una fecha existente requería dejar un motivo. Esa flexibilidad seguía teniendo reglas.
Aquí aparece la abstracción del primer artículo: decidir qué información representa el problema y qué queda fuera. La candidatura es el centro porque quiero seguir mi participación en un proceso. Un catálogo independiente de empresas o un motor configurable de selección añadirían problemas que esta versión todavía no necesita resolver.
Cuánta aplicación necesitaba desplegar
Con el alcance definido, elegí un monolito con un ejecutable Spring Boot y un único módulo Maven. La aplicación y PostgreSQL se ejecutan en contenedores distintos, pero eso no convierte el sistema en microservicios: solo hay una aplicación con las operaciones del gestor.
Dividir candidaturas, entrevistas y tareas en servicios habría introducido comunicaciones de red, más procesos y coordinación entre datos que cambian juntos. No tenía equipos que necesitasen desplegar por separado ni necesidades de escalado diferentes que compensasen ese coste.
Una SPA también habría sido una elección posible. Sin embargo, los recorridos previstos eran listados, filtros, fichas y formularios. Spring MVC y Thymeleaf permiten resolverlos desde el mismo proceso. Tras un envío correcto, el servidor redirige a la ficha para que recargar la página no repita el formulario.
El coste aceptado es una interacción basada en navegación y recargas. Si apareciese una interfaz con mucho estado en el navegador o un cliente móvil, habría una razón para revisar la elección. Los casos de uso podrían aprovecharse, pero todavía habría que diseñar el contrato de la API, sus respuestas y su seguridad. Separar responsabilidades no hace gratis ese trabajo futuro.
Es la aplicación de KISS y YAGNI que más condiciona el conjunto: reducir lo que necesito construir y mantener para resolver el uso conocido. La simplicidad se valora siguiendo una operación completa, incluyendo cómo arranca y cómo se guarda, además de mirando sus clases.
La arquitectura elegida: hexagonal, con puertos y adaptadores
La arquitectura hexagonal es el criterio principal del diseño: el núcleo expresa qué hace la aplicación y las conexiones exteriores se adaptan a sus contratos. En este proyecto hay cuatro responsabilidades que conviene distinguir:
- Dominio, en
domain: representa las candidaturas y protege las reglas que hacen válidos sus estados y cambios. - Aplicación, en
application: coordina cada operación y define los contratos que necesita para guardar y delimitar transacciones. - Adaptador web, en
adapter/web: interpreta la petición del navegador y prepara la respuesta. - Adaptador de persistencia, en
adapter/persistence: traduce el núcleo a tablas y ejecuta consultas y escrituras con JPA.
Dominio y aplicación forman el núcleo; los dos adaptadores están fuera. Podemos llamarlas capas, como en el artículo sobre arquitectura en capas, siempre que entendamos «capa» como una responsabilidad y no como un escalón: la web y la persistencia no están una encima de la otra, sino a ambos lados del núcleo.
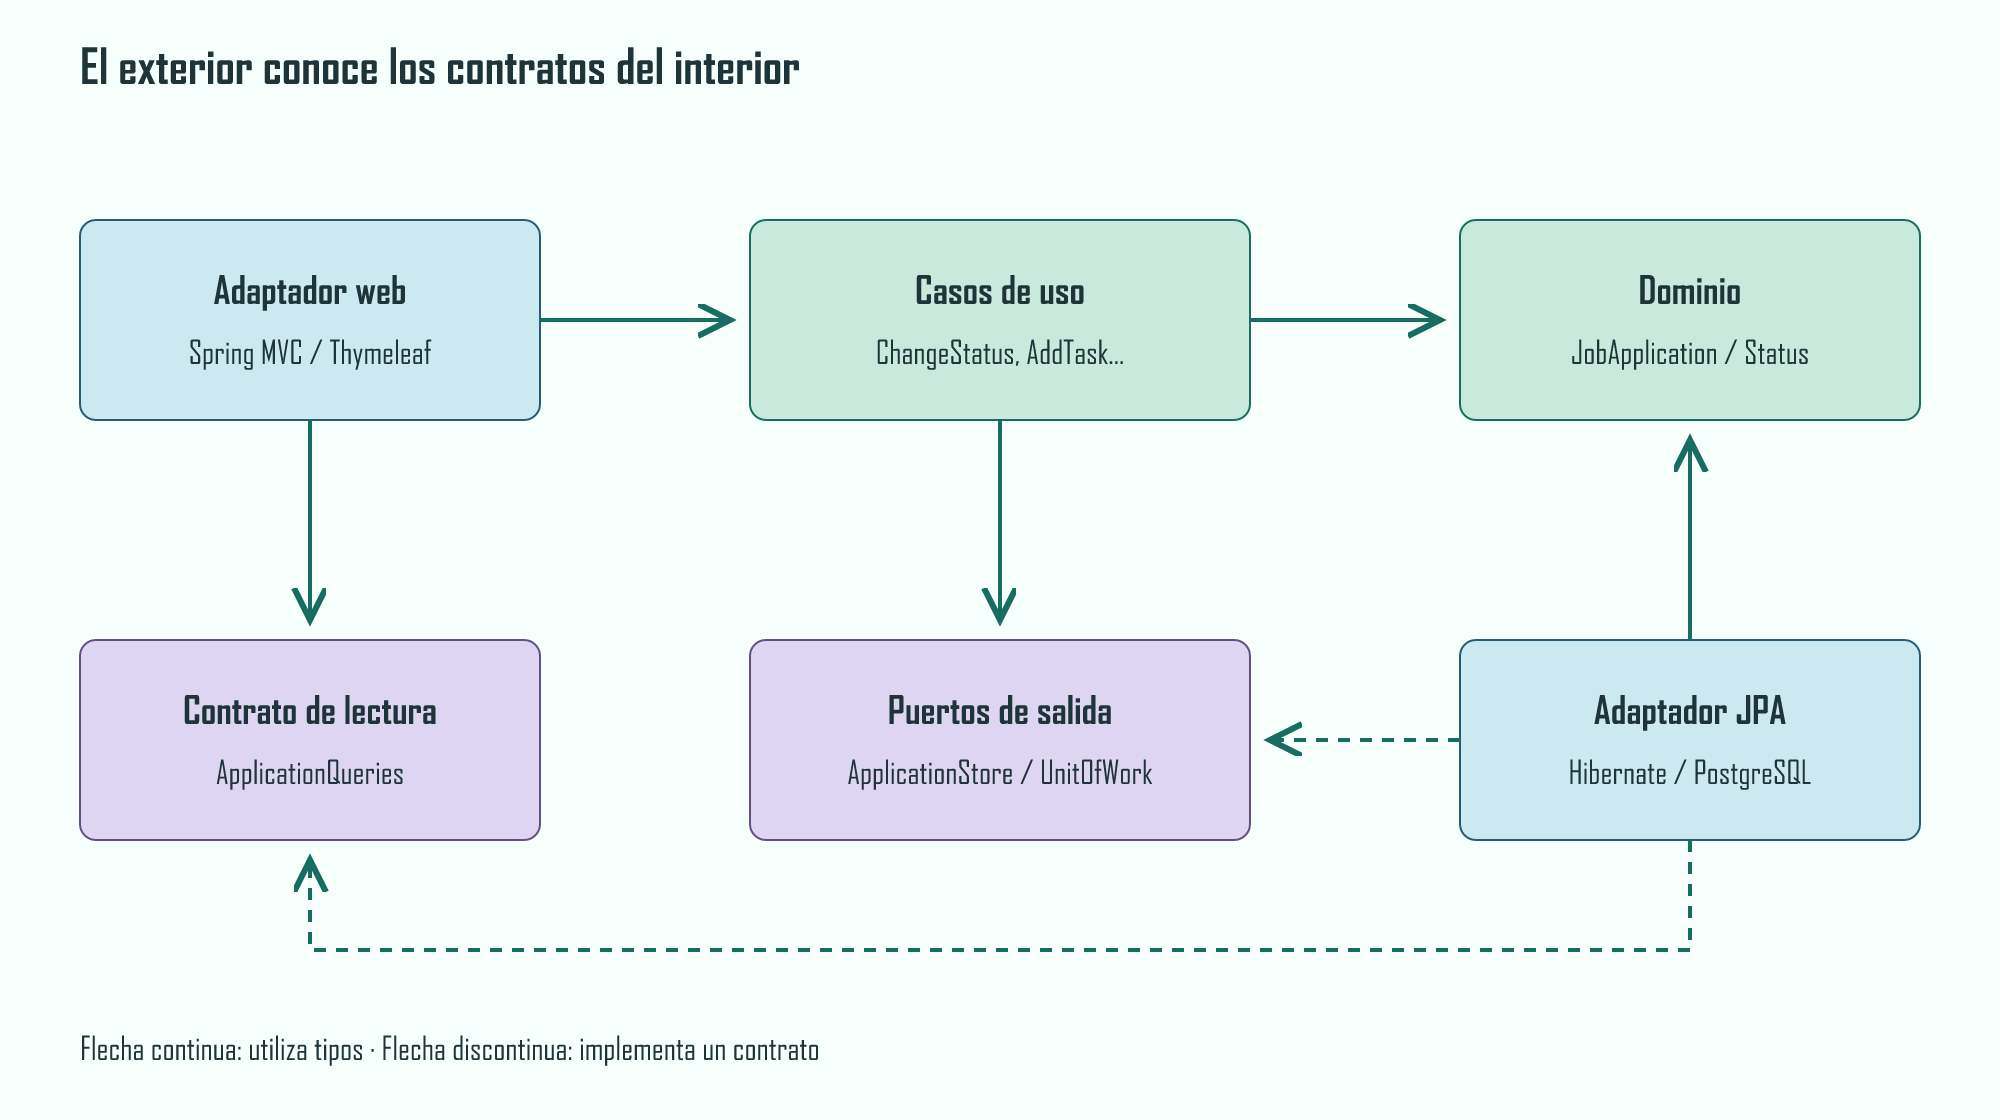
Las flechas continuas significan «utiliza este tipo»; las discontinuas, «implementa este contrato». Durante la ejecución, una llamada a store.save() llega al adaptador JPA, pero en el código del caso de uso solo aparece ApplicationStore. Esa dirección aplica la inversión de dependencias de SOLID: el mecanismo de almacenamiento se adapta a la colaboración que necesita la aplicación.
En el diagrama hay dos tipos de contrato, y la diferencia importa:
- Puertos de salida.
ApplicationStoreyUnitOfWorkson colaboraciones que necesitan los casos de uso: guardar una candidatura y delimitar una transacción. La web no los conoce. - Contrato de lectura.
ApplicationQuerieslo utiliza directamente la web para listados, la ficha y la agenda. Una lectura no aplica reglas de negocio; envolverla en un caso de uso solo añadiría una clase que reenvía la llamada. Lo implementa el adaptador de persistencia con proyecciones propias, así que la web sigue sin ver JPA.
El código se reúne bajo applications, la funcionalidad de gestionar candidaturas. Dentro, los casos de uso se agrupan por la parte del producto que modifican:
applications/
  domain/              JobApplication, Status, StatusChange, Interview...
  application/
    details/           RegisterApplication, EditDetails, ArchiveApplication, RestoreApplication
    status/            ChangeStatus
    activities/        AddNote, AddTask, CompleteTask, ScheduleInterview, RecordInterviewOutcome
    query/             ApplicationQueries
    ApplicationStore   puerto de salida
    UnitOfWork         puerto de salida
    VersionedUpdate    protocolo de versión común
  adapter/
    web/
    persistence/
configuration/         composición de los objetos
Hay un caso de uso por operación. Esta organización toma de los cortes verticales la atención a las operaciones: si quiero cambiar cómo se registra una entrevista, sé dónde mirar, y details, status y activities no dependen entre sí. Pero no lleva el corte hasta el final: los controladores y el adaptador JPA siguen compartidos, porque todavía sirven a varias operaciones y separarlos no aportaría nada.
Esta organización comparte con Clean Architecture la separación entre reglas, casos de uso y detalles externos, y la dirección de las dependencias hacia el interior. Por eso el dominio y la aplicación no importan Spring, HTTP ni JPA. Son enfoques compatibles: aplicar hexagonal ya permite cumplir esos principios.
Dominio: proteger las reglas de la candidatura
Podría haber colocado todas las reglas en un servicio de Spring y utilizado entidades JPA tanto en formularios como en consultas y operaciones. Habría ahorrado clases y traducciones. Para un CRUD pequeño, esa alternativa merece considerarse.
En este proyecto había dos motivos para separar un núcleo: las candidaturas tienen reglas compartidas entre operaciones y quería poder comprobarlas sin servidor ni base de datos. Además, el proyecto debía permitir observar los límites explicados en el blog. Esa intención de aprendizaje también forma parte del contexto y explica por qué acepté algo más de estructura.
JobApplication representa la candidatura. Así decide un cambio de estado:
public JobApplication changeStatus(StatusChange change, Instant now, LocalDate today) {
  checkDate(change.appliedOn(), today);
  if (change.next() == status && Objects.equals(change.appliedOn(), appliedOn)) {
    return this;
  }
  boolean correcting =
      change.kind() == StatusChange.Kind.CORRECTION
          || requiresCorrection(change.next(), change.appliedOn());
  if (correcting && change.reason().isBlank()) {
    throw new RuleViolation("reason");
  }
  var event = correcting ? TimelineEvent.STATUS_CORRECTED : TimelineEvent.STATUS_CHANGED;
  return withStatus(change.next(), change.appliedOn())
      .recorded(TimelineEntry.statusChange(now, event, status, change.next(), change.reason()));
}

private boolean requiresCorrection(Status nextStatus, LocalDate nextDate) {
  boolean revisesExistingDate = appliedOn != null && !Objects.equals(appliedOn, nextDate);
  boolean reversesProgress = nextStatus.progression() < status.progression();
  return status.closed() || reversesProgress || nextStatus == status || revisesExistingDate;
}
Repetir el mismo estado no tiene efecto y devuelve la misma instantánea. Reabrir un proceso cerrado, retroceder o cambiar una fecha ya registrada cuenta como corrección aunque el usuario no lo haya marcado, y exige un motivo. El historial se escribe en la misma operación, de modo que no puede existir un cambio de estado sin su entrada.
Fíjate en la firma. Una primera versión recibía boolean correction, y una llamada como changeStatus(APPLIED, today, "", true, now, today) obligaba a ir a la declaración para saber qué significaba ese true. Es el mismo problema de las banderas que vimos con KISS. StatusChange.update(...) y StatusChange.correction(...) dicen lo mismo con nombre. Por la misma razón, archivar y restaurar son dos operaciones, archive() y restore(), en lugar de archive(boolean).
El dominio decide si el cambio tiene sentido, pero no busca la candidatura ni la guarda. Recibe valores ya interpretados y devuelve el resultado o un RuleViolation. No conoce tablas, sesiones web ni códigos HTTP. El instante y la fecha de hoy le llegan como parámetros; el modelo no consulta por su cuenta el reloj del sistema.
El modelo utiliza instantáneas inmutables: una operación devuelve un nuevo valor y conserva el anterior. Las listas se copian para impedir que un consumidor añada actividades desde fuera. Un record por sí solo no vuelve inmutable una lista; esa protección hay que establecerla expresamente.
El record tiene otro límite que conviene reconocer. Java obliga a que su constructor canónico sea público, así que cualquiera podría construir una candidatura con un historial inventado. Ese constructor protege los invariantes de una instantánea (un estado enviado necesita fecha), pero no las transiciones. Lo dejo como vía de reconstrucción para el adaptador de persistencia y una regla de arquitectura impide que lo use nadie más. Las entrevistas y las tareas siguen el mismo criterio: se crean con Interview.schedule(...) y FollowUpTask.pending(...), y solo el dominio puede completarlas.
La validación del formulario conserva su responsabilidad. Puede detectar un campo vacío y mostrar un mensaje cercano al usuario. Las reglas del dominio siguen comprobándose dentro del modelo, porque también deben cumplirse si mañana la operación se invoca desde otra entrada.
Aplicación: coordinar un caso de uso
Cambiar un estado requiere más trabajo que decidir si la transición tiene sentido: hay que cargar la candidatura, comprobar qué versión se está editando, aplicar el cambio y guardarlo.
Ese protocolo es el mismo para las nueve operaciones que modifican una candidatura existente. En una versión anterior estaba escrito dos veces, en dos clases distintas, y las dos tenían que coincidir. Ahora vive en un solo sitio:
public JobApplication apply(UUID id, long version, UnaryOperator<JobApplication> change) {
  return work.required(
      () -> {
        var current = store.find(id).orElseThrow(RecordMissing::new);
        if (current.version() != version) {
          throw new EditConflict();
        }
        var changed = change.apply(current);
        return changed.equals(current) ? current : store.save(changed, version);
      });
}
Y cada caso de uso se reduce a decir qué cambio pide al dominio:
public JobApplication execute(UUID id, long version, StatusChange change) {
  return update.apply(
      id,
      version,
      application -> application.changeStatus(change, clock.instant(), LocalDate.now(clock)));
}
VersionedUpdate abre la unidad de trabajo, carga, rechaza una versión antigua, deja decidir al dominio y guarda. Si el dominio devuelve la misma instantánea, no guarda nada y la versión no avanza. No construye HTML, no interpreta anotaciones JPA y no vuelve a escribir la regla del motivo.
¿Por qué una clase por operación y no un servicio con todos los métodos? Un servicio de diez métodos acaba recibiendo todos los colaboradores de todas las operaciones, y el controlador que lo usa también. Con casos de uso pequeños, cada clase declara exactamente lo que necesita y se prueba sola. A cambio hay más archivos; me parece un coste razonable cuando cada uno cabe en una pantalla. No hay una interfaz por caso de uso: no existe una segunda implementación que la justifique.
Para guardar, el caso de uso depende de este contrato:
public interface ApplicationStore {
  Optional<JobApplication> find(UUID id);

  JobApplication create(JobApplication application);

  JobApplication save(JobApplication application, long expectedVersion);
}
find() expresa una ausencia mediante Optional. create() rechaza una identidad que ya existe. save() exige la versión esperada y devuelve el estado guardado. Como explicamos en dependencias y contratos, esas promesas importan tanto como los tipos: una implementación que aceptase en silencio una versión antigua tendría la firma correcta y el comportamiento equivocado.
Hay una decisión pequeña que no se ve en el contrato. El identificador de una candidatura nueva se genera al abrir el formulario, no al guardarlo. Si el usuario pulsa dos veces «Guardar», las dos peticiones llevan el mismo UUID y la segunda choca con create(), en lugar de crear dos candidaturas iguales.
Estado e historial deben guardarse juntos. El puerto UnitOfWork permite expresar ese límite desde el caso de uso; su implementación con TransactionTemplate se conecta en la configuración. Usar @Transactional directamente en el caso de uso habría sido más breve. Elegí el puerto para mantener la coordinación libre de Spring y poder ejecutarla en las pruebas sin él. El coste es una abstracción adicional, justificada por el límite que quiero conservar.
La configuración de Spring, en configuration, es el punto de composición: construye los casos de uso, el Clock y la unidad de trabajo, y los conecta. Puede depender de Spring; el núcleo que recibe los colaboradores sigue sin hacerlo.
Adaptadores: la web traduce y la persistencia guarda
Adaptador web
La entrada HTTP se reparte en controladores pequeños según la pantalla o la operación: resumen y consultas, alta y edición, estado y actividades. Cada uno recibe rutas y formularios, los convierte a los tipos del núcleo y llama al caso de uso:
@PostMapping("/applications/{id}/status")
String status(@PathVariable UUID id, @Valid @ModelAttribute TrackingForms.StatusForm form) {
  changeStatus.execute(id, form.version(), form.change());
  return Redirects.toDetail(id);
}
El formulario sabe si el usuario marcó «Estoy corrigiendo un estado anterior» y lo traduce a StatusChange.correction(...). No pasan al núcleo HttpServletRequest, BindingResult ni el modelo de Thymeleaf.
Al volver, el adaptador decide si muestra la ficha, devuelve el formulario con errores o redirige. También traduce los fallos: una candidatura ausente termina en 404; una versión antigua o una identidad repetida, en 409; unos datos inválidos o una regla incumplida, en 400. El significado del fallo existe en el núcleo; el código HTTP y el texto que ve el usuario pertenecen a esta entrada.
El controlador no decide reglas de negocio. No construye entrevistas, no decide si una reapertura necesita motivo y no accede a los repositorios JPA. Su única decisión propia es de traducción: las horas de las entrevistas llegan como hora local y se interpretan en la zona horaria configurada. Si el cambio de hora hace que esa hora no exista o se repita, el formulario la rechaza, porque no sabría a qué instante corresponde.
Las lecturas tienen un recorrido más corto. El listado, la ficha y la agenda llaman a ApplicationQueries, que devuelve resúmenes ya preparados. No construyen una candidatura completa para mostrar una fila ni pasan por un caso de uso que solo reenviaría la llamada.
Adaptador de persistencia
JpaApplicationStore implementa el puerto de escritura con Spring Data JPA:
@Override
public JobApplication save(JobApplication application, long expectedVersion) {
  var row = repository.findById(application.id()).orElseThrow(RecordMissing::new);
  if (row.version != expectedVersion) {
    throw new EditConflict();
  }
  row.assign(application);
  repository.flush();
  return row.domain();
}
Carga la fila, comprueba la versión, traduce la instantánea a entidades y fuerza la escritura para que un conflicto aparezca dentro de la transacción. No decide que reabrir exige un motivo y no devuelve vistas. Lo que entrega al núcleo son instantáneas JobApplication, sin entidades gestionadas ni colecciones diferidas de Hibernate.
Separar JobApplication de las entidades obliga a traducir datos. Hay clases para representar filas y colecciones, y código que las convierte en los valores del núcleo. Es trabajo real que acepté para mantener fuera las anotaciones, el ciclo de vida del ORM y sus asociaciones diferidas.
La consecuencia se ve al abrir una ficha. El adaptador carga lo necesario dentro de una transacción de lectura y devuelve una instantánea. La plantilla recibe los datos preparados y no puede disparar una consulta al renderizarse, porque Open Session in View está desactivado.
JpaApplicationQueries implementa las lecturas. El listado consulta solo los campos de la fila principal con una proyección, pagina de veinte en veinte y no carga el historial ni las actividades. La búsqueda escapa % y _ para que se interpreten como texto. La agenda muestra las próximas entrevistas, las que ya pasaron y siguen pendientes de resultado, y las tareas abiertas. Separo así las necesidades de lectura y escritura con una única base de datos, sin colas ni modelos sincronizados.
Tener dos contratos en lugar de uno también es segregación de interfaces: un caso de uso que guarda no tiene por qué conocer cómo se pagina un listado, y la web que lo pagina no tiene por qué poder guardar.
PostgreSQL conserva los datos y Flyway registra cómo evoluciona su esquema; Hibernate solo valida que el mapeo encaje. Los cambios estructurales quedan en migraciones revisables, en lugar de confiar en que el ORM transforme una base con datos personales.
JPA, Hibernate y Spring Data JPA merecen una distinción porque es fácil meterlos en el mismo saco. Jakarta Persistence define la API y el modelo de persistencia; Hibernate los implementa; Spring Data JPA facilita el trabajo con repositorios sobre esa base. Utilizo estándares de Jakarta junto con Spring, sin desplegar una plataforma Jakarta EE completa.
Una reapertura, paso a paso
Imaginemos una candidatura rechazada que vuelve a estar en proceso. El formulario envía el identificador, el estado solicitado, la versión que se mostró al abrir la ficha y el motivo de la reapertura.
- La web recibe.
StatusControllerinterpreta el formulario, construye unStatusChangey llama aChangeStatus. - La aplicación coordina la lectura.
VersionedUpdateabreUnitOfWork, pide la candidatura aApplicationStorey comprueba la versión. El adaptador JPA hace la consulta y devuelve el modelo del dominio. - El dominio decide.
JobApplicationdetecta la reapertura de un proceso cerrado y exige un motivo, aunque el usuario no haya marcado la casilla de corrección. Si falta, rechaza el cambio antes de guardar. Si es válido, devuelve una nueva instantánea con su entrada de historial. - La aplicación pide el guardado.
VersionedUpdateentrega el resultado y la versión esperada aApplicationStore, dentro de la misma unidad de trabajo. - La persistencia escribe. El adaptador traduce el modelo a entidades y fuerza la escritura. La unidad de trabajo confirma al terminar; si algo falla, revierte y el caso de uso no comunica éxito.
- La web responde. Si todo fue bien, redirige a la ficha actualizada. Si hubo un rechazo o un conflicto, lo convierte en la respuesta de error correspondiente.
El orden describe la ejecución. Las dependencias del código siguen el diagrama: la aplicación conoce el puerto, la persistencia lo implementa y el dominio no importa ninguna de las otras partes.
El historial registra hechos que permiten leer la evolución del proceso, con un tipo de evento cerrado para cada uno. No almacena todos los cambios con información suficiente para reconstruir el sistema, como exigiría event sourcing. Tampoco es una auditoría inalterable: los datos de la candidatura se pueden editar. Es importante atribuirle las garantías que realmente tiene.
Dos pestañas bastan para tener concurrencia
Aunque haya un solo usuario, puede abrir la misma ficha en dos pestañas. En una añade una entrevista. En la otra guarda un cambio desde una versión anterior. Si aceptase ambos estados sin comprobarlos, la segunda escritura podría perder información de la primera.
La versión enviada por el formulario permite detectar ese caso. Si la ficha ya ha cambiado, la operación responde con un conflicto de edición, que la web traduce a HTTP 409. Hay que revisar la información vigente antes de reenviar.
Pero comparar la versión al cargar no resuelve toda la carrera. Dos peticiones podrían leer la misma versión antes de que ninguna guardase. Por eso la entidad JPA utiliza @Version: al escribir, el bloqueo optimista comprueba que la versión almacenada siga siendo la esperada. Si otra transacción se adelantó, la segunda falla y se revierte.
El adaptador también marca como modificada la fila principal cuando el cambio afecta únicamente a una colección, por ejemplo al añadir una tarea. Así esa modificación participa en el control de versión de la candidatura. Es un detalle técnico de persistencia, no un dato que deba conocer quien registra la tarea.
Tampoco reintento el guardado automáticamente sobre la ficha nueva. El usuario tomó su decisión viendo otro estado; repetirla podría modificar algo que no había visto.
Hay una diferencia entre ese conflicto y una repetición inocua. Completar una tarea ya completada, trabajando con la versión vigente, no añade otra entrada de historial ni cambia la versión. Reenviar una versión antigua sigue siendo un conflicto. Definir ambos comportamientos evita utilizar «idempotente» como una promesa demasiado amplia.
Convertir las decisiones en comprobaciones
En el artículo sobre calidad, pruebas y observabilidad insistíamos en concretar qué esperamos del sistema. Aquí cada nivel de prueba responde a una pregunta distinta.
Las pruebas del dominio comprueban fechas, motivos de reapertura, transiciones y tareas repetidas, sin Spring. Las de los casos de uso verifican la coordinación, incluido que un fallo del almacenamiento no termine en una respuesta de éxito.
El contrato de almacenamiento se escribe una vez y se ejecuta contra dos implementaciones, una en memoria y otra con PostgreSQL:
@Test
default void staleVersionIsRejected() {
  work()
      .required(
          () -> {
            var application = store().create(saved());
            store().save(application.addNote("First", NOW), 0);
            assertThatThrownBy(() -> store().save(application.addNote("Stale", NOW), 0))
                .isInstanceOf(EditConflict.class);
            return null;
          });
}
Es el principio de sustitución de Liskov convertido en prueba: si la implementación en memoria aceptase una versión antigua y la real la rechazase, las pruebas rápidas estarían describiendo otra aplicación. Las garantías propias de las transacciones y la concurrencia necesitan además pruebas contra la base real.
Por eso no sustituyo PostgreSQL por H2 en integración. Las pruebas de persistencia comprueban las migraciones y las consultas, provocan un fallo para verificar que estado e historial se revierten juntos y enfrentan dos escrituras para comprobar que solo una conserva el cambio. Las pruebas web cubren las respuestas HTTP, el acceso, CSRF y el escape de textos. Y Playwright recorre la aplicación desde el navegador: acceder, guardar una oferta, enviarla, registrar una entrevista, completar una tarea y añadir una nota.
Con ArchUnit verifico además las fronteras. Esta regla impide que la web se salte los casos de uso:
@Test
void webOnlyTalksToUseCasesAndQueries() {
  noClasses()
      .that()
      .resideInAPackage("..adapter.web..")
      .should()
      .dependOnClassesThat()
      .belongToAnyOf(ApplicationStore.class, UnitOfWork.class, VersionedUpdate.class)
      .check(classes);
}
Otras reglas comprueban que el dominio solo depende de Java, que la aplicación no importa frameworks, que la web no ve JPA, que details, status y activities no dependen entre sí y que solo el dominio y la persistencia usan los constructores públicos de las instantáneas. Si un cambio rompe una frontera, la construcción falla.
Qué significa exigir código limpio en este repositorio
Elegí Google Java Style como convención compartida y la aplico con Spotless y google-java-format. Checkstyle comprueba estilo y tamaño de métodos; PMD detecta problemas y limita la complejidad; CPD busca duplicaciones. Las reglas se aplican a producción y tests, y sus infracciones hacen fallar la construcción. El formateo se ejecuta de manera explícita; una comprobación no reescribe el código a escondidas.
Estos controles convierten parte del criterio en reglas repetibles. Todavía hay decisiones que requieren leer el código: si un nombre explica la intención, si una clase reúne responsabilidades coherentes o si una abstracción compensa sus saltos entre archivos. Un método corto puede seguir siendo difícil de entender. Una construcción verde no es un certificado de Clean Code.
También permiten refactorizar conservando el comportamiento. StatusRefactoringTest conserva una condición antigua que enumeraba a mano los estados cerrados y la compara, estado por estado, con la regla centralizada en Status.active(). Primero hice explícita la regla y comprobé sus casos; después cambié su representación sin alterar lo que debía ocurrir.
Hacer que el uso local forme parte del diseño
La aplicación guarda contactos y notas personales, así que el alcance local también afecta a su configuración. Solo publica el puerto web en 127.0.0.1; PostgreSQL no expone un puerto del host. Hay un usuario con contraseña almacenada como hash bcrypt, sesión y protección CSRF, sin registro de cuentas ni un sistema de permisos que nadie va a utilizar todavía.
Los registros conservan un identificador de petición, método, estado y duración. Permiten relacionar un error con una operación sin volcar notas o credenciales. Actuator aporta comprobaciones de salud y métricas. Para este proceso único no he añadido una plataforma de trazas distribuidas.
Docker fija el entorno de ejecución y el Makefile reúne las tareas habituales: construir, arrancar, verificar y hacer copias. El entorno de pruebas tiene su propia base de datos y se retira al terminar. Poder verificar el proyecto sin tocar las candidaturas de uso diario también es una decisión de calidad.
Publicar el código no cambia este alcance. Una versión accesible desde Internet exigiría revisar transporte seguro, cookies, acceso y operación. Esa revisión corresponde a otro contexto de uso, no a abrir un puerto y dar el trabajo por terminado.
Qué principio aplica cada pieza
- 01 · Abstracción y encapsulación.
JobApplicationdecide sus cambios; el constructor solo reconstruye. - 02 · KISS, DRY, YAGNI. Un monolito sin API;
StatusChangeen lugar de banderas; un soloVersionedUpdate. - 03 · Contratos.
ApplicationStore:Optional, versión esperada y conflicto explícito. - 04 · SOLID. Un caso de uso por operación, contrato probado contra dos implementaciones, lectura y escritura separadas, dependencias hacia el núcleo.
- 05 · Calidad y observabilidad. Pruebas por riesgo, análisis estático, registros con ID de petición.
- 06 · Refactorización y decisiones.
StatusRefactoringTesty un registro de decisión (ADR) por cada elección. - 07 · Capas. Dominio, aplicación, web y persistencia como responsabilidades.
- 08 · Cortes verticales.
details,statusyactivities, independientes entre sí. - 09 · Hexagonal. Puertos de salida, contrato de lectura y adaptadores.
- 10 · Clean Architecture. Núcleo sin frameworks y composición en un único punto.
No todo SOLID tiene un ejemplo aquí. No hay ningún punto donde haya creado una extensión para variantes futuras, porque no conozco ninguna: aplicar abierto/cerrado sin variantes reales sería YAGNI al revés. Por la misma razón no hay un generador de identificadores ni interfaces para los casos de uso.
Lo que haría distinto
Algunas decisiones tienen un coste que ya conozco y que he preferido no resolver todavía:
- Las fronteras se comprueban con tests, no con el compilador. Un único módulo Maven es más sencillo de construir, pero una infracción solo aparece al ejecutar ArchUnit. Si el proyecto creciese o lo tocasen varias personas, separaría el núcleo en su propio módulo.
- Las actividades viven dentro de la candidatura. Guardar entrevistas, tareas e historial en la misma unidad simplifica la consistencia, pero cada guardado rehace sus colecciones. Con cientos de actividades por ficha habría que medir y probablemente separar el historial.
- El constructor público del record es una puerta abierta. La regla de ArchUnit la vigila, pero una clase con constructor privado y un método de reconstrucción lo impediría sin necesidad de test, a cambio de perder la concisión del record.
Dejar razones que sirvan para el siguiente cambio
Cada una de las decisiones de este artículo queda registrada en el repositorio como un ADR: contexto, alternativa elegida, alternativas descartadas, costes y qué justificaría revisarla. Aquí ya están todas explicadas; el registro sirve a quien llegue al código sin haber leído esto.
Si aparece el coste de un historial grande, podré medirlo y valorar otro almacenamiento. Si llega un cliente externo, podré diseñar una API sobre operaciones ya delimitadas. Y si la organización del código deja de contener bien los cambios, podré reforzar las fronteras con módulos o redistribuir los paquetes.
Ese es el criterio que quiero conservar al ampliar el gestor: poder seguir una necesidad hasta la regla que la protege, el caso de uso que la coordina y la prueba que demuestra su efecto. Las carpetas, los contratos y las herramientas merecen su sitio mientras ayuden a conseguirlo.
Para practicar
Si quieres comprobar estas decisiones por tu cuenta, estos cuatro ejercicios recorren las partes más importantes:
- Provoca un conflicto. Abre la misma ficha en dos pestañas. Añade una nota en la primera y cambia el estado desde la segunda. Deberías obtener un 409 sin perder la nota. Explica por qué una implementación de
ApplicationStoreque guardase sin comprobar la versión tendría la firma correcta y el comportamiento equivocado. - Rompe una frontera. Haz que
StatusControllerrecibaApplicationStoreen su constructor y ejecuta los tests de arquitectura. Deben fallar. Deshaz el cambio. - Añade una regla en su sitio. Decide que una candidatura archivada no admite cambios de estado. Escribe primero el test en
JobApplicationTesty después la regla enJobApplication. Comprueba que no has necesitado tocar ni el controlador ni el caso de uso. - Argumenta la alternativa. Escribe en media página la decisión contraria a la de este artículo: usar las entidades JPA como modelo en todas las capas. ¿Qué traducciones te ahorras, qué dependencias introduces y qué pruebas cambiarían?
Pruébalo tú. Solo necesitas Git y Docker. Clona el repositorio y, desde su raíz,
make setupcrea las credenciales locales,make uparranca la aplicación enlocalhost:8090ymake testejecuta toda la suite con PostgreSQL y el navegador.