Un pedido se guarda y otro devuelve un error. La aplicación acaba de cambiar, pero todavía no sabemos si ese cambio explica el fallo. Hay que revisar qué ocurrió, localizar el código ejecutado y comprobar qué comportamiento se esperaba. Las pistas están repartidas entre errores, historial de código y documentos.
Queremos encargar ese trabajo a un agente: «Investiga los errores al guardar pedidos». Debe reunir fuentes, proponer una explicación y señalar qué falta por comprobar. Preparará también un borrador de incidencia para GitHub; el desarrollador decidirá si lo aprueba.
Para entender cómo lo hace, utilizaremos dos proyectos: una API de pedidos con un fallo deliberado y una aplicación Java que la investiga. Seguiremos un recorrido ilustrativo con el mismo problema de principio a fin: entrada sin referencia, excepción, código, contrato y diagnóstico. Los mensajes y resultados de ejemplo muestran el mecanismo; el modelo puede elegir otras consultas según lo que encuentre.
Basta con conocer lo básico de Java, HTTP y Git. Aquí explicamos el funcionamiento de los proyectos y sus decisiones. Para ejecutarlos en tu equipo, los README de pedidos y del investigador contienen la preparación de cuentas, configuración y arranque con Docker.
1. Dos aplicaciones con trabajos distintos
orders-incident-demo recibe pedidos y los guarda en PostgreSQL. Aporta la aplicación que vamos a investigar, su código y la documentación del comportamiento esperado. Podemos provocar el fallo aunque el investigador esté apagado.
incident-investigator recibe la pregunta del desarrollador y consulta fuentes sobre pedidos. Conserva preguntas, avances, evidencias y resultados en su propio PostgreSQL. Llamaremos operador al desarrollador que encarga y revisa ese trabajo.
Un modelo de lenguaje, o LLM, propone qué consultar y analiza los resultados. La aplicación Java comprueba las propuestas, ejecuta las operaciones permitidas y guarda lo obtenido. Esa combinación de decisiones del modelo y ejecución controlada forma el agente.
Ambas aplicaciones ofrecen una API HTTP, sin interfaz gráfica. Cada proyecto tiene un Docker Compose que levanta su aplicación y su PostgreSQL:
| Aspecto | Pedidos | Investigador |
|---|---|---|
| Proyecto | orders-incident-demo |
incident-investigator |
| Dirección local | http://127.0.0.1:18091 |
http://127.0.0.1:18092 |
| Petición principal | POST /orders: intentar guardar un pedido. |
POST /investigations: encargar una investigación. |
| Entrada | Datos del pedido. | Una pregunta sobre el problema. |
| Base de datos | Pedidos guardados. | Investigaciones y documentos preparados para búsqueda. |
El investigador estudia los errores registrados, el código y la documentación. No necesita consultar directamente la API ni la base de datos de pedidos. La separación representa una situación habitual: ya existe una aplicación de negocio y añadimos una herramienta para estudiar sus problemas.
2. El caso: un campo opcional que termina en un 500
Cada pedido contiene quantity, la cantidad, y puede incluir customerReference, una referencia del cliente. El contrato de la API —las entradas admitidas y el comportamiento acordado— permite omitir esa referencia. Antes de guardar, la aplicación debe convertir su ausencia en una cadena vacía y eliminar los espacios exteriores cuando hay texto. A esa preparación la llamamos normalización.
Enviamos dos peticiones a pedidos, en el puerto 18091. La cabecera X-Client-Version identifica clientes ficticios: web-2 suele enviar referencia y legacy-1 puede omitirla. Son etiquetas del ejemplo, no usuarios reales.
La primera petición incluye una referencia con espacios:
POST /orders HTTP/1.1
Host: 127.0.0.1:18091
Content-Type: application/json
X-Client-Version: web-2

{"quantity": 1, "customerReference": "  ORDER-1  "}
En la versión defectuosa devuelve 201 Created: guarda el pedido y responde con su identificador y la referencia normalizada a ORDER-1.
La segunda omite el campo opcional:
POST /orders HTTP/1.1
Host: 127.0.0.1:18091
Content-Type: application/json
X-Client-Version: legacy-1

{"quantity": 1}
Debería guardarse también, pero devuelve 500 Internal Server Error con {"error":"ORDER_SAVE_FAILED"}. Falla antes de llegar al guardado.
El cambio que prepara el escenario
El historial conserva una base funcional, 859257a, y un segundo commit, a645c26, que introduce el fallo. Abreviamos sus identificadores; el SHA completo permite localizar exactamente cada revisión del código.
La clase CustomerReference construye el valor normalizado. En su constructor, value contiene el texto de la referencia y puede llegar como null cuando se omite el campo. El cambio sustituye esta instrucción de la base funcional:
value = value == null ? "" : value.strip();
por esta otra:
value = value.strip();
strip() elimina espacios exteriores. Cuando el campo se omite, el valor recibido es null: invocar un método sobre él produce una NullPointerException. La base funcional trataba ese caso; el cambio elimina esa protección.
Así conocemos el fallo para preparar el ejercicio. El agente tendrá que justificar su explicación con las fuentes que consulte. El segundo commit permanece como última versión de main, de modo que al clonar obtenemos el escenario defectuoso y podemos compararlo con el anterior.
3. Las pistas y el recorrido de la investigación
Cada fuente aporta una parte de la explicación:
| Fuente | Qué contiene | Qué queremos averiguar |
|---|---|---|
| Sentry | Errores enviados por pedidos: excepción, pila de llamadas, versión y etiquetas de la petición. También recoge trazas de ejecución. | Qué falló y en qué contexto. |
| GitHub | Código e historial del repositorio de pedidos. | Qué hacía la versión afectada y qué cambió. |
| Documentos de pedidos | Contrato, componentes, decisiones y procedimientos de docs/, copiados desde un commit concreto. |
Qué comportamiento se esperaba y dónde está documentado. |
Sentry agrupa errores en sus propias incidencias. Cuando hablemos de crear una incidencia en GitHub, nos referiremos a otro objeto: el informe de trabajo que redactaremos y aprobaremos al terminar.
Pedidos envía a Sentry una etiqueta de versión como orders-demo@<SHA completo>. El investigador puede usar ese SHA para consultar el código que se ejecutó. Los documentos también conservan su revisión. Por eso, al preparar el entorno, la imagen de pedidos, su etiqueta y la copia documental deben corresponder al commit elegido.
La IA la proporciona Groq, un servicio que ejecuta modelos de lenguaje mediante una API. El investigador le envía la pregunta y la información reunida; recibe propuestas de consulta o de cierre. La coordinación y los permisos pertenecen a nuestra aplicación Java.
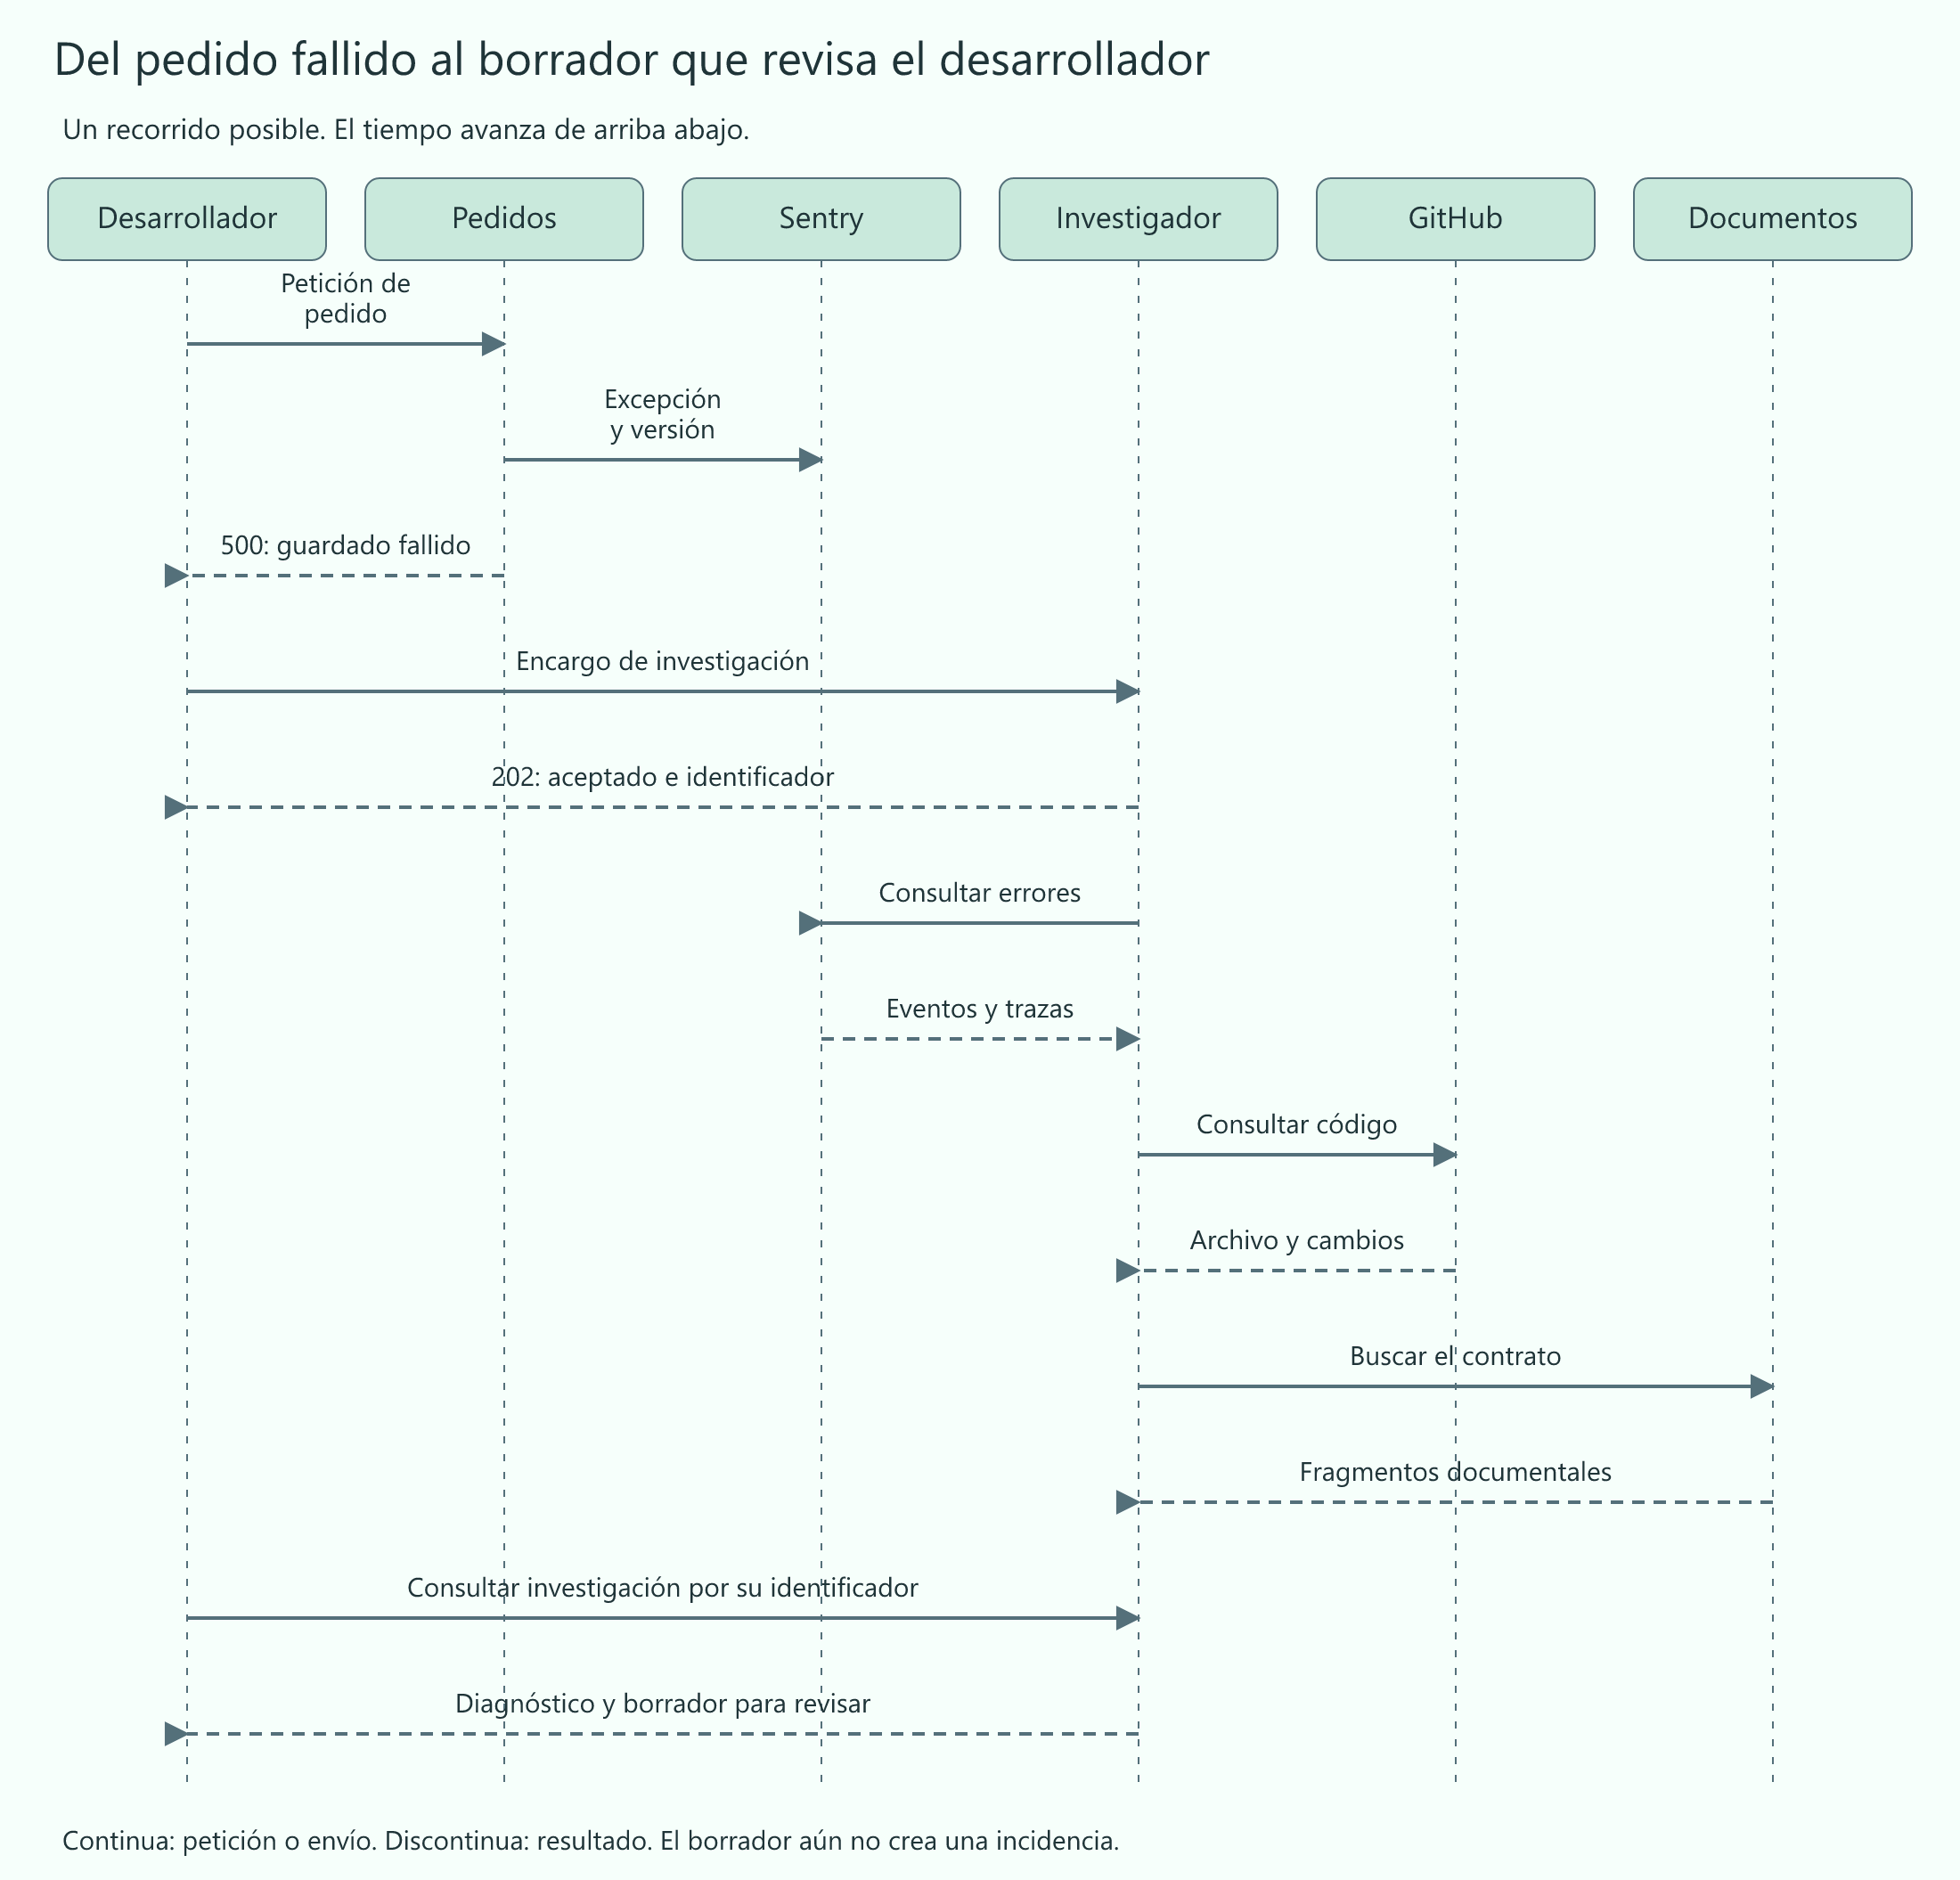
Con esas piezas, el caso avanza así:
- Enviamos el pedido sin referencia. Pedidos devuelve 500 y envía la excepción y la versión a Sentry.
- Encargamos la investigación a la otra API. Guarda la pregunta y devuelve un identificador para consultar sus avances.
- El agente busca errores en Sentry. Una excepción y su versión orientan la consulta del código en GitHub.
- Tras localizar el acceso a
customerReference, busca qué dice la documentación sobre su ausencia. - Relaciona las fuentes, conserva el diagnóstico y prepara un borrador de incidencia en GitHub.
- El operador revisa ese borrador y, si procede, aprueba su creación.
El diagrama muestra el recorrido hasta el borrador. «Pedidos» e «Investigador» son nuestras aplicaciones; «Documentos» es la copia local preparada para búsquedas. El tiempo avanza hacia abajo. Las flechas continuas envían peticiones y las discontinuas devuelven resultados. El 202 confirma que el encargo se ha aceptado y seguirá procesándose después.
El arranque es bajo demanda: un error en Sentry no inicia por sí solo una investigación. La pregunta puede pedir también comparar versiones, estudiar los eventos de legacy-1 y web-2 o comprobar si el fallo ocurre antes de persistir. El repositorio y el proyecto Sentry autorizados se fijan en configuración; la pregunta orienta el análisis dentro de ese ámbito.
4. Encargar el análisis y consultar sus avances
Seguiremos «Investiga los errores al guardar pedidos». La clave projectKey selecciona la configuración autorizada de repositorio, Sentry y documentos; utilizamos orders-demo, el nombre configurado para el taller. El token autentica al operador. Idempotency-Key identifica esta solicitud: repetirla con los mismos datos devuelve la investigación existente; reutilizar la clave con otra entrada se rechaza.
Enviamos la pregunta al investigador, en el puerto 18092:
POST /investigations HTTP/1.1
Host: 127.0.0.1:18092
Authorization: Bearer <operator-token>
Content-Type: application/json
Idempotency-Key: orders-investigation-001

{
  "projectKey": "orders-demo",
  "question": "Investiga los errores al guardar pedidos."
}
Podemos añadir since y until para acotar las fechas. Si se omiten, se investigan las últimas veinticuatro horas. Para generar más datos, pedidos incluye scripts/generate_traffic.py: envía un lote y guarda en reports/traffic.json las respuestas y su ventana temporal. Esas fechas permiten limitar la investigación al lote que hemos preparado.
Java guarda la pregunta en su PostgreSQL con estado QUEUED, «pendiente de empezar». Devuelve 202 Accepted, el identificador de investigación y una cabecera Location con /investigations/{id}. Todavía no hay diagnóstico.
Dentro de la misma aplicación, Spring ejecuta periódicamente JobWorker, una tarea que busca trabajos pendientes. Este worker, o trabajador en segundo plano, reserva la investigación y la cambia a RUNNING, «en ejecución». Después la entrega a Investigator, la clase que coordina el análisis. La reserva evita que dos ejecuciones tomen a la vez el mismo trabajo.
El operador consulta los avances con el identificador recibido:
GET /investigations/{id} HTTP/1.1
Authorization: Bearer <operator-token>
El GET lee lo conservado: estado, consultas y evidencias; al terminar, diagnóstico y borrador. Separar la aceptación del procesamiento permite cerrar la primera petición HTTP mientras continúa el análisis. PostgreSQL conserva también los trabajos pendientes, sin añadir un servicio de colas al montaje.
5. Qué recibe el modelo y qué puede proponer
Investigator, nuestro coordinador, prepara dos cosas para el modelo:
- Contexto: pregunta, repositorio autorizado, intervalo temporal y mensajes de la investigación. En el primer turno aún no contiene resultados de consultas.
- Catálogo de herramientas: operaciones que la aplicación puede ejecutar, con nombre, descripción y esquema de entradas. Una herramienta puede buscar errores, leer un archivo o recuperar documentos.
La aplicación añade un prompt de sistema, las instrucciones comunes: investigar en español, separar hechos e hipótesis, citar fuentes y reconocer lo desconocido. Los documentos y resultados externos se tratan como datos; una frase dentro de ellos no puede conceder permisos al agente.
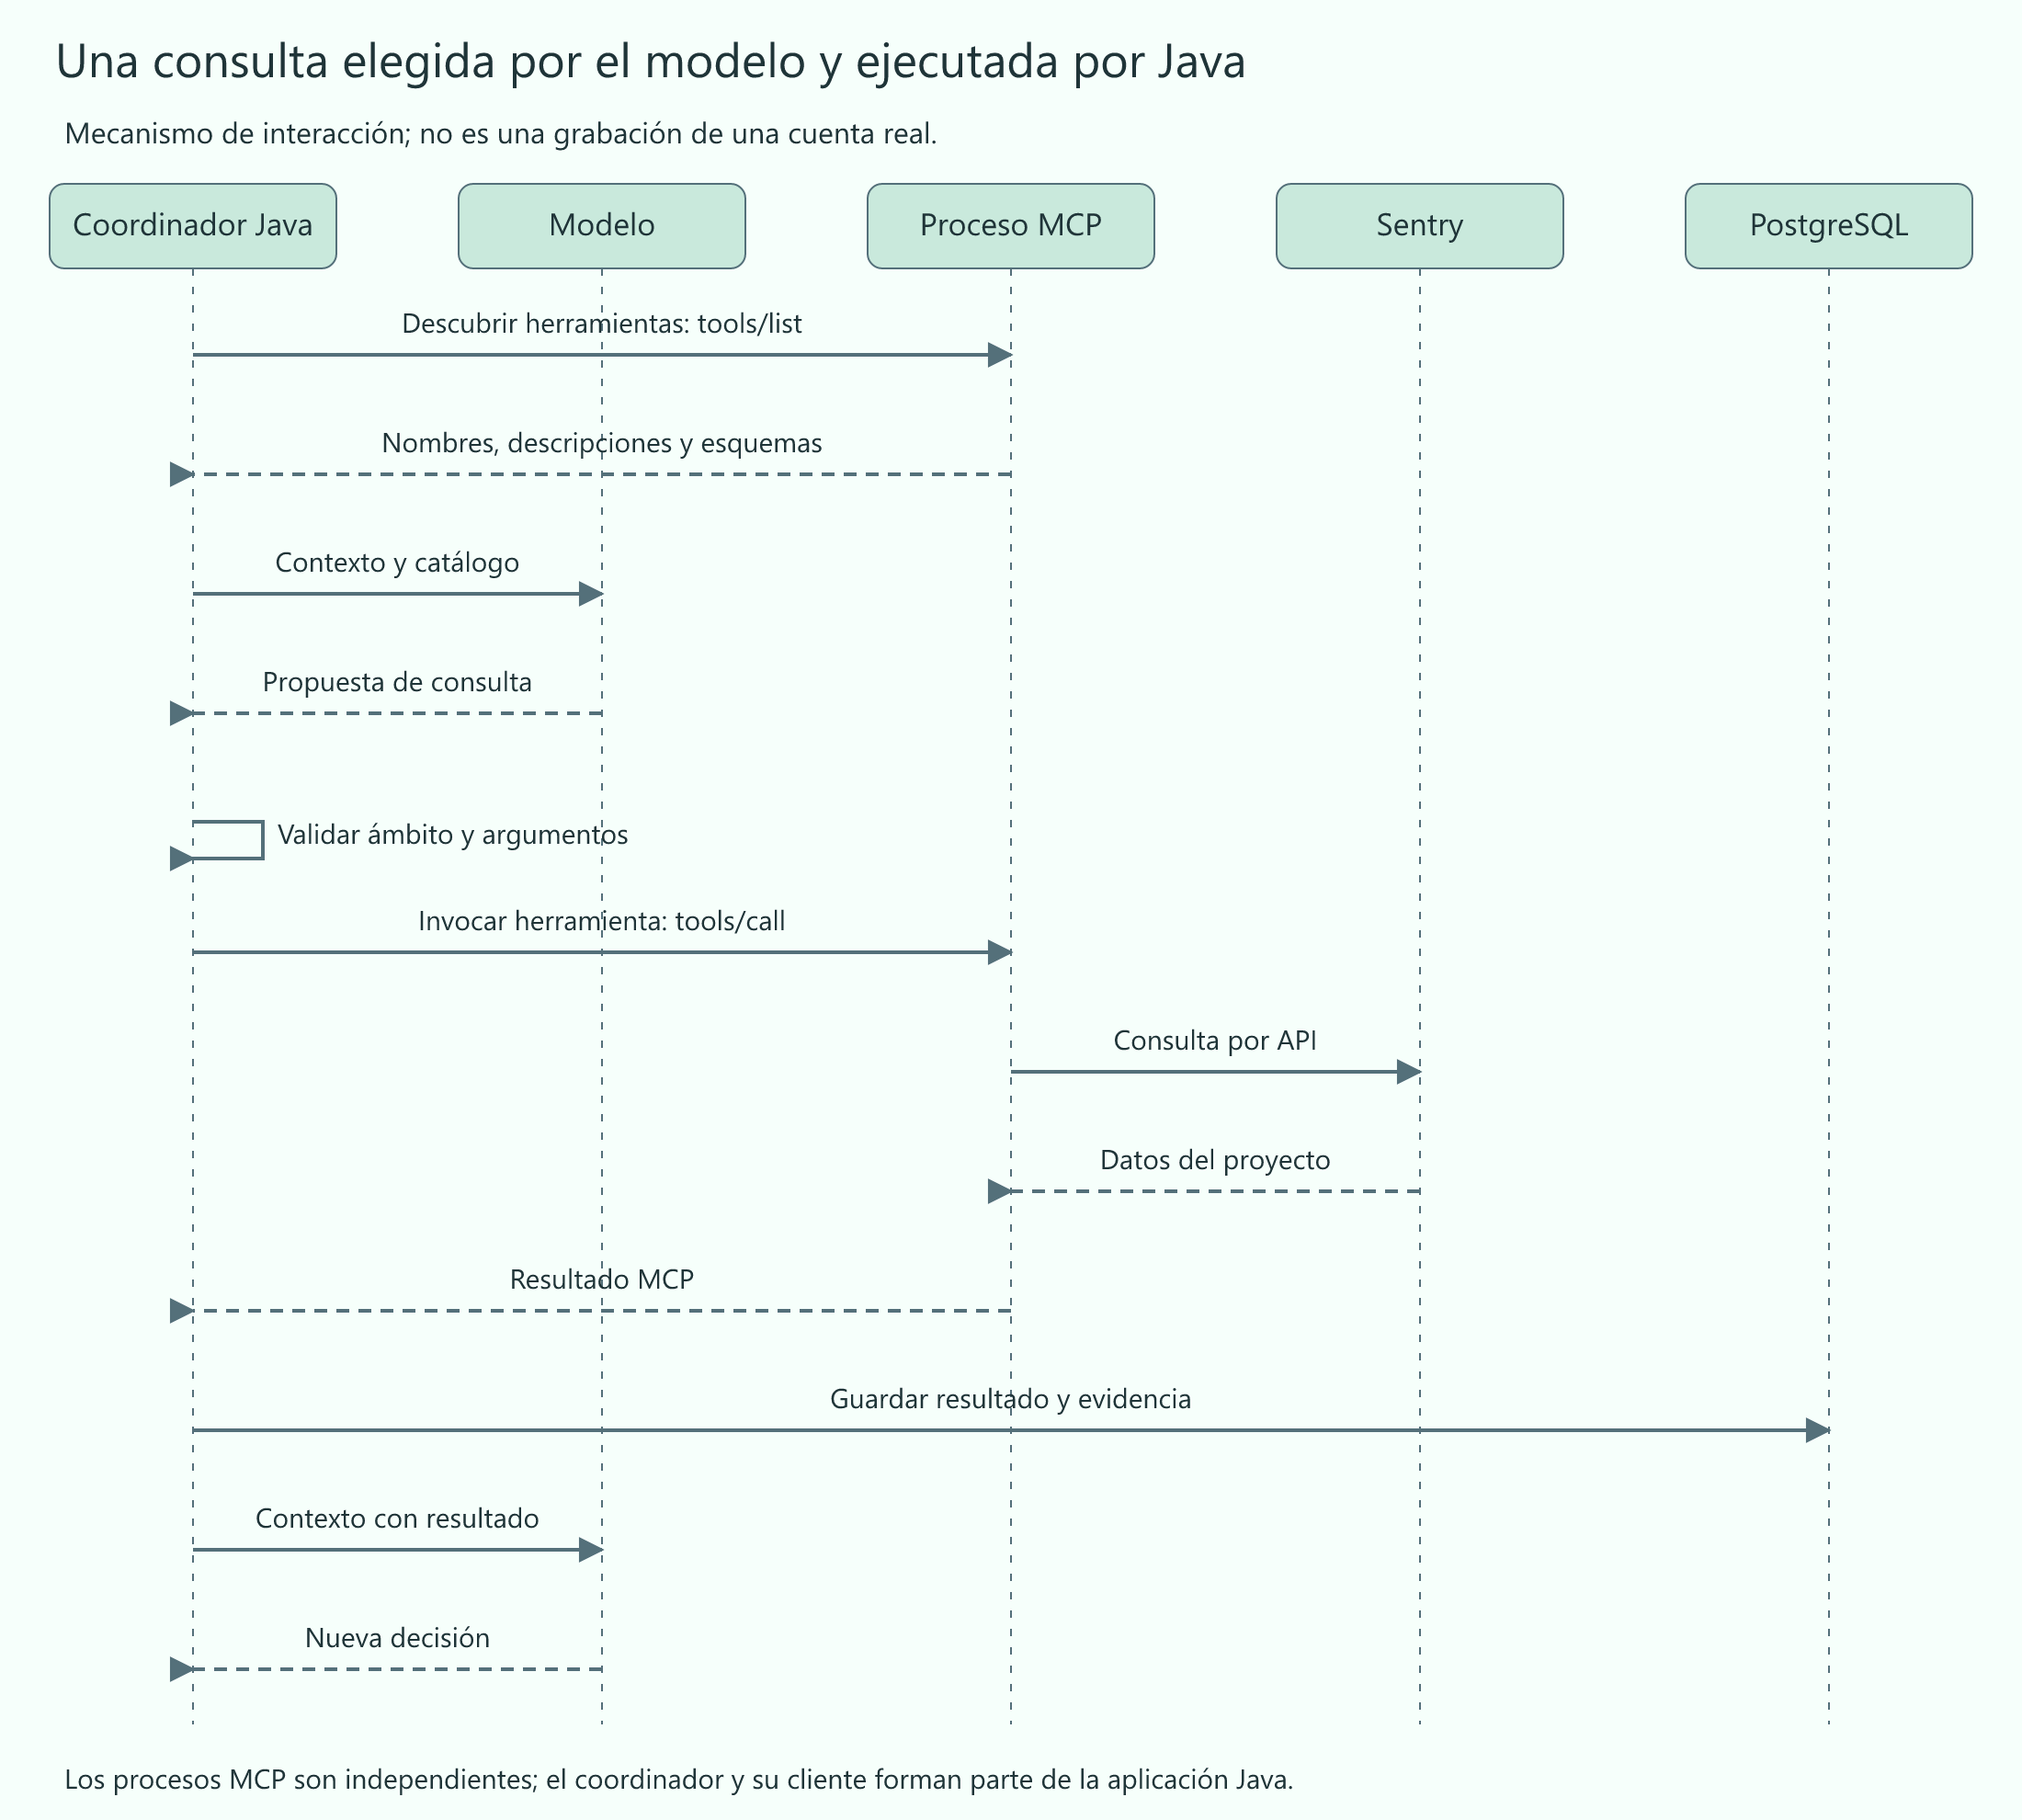
Las herramientas de Sentry y GitHub se descubren mediante MCP, Model Context Protocol. Sus servidores MCP son programas de integración: publican las operaciones disponibles y traducen sus invocaciones a consultas a las APIs de esos servicios.
En este montaje, el cliente Java se comunica con esos procesos mediante entrada y salida estándar, transporte stdio; ellos consultan los servicios por HTTPS. Java filtra el catálogo para ofrecer lecturas autorizadas y fija el repositorio y el proyecto. Añade tres herramientas locales: search_knowledge, para buscar documentos; ask_clarification, para pedir un dato esencial; y finish_investigation, para entregar la conclusión y el borrador.
El adaptador del modelo convierte contexto y catálogo al formato Chat Completions que recibe Groq. El catálogo describe lo que se puede pedir; la respuesta del modelo propone una operación concreta. Java comprobará esa propuesta antes de ejecutarla.
6. Primera pista: del modelo a una consulta en Sentry
Supongamos que el modelo elige buscar errores. Para diferenciar servicios, Java publica nombres como sentry__search_issues: el prefijo identifica Sentry y search_issues es la operación. El filtro level:error selecciona errores de ese nivel.
Este mensaje ilustrativo es la parte relevante de la respuesta del modelo a Java. tool_calls contiene la solicitud, function.name selecciona la herramienta y arguments es una cadena que contiene sus argumentos en JSON. call_1 identifica esta propuesta dentro de la conversación con el modelo:
{
  "role": "assistant",
  "tool_calls": [
    {
      "id": "call_1",
      "type": "function",
      "function": {
        "name": "sentry__search_issues",
        "arguments": "{\"query\":\"level:error\"}"
      }
    }
  ]
}
El modelo ha solicitado una búsqueda; todavía no ha consultado Sentry. Java comprueba el nombre y los argumentos, e incorpora organización, proyecto y región desde la configuración. Después su cliente MCP envía la llamada al proceso de Sentry.
El siguiente mensaje ilustra ese segundo intercambio, suponiendo un proyecto llamado orders-incident-demo. tu-organizacion representa el slug configurado en tu cuenta. El id mcp_1 relaciona esta llamada con su respuesta MCP; es independiente de call_1:
{
  "jsonrpc": "2.0",
  "id": "mcp_1",
  "method": "tools/call",
  "params": {
    "name": "search_issues",
    "arguments": {
      "query": "level:error",
      "organizationSlug": "tu-organizacion",
      "projectSlugOrId": "orders-incident-demo",
      "regionUrl": "https://sentry.io"
    }
  }
}
El servidor MCP realiza la consulta y devuelve el resultado. El adaptador del proyecto contempla también que Sentry ofrezca esas operaciones mediante un catálogo y una operación común de ejecución. Java resuelve esa variante; el modelo sigue solicitando la capacidad autorizada por su nombre.
El diagrama muestra quién envía y recibe cada mensaje. Antes del primer turno, Java descubre las herramientas mediante tools/list; luego el modelo propone, Java valida y el proceso MCP consulta Sentry. «PostgreSQL» es la base del investigador.
De un resultado a una evidencia
La primera búsqueda puede requerir consultas adicionales para obtener la pila de llamadas y la versión. Supongamos que ya hemos recuperado un evento relevante: apunta a CustomerReference, indica una NullPointerException y pertenece a la versión orders-demo@a645c267770f6d1ba144e6cd56682d74c183eae9.
Java conserva cada resultado con su origen, enlace, momento de consulta y contenido. Le asigna un identificador de evidencia, que permite citarlo después. Para simplificar el recorrido, llamaremos E1 al resultado que contiene ese evento; los identificadores reales dependen de las consultas realizadas.
El coordinador devuelve el resultado al modelo en un mensaje de rol tool, asociado mediante tool_call_id a la propuesta que lo solicitó. En nuestro primer intercambio ese valor sería call_1. El siguiente turno incluye lo obtenido y su identificador de evidencia.
El modelo ya puede elegir una consulta mejor informada. Si una herramienta falla, recibe el error y puede adaptar la búsqueda. Java limita resultados y contexto y rechaza consultas idénticas repetidas. Guardar un resultado permite revisarlo; todavía hace falta interpretar qué demuestra.
7. Segunda pista: consultar el código de esa versión
Volvemos al caso. Ahora tenemos una ubicación, CustomerReference, y un SHA. Esa información permite pedir a GitHub el archivo de la revisión afectada, sin dar por supuesto que el código actual coincide con el que produjo el evento.
La clase está en src/main/java/dev/adriangm/orders/domain/CustomerReference.java. El modelo puede solicitar su lectura y consultar el commit y su versión anterior para contrastar el cambio. Java fija propietario y repositorio; el modelo aporta datos como ruta y revisión dentro de ese ámbito.
Al leer el constructor encontramos value = value.strip();. La comparación con la base muestra que antes se comprobaba si value era nulo. Llamaremos E2 a la evidencia del archivo afectado; la comparación puede conservarse como otra evidencia con su propio identificador.
Esto aporta un mecanismo para explicar el error: una referencia ausente llega como null, falla al normalizarse y el pedido no alcanza la persistencia. Pero queda una pregunta: ¿debía admitirse un pedido sin referencia? El código describe lo que hace la aplicación; necesitamos el contrato para valorar si ese comportamiento es correcto.
8. Tercera pista: recuperar el contrato con RAG
El nombre del campo nos da una búsqueda concreta: customerReference. El modelo la solicita con search_knowledge, la herramienta local de documentos. Esta operación recibe query, el texto buscado, y devuelve hasta cinco pasajes con su procedencia.
Uno de los documentos relevantes es docs/components.md. El coordinador puede devolver al modelo un resultado como este; lo presentamos como ficha para leer sus campos sin el envoltorio JSON:
| Campo | Valor del pasaje de ejemplo |
|---|---|
evidenceId |
E3, identificador ilustrativo que usaremos para citar el contrato. |
path |
docs/components.md |
heading |
API de pedidos |
firstLine / lastLine |
3 / 10: límites del fragmento recuperado. |
revision |
a645c267770f6d1ba144e6cd56682d74c183eae9 |
excerpt |
Texto del fragmento, incluido el contrato que citamos a continuación. |
El pasaje contiene esta regla:
El contrato establece que
customerReferencees opcional. Los clienteslegacy-1pueden omitirlo. Según ese contrato, una referencia ausente debe almacenarse como cadena vacía.
Ahora el modelo dispone de información que no venía en la pregunta inicial. Recuperar los pasajes pertinentes y añadirlos a su contexto para elaborar la respuesta es RAG, generación apoyada en información recuperada. La búsqueda aporta el contrato que faltaba para interpretar la excepción y el código.
De dónde salen esos documentos
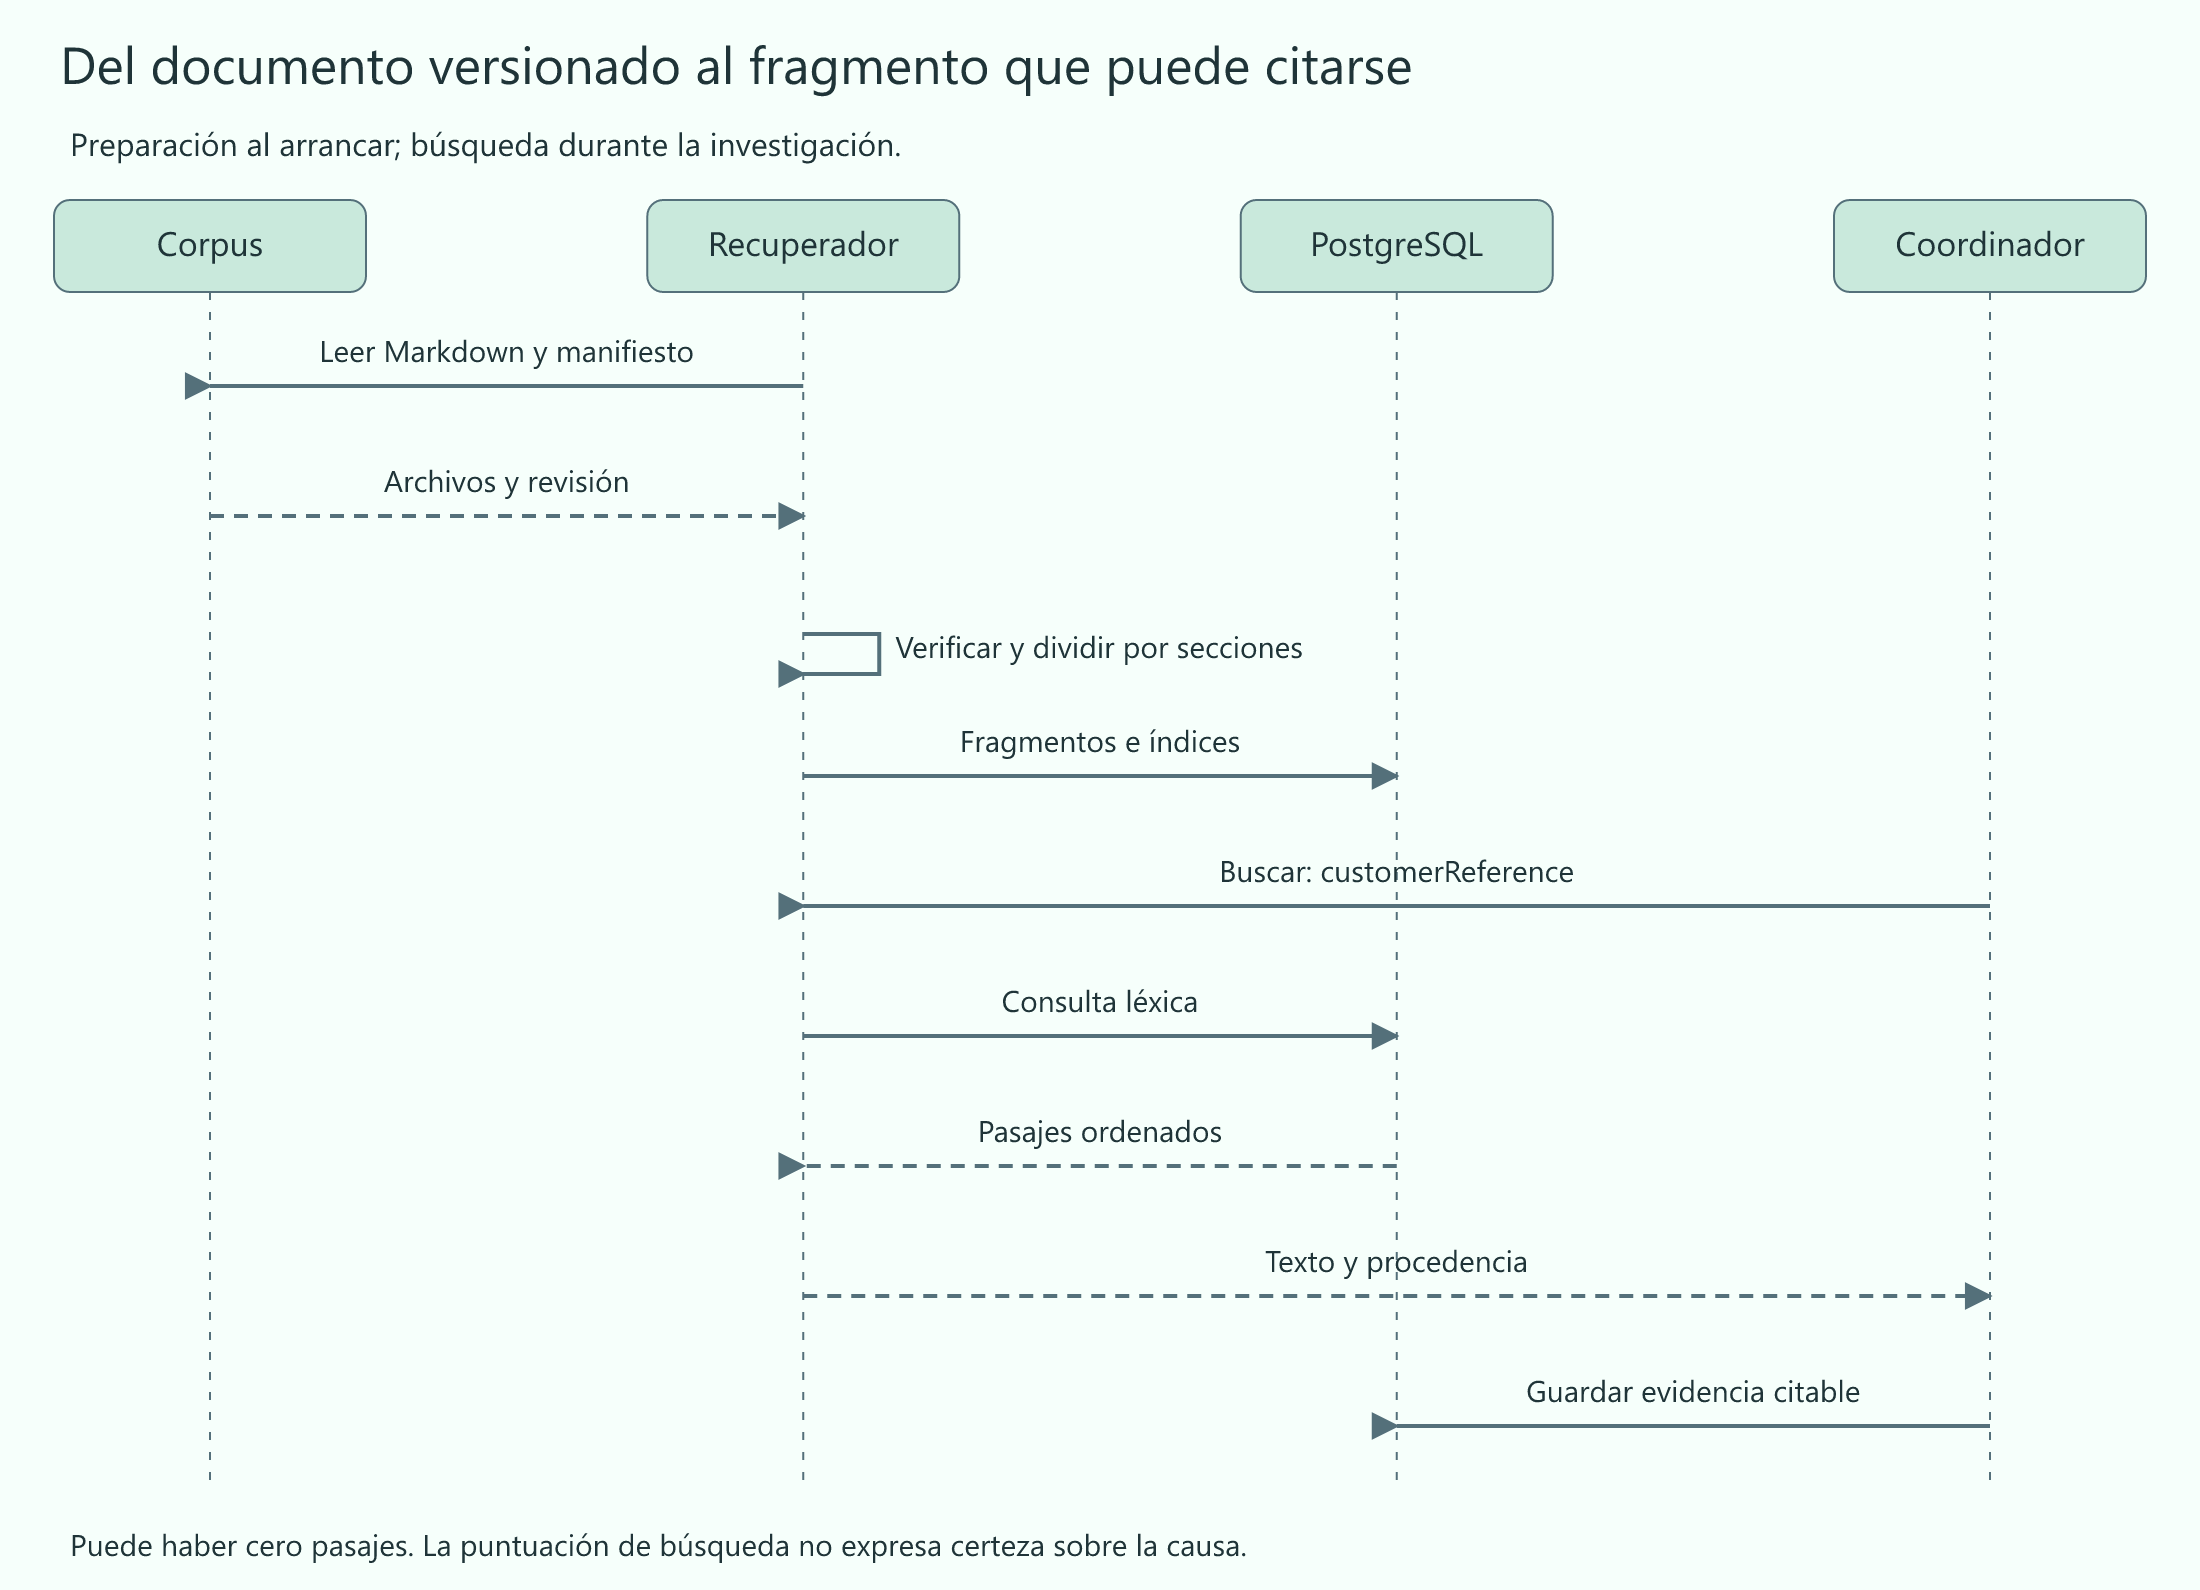
El corpus es el conjunto de Markdown de docs/ del proyecto de pedidos: componentes, decisiones, diagnóstico, despliegues y antecedentes ficticios. Antes de investigar, ejecutamos scripts/export_corpus.py, que pertenece al investigador. Copia los documentos desde el commit de pedidos elegido y genera un manifiesto, un archivo con la revisión y las huellas de contenido para verificar la copia.
Al arrancar, la clase MarkdownRetrieval comprueba los archivos, los divide por secciones y guarda fragmentos en PostgreSQL. Esa preparación es la ingesta. Cada fragmento conserva texto, ruta, encabezado, líneas y revisión; las secciones largas se dividen en tramos de hasta cuarenta líneas con cinco de solapamiento, para conservar contexto en los bordes.
Durante la investigación, esa clase actúa como recuperador: consulta los fragmentos guardados y devuelve los más pertinentes. El coordinador registra sus evidencias y las incorpora a la conversación. Esta herramienta local utiliza un contrato Java y no necesita otro servidor MCP.
El diagrama separa ambos momentos: primero se prepara el corpus al arrancar; después el coordinador pide la búsqueda de customerReference. Las respuestas incluyen texto y procedencia para conservar una fuente citable.
La búsqueda es léxica, basada en palabras e identificadores. PostgreSQL combina un índice en español con otro de configuración simple para términos técnicos y da más peso a los encabezados. La puntuación ordena coincidencias; no mide la probabilidad de que un documento explique el fallo.
Puede devolver cero pasajes. Si observamos que pierde documentos útiles cuando la pregunta usa otras palabras, podremos evaluar búsqueda semántica o una combinación de ambas. El contrato de recuperación permite cambiar ese mecanismo sin reescribir el ciclo del agente.
9. Relacionar las pistas y preparar un borrador
Ya podemos conectar las fuentes del recorrido. Los identificadores siguientes son ilustrativos; el diagnóstico real debe utilizar los asignados a sus propios resultados:
| Evidencia | Qué aporta |
|---|---|
E1: evento de Sentry |
Excepción en la construcción de CustomerReference y versión afectada. |
E2: archivo de GitHub |
El constructor de esa versión invoca strip() sin tratar la ausencia de valor. |
E3: pasaje documental |
El contrato permite omitir customerReference y exige convertir su ausencia en cadena vacía. |
Una conclusión revisable separaría:
- Hechos: existe una excepción en esa versión [E1]; el constructor invoca
strip()sin comprobar el nulo [E2]; el contrato permite omitir el campo [E3]. - Hipótesis: la normalización explica los fallos de pedidos que llegan sin referencia.
- Incertidumbres: esas fuentes no establecen por sí solas cuándo se desplegó la versión ni cuántas peticiones fallaron sobre el total recibido.
- Comprobación recomendada: enviar a la misma versión pedidos con y sin referencia y contrastar respuestas y eventos.
El modelo solicita el cierre con finish_investigation, aportando esos apartados, las referencias y el título y cuerpo del borrador. Java exige citas en los hechos y comprueba que los identificadores existan y estén declarados. Conserva la conclusión y añade las fuentes al borrador. Esa validación relaciona citas con resultados guardados; el operador revisa si sostienen la interpretación.
Qué revisaríamos antes de crear la incidencia
Además del diagnóstico, necesitamos un informe que otro desarrollador pueda usar. Este ejemplo muestra el texto que revisaríamos; la aplicación añade también las fuentes con sus enlaces:
Título: Guardar un pedido sin referencia devuelve 500 aunque el campo es opcional.
Descripción: En la versión afectada se observa una excepción en CustomerReference [E1]. Su constructor normaliza el valor con strip() sin tratar el caso nulo [E2]. El contrato admite omitir customerReference y convertirlo en cadena vacía [E3].
Reproducción propuesta: enviar {"quantity":1} y compararlo con {"quantity":1,"customerReference":"ORDER-1"} a la misma versión.
Resultado esperado: ambas peticiones guardan el pedido; la primera conserva la referencia como cadena vacía.
Línea de corrección propuesta: recuperar el tratamiento de la referencia ausente y cubrir ese caso con una prueba del contrato. Verificar también que una referencia explícita mantiene su normalización.
Al consultar GET /investigations/{id} tendremos el estado COMPLETED, el diagnóstico, las evidencias y draft, con título, cuerpo, versión y huella. Completar puede significar también concluir que faltan pruebas para determinar la causa. El agente lee fuentes y prepara ese contenido; sus operaciones de investigación no modifican código ni despliegan aplicaciones.
10. Revisar, editar y aprobar la incidencia de GitHub
El operador revisa el repositorio de destino, el título, el cuerpo y las fuentes. Si necesita corregir el texto, utiliza PUT /investigations/{id}/draft, enviando expectedDraftVersion, title y el body completo. La guía de API incluye la petición completa.
Cada edición produce una versión y un hash nuevos: una huella calculada a partir del repositorio y el contenido exacto. Consultamos el resultado y aprobamos esos valores, para evitar que una revisión termine autorizando otro texto.
La siguiente petición entra en la API del investigador. Sustituimos {id}, la versión y el hash por los recibidos al consultar el borrador revisado:
POST /investigations/{id}/issue HTTP/1.1
Authorization: Bearer <operator-token>
Content-Type: application/json
Idempotency-Key: orders-publication-001

{
  "draftVersion": 1,
  "hash": "<hash del borrador revisado>"
}
La API guarda la aprobación y responde 202. La investigación pasa de COMPLETED a PUBLISH_QUEUED, «publicación pendiente». JobWorker reserva esa operación y la entrega a Publisher, el caso de uso que crea la incidencia. Utiliza un token de escritura y una operación MCP que no se ofrece al modelo durante el análisis.
Si GitHub confirma la creación, conservamos el enlace y el estado PUBLISHED. El enlace actúa como recibo: permite identificar lo creado y devolverlo ante la misma solicitud.
Qué ocurre si se pierde la respuesta
GitHub puede crear la incidencia y perderse la respuesta. Guardamos entonces PUBLISH_UNKNOWN, «resultado incierto». El cuerpo aprobado incluye un marcador de la investigación que permite buscarla después.
Al repetir la misma aprobación con su clave, versión y hash, Publisher busca ese marcador. El diagrama representa el caso en que encuentra la incidencia ya creada y conserva su enlace. «Aplicación Java» reúne la API, JobWorker y Publisher.
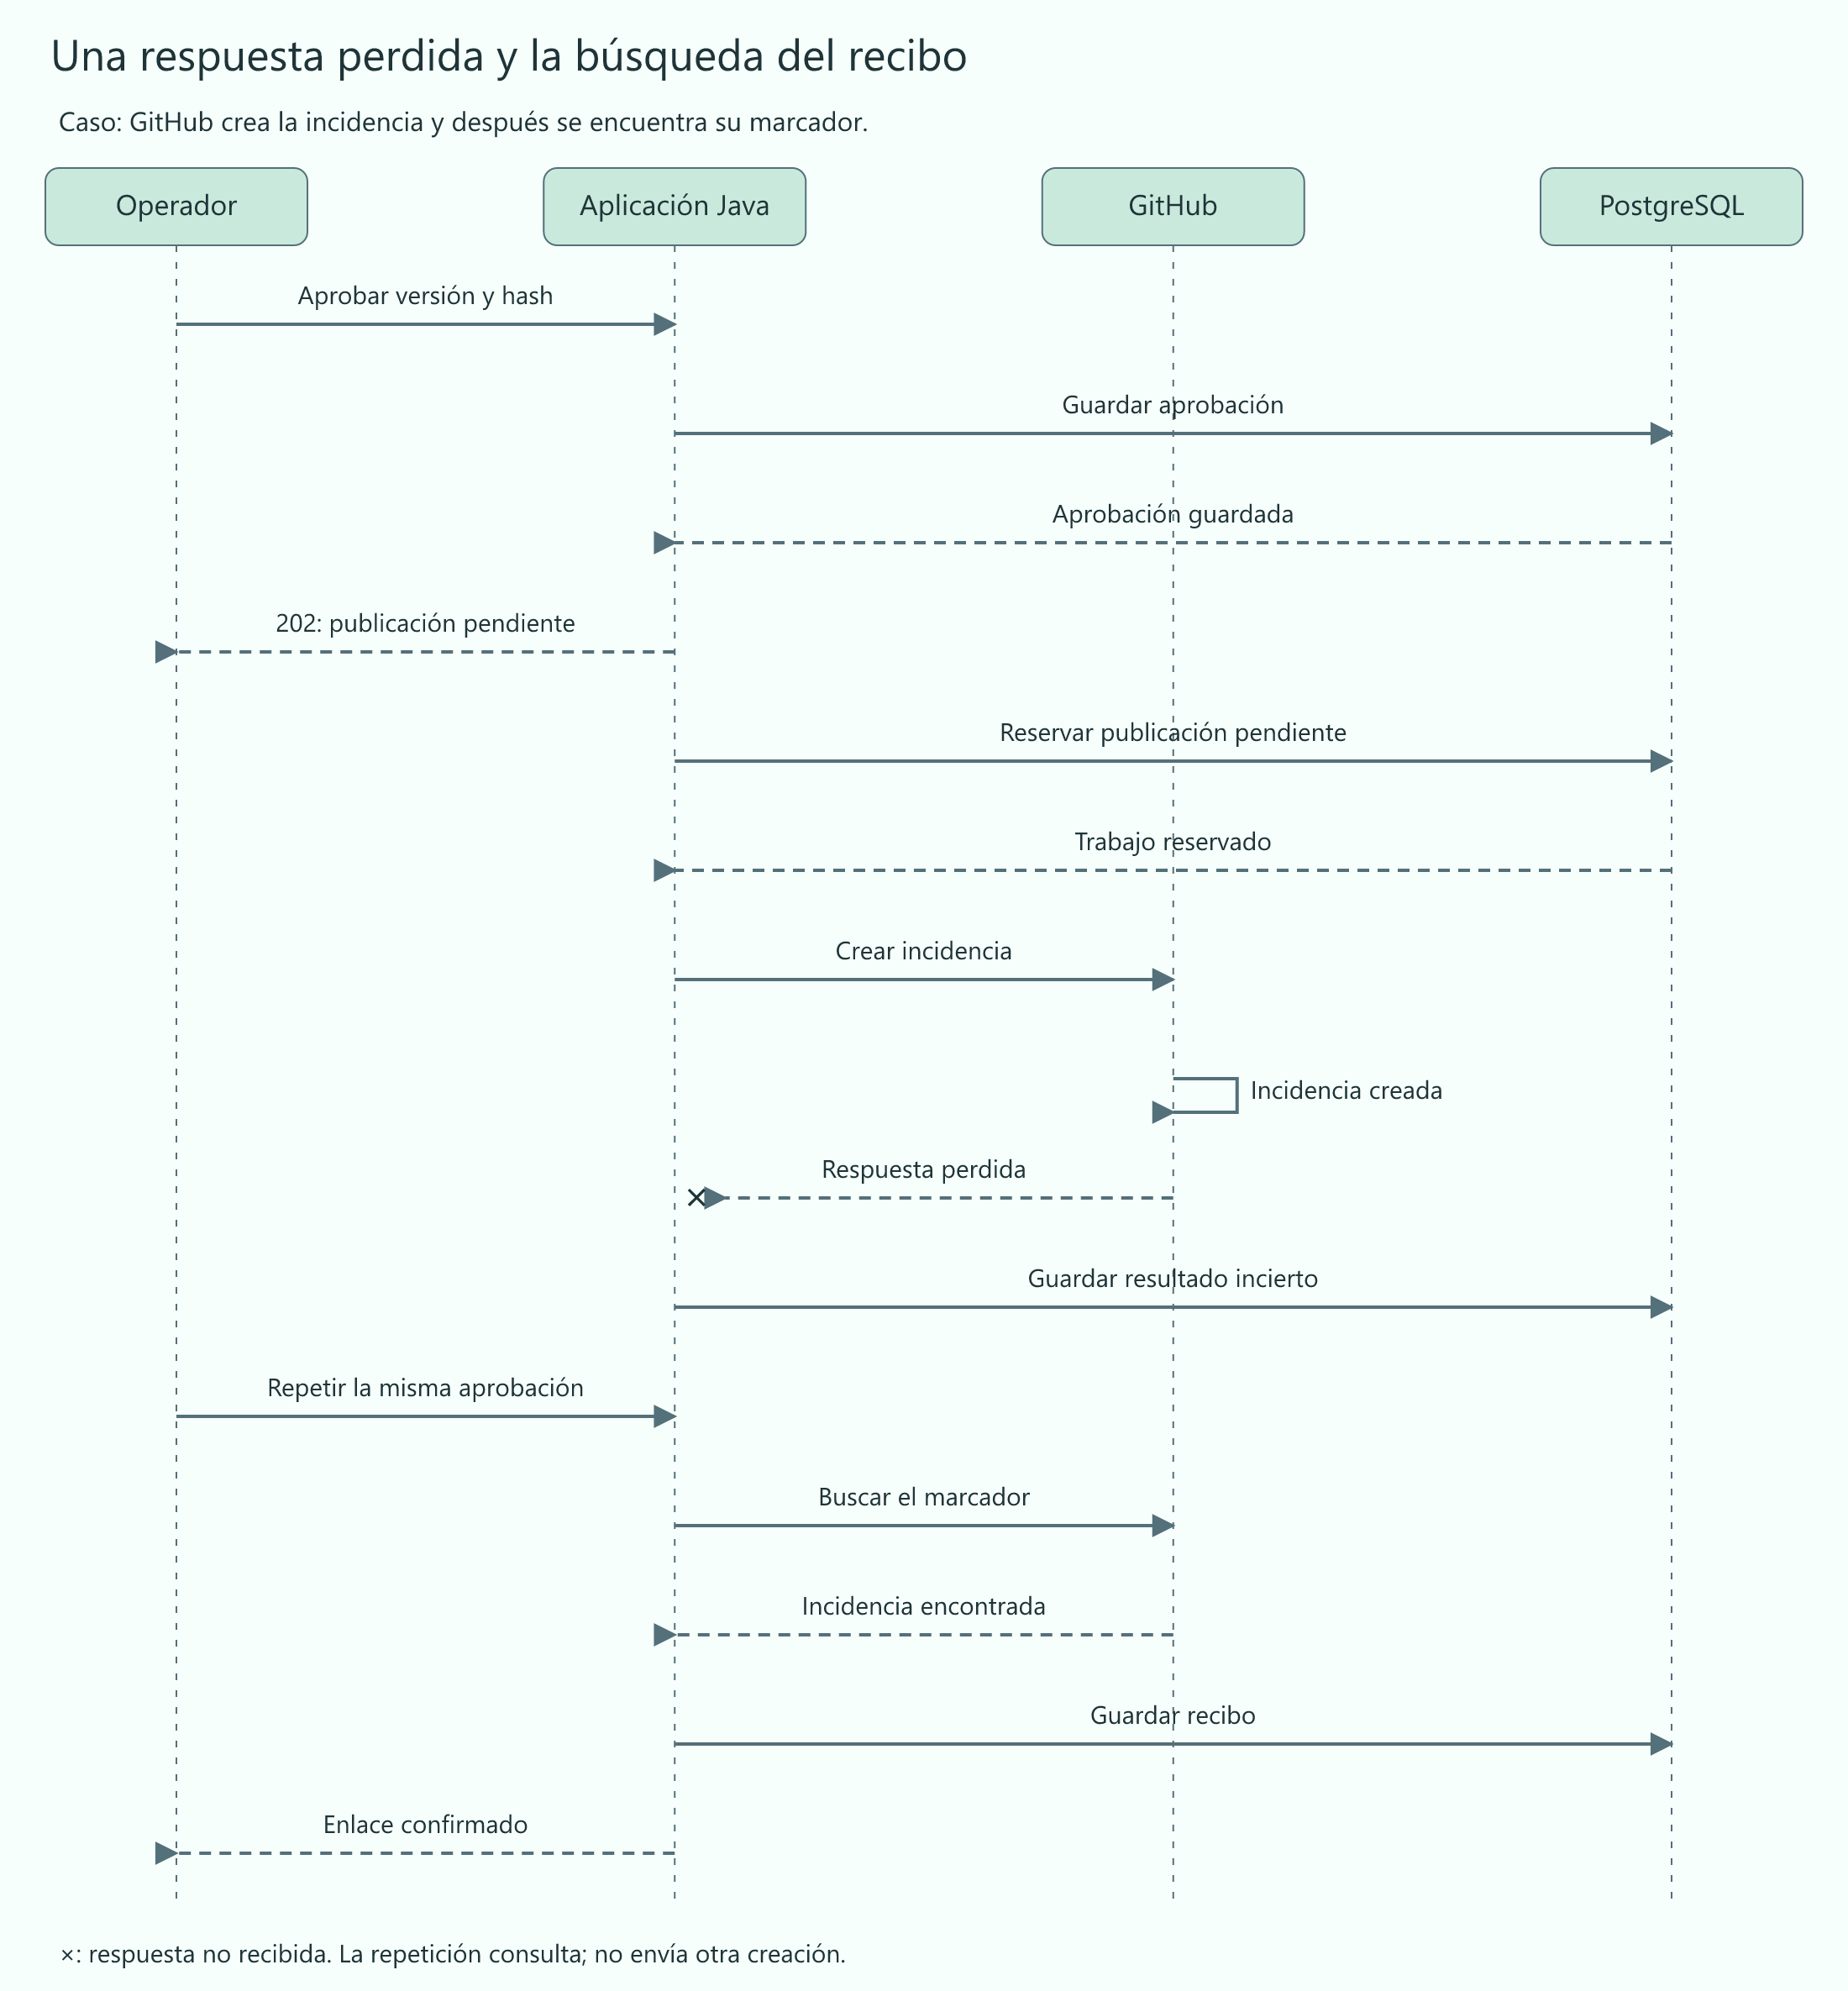
Si no la encuentra, mantiene la incertidumbre y requiere revisión humana; no envía automáticamente otra creación. Si ya estaba confirmada, devuelve el resultado guardado. Así la aprobación sigue vinculada a un contenido concreto y los reintentos evitan una segunda escritura a ciegas.
11. Cómo se organiza el código que acabamos de recorrer
Las responsabilidades ya vistas se reparten mediante Clean Architecture: dominio y casos de uso definen reglas y contratos; las integraciones implementan esos contratos. Las decisiones de investigación y aprobación pueden funcionar sin depender de Spring, SQL o el SDK MCP.
| Parte | Responsabilidad y ubicación |
|---|---|
Investigation, en domain/ |
Conserva estado, evidencias y borrador; protege transiciones y aprobación. |
ManageInvestigations, en application/ |
Recibe los encargos y coordina consulta, aclaraciones, edición y aprobación. |
Investigator y Publisher, en application/ |
Conducen el análisis y ejecutan la creación aprobada, respectivamente. |
InvestigationWork, en application/ |
Conserva conversación, pasos y consumo de la ejecución. |
Puertos, en application/Ports.java |
Contratos para modelo, herramientas, documentos y almacenamiento. |
Adaptadores, en adapter/ |
Conectan HTTP, tareas, Groq, MCP y PostgreSQL con esos contratos. |
Composición, en bootstrap/ |
Spring construye las implementaciones y las conecta al arrancar. |
Las rutas parten del paquete dev.adriangm.investigator. El mapa permite localizar el código de cada paso sin aprender todas las clases antes de seguir la investigación.
Aplicamos diseño guiado por el dominio (DDD) a las reglas que deben mantenerse coherentes. Investigation actúa como agregado: reúne estado y borrador y controla sus cambios, por ejemplo que una aprobación coincida con la versión revisada. Una respuesta de Sentry sigue siendo un dato externo; no necesita convertirse en otra entidad de dominio.
PostgreSQL conserva el estado y el historial como una instantánea que se reemplaza al guardar avances. Cada escritura comprueba la versión anterior para detectar cambios concurrentes. Es sencillo para este volumen; reescribir un historial creciente puede justificar otra organización si aumenta la carga.
Pedidos mantiene la misma separación: HTTP recibe la petición, el caso de uso coordina, el dominio normaliza y valida, y los adaptadores conectan SQL y Sentry. ArchUnit, una biblioteca que comprueba dependencias entre clases, verifica esas fronteras en ambos proyectos. Sus documentos de arquitectura recogen las alternativas y sus costes.
12. Límites que también forman parte del resultado
Una investigación puede seguir acumulando consultas sin llegar a una conclusión. El coordinador comienza con límites de ocho llamadas al modelo, dieciséis herramientas y seis minutos, además de tamaños máximos para contexto y resultados.
Si falta un dato esencial, ask_clarification deja una pregunta al operador. Este responde mediante POST /investigations/{id}/messages, con la versión actual y su mensaje, para continuar el trabajo. Si se agota el presupuesto o un servicio no está disponible, se conservan los avances y el motivo de la interrupción. El GET permite distinguir esos casos de una investigación terminada.
Las pruebas de pedidos comprueban que el escenario se reproduce; las del investigador verifican permisos, citas, persistencia, aprobación, concurrencia y tratamiento de fallos. Para valorar la calidad del agente también hay que examinar qué consultas elige y si sus conclusiones se sostienen en las fuentes.
La revisión tiene una pregunta práctica: ¿puede otro desarrollador abrir las referencias y comprobar la explicación? Un diagnóstico útil conecta el error observado, el código de esa versión y el contrato, dejando visibles las dudas. El borrador convierte ese trabajo en una propuesta que podemos revisar antes de crear una incidencia en GitHub.