Un proveedor nos envía cada semana su catálogo en un archivo. Algunas referencias llegan con espacios alrededor, otras vienen vacías y, de vez en cuando, aparece un precio negativo que nadie sabe explicar. El método que importa el archivo lee cada fila, la limpia, la comprueba y la guarda dentro del mismo bucle de cien líneas.
Funciona, hasta que llega un segundo proveedor con sus propias manías y queremos reutilizar solo la parte que revisa los precios. Para sacarla hay que entender todo el bucle, y para entender el bucle hay que seguir variables que cambian de significado a mitad de camino. Reutilizar una comprobación de dos líneas no debería parecerse tanto a una excavación arqueológica.
El estilo de tuberías y filtros propone otra forma de organizar ese trabajo: dividirlo en etapas pequeñas, cada una con una entrada y una salida claras, y conectarlas en orden. Vamos a construir esa importación paso a paso.
Qué es un filtro y qué es una tubería
Un filtro es una etapa que recibe un dato, hace una única transformación o comprobación y entrega el resultado. Una tubería es la conexión que lleva la salida de un filtro a la entrada del siguiente.
Una imagen útil es la de una cadena de lavado de coches. Un tramo moja, otro enjabona, otro aclara y el último seca. Cada tramo sabe hacer su parte y no necesita saber cuál viene después. Si mañana queremos añadir un encerado, lo colocamos en su sitio sin rediseñar el túnel entero.
En software, el dato que atraviesa la tubería será una fila del catálogo. La separación en etapas no exige ejecutar cada filtro en una máquina distinta ni montar colas de mensajes. Un bucle que llama a varios objetos en orden ya es una tubería. Distribuir las etapas añade serialización, colas y recuperación ante caídas, así que solo compensa cuando resuelve una necesidad concreta. Es la misma prudencia de KISS y YAGNI: primero, la versión que se entiende.
El patrón Pipes and Filters del centro de arquitectura de Microsoft describe esta descomposición también en sistemas distribuidos. Aquí nos quedamos con la versión local, que permite ver con claridad qué hace cada etapa.
El dato que viaja: una fila del catálogo
Supondremos que otra pieza ya ha leído el archivo y ha convertido cada línea en un objeto. Así nos centramos en las transformaciones y dejamos fuera los detalles del formato. El precio se guarda en céntimos de euro para evitar los redondeos de los números decimales.
class ProductRow {
    private final String sku;
    private final int priceInCents;

    public ProductRow(String sku, int priceInCents) {
        this.sku = sku;
        this.priceInCents = priceInCents;
    }

    public String getSku() {
        return sku;
    }

    public int getPriceInCents() {
        return priceInCents;
    }
}
sku es la referencia del producto, el código con el que el catálogo lo identifica. Los campos son final: un filtro no modifica la fila que recibe; si necesita cambiarla, crea una nueva. Así la fila original sigue disponible y podemos mostrar en un informe qué llegó exactamente.
El contrato común de todas las etapas
Cada filtro puede terminar de dos maneras: deja pasar una fila, quizá transformada, o la rechaza con un motivo. Representamos ese resultado con una clase pequeña:
class StepResult {
    private final ProductRow row;
    private final String rejectionReason;

    private StepResult(ProductRow row, String rejectionReason) {
        this.row = row;
        this.rejectionReason = rejectionReason;
    }

    public static StepResult accept(ProductRow row) {
        return new StepResult(row, null);
    }

    public static StepResult reject(String reason) {
        return new StepResult(null, reason);
    }

    public boolean isAccepted() {
        return rejectionReason == null;
    }

    public ProductRow getRow() {
        return row;
    }

    public String getRejectionReason() {
        return rejectionReason;
    }
}
El constructor es privado: solo se puede crear un resultado mediante accept() o reject(). Así no existe un resultado aceptado sin fila ni uno rechazado sin motivo.
Con ese resultado, el contrato de un filtro cabe en una línea:
interface RowFilter {
    StepResult apply(ProductRow row);
}
Como vimos en dependencias y contratos, una firma necesita un significado. Este es el nuestro: un filtro recibe una fila no nula, no guarda nada fuera y devuelve una fila aceptada o un motivo de rechazo.
Tres filtros con una sola tarea cada uno
El primero elimina los espacios exteriores de la referencia:
class TrimSku implements RowFilter {
    public StepResult apply(ProductRow row) {
        String trimmed = row.getSku().trim();
        return StepResult.accept(new ProductRow(trimmed, row.getPriceInCents()));
    }
}
trim() quita los espacios del principio y del final: " BOOK-01 " se convierte en "BOOK-01". Este filtro nunca rechaza; solo normaliza.
Los otros dos comprueban condiciones:
class RequireSku implements RowFilter {
    public StepResult apply(ProductRow row) {
        if (row.getSku().isEmpty()) {
            return StepResult.reject("Missing SKU");
        }
        return StepResult.accept(row);
    }
}

class RejectNegativePrice implements RowFilter {
    public StepResult apply(ProductRow row) {
        if (row.getPriceInCents() < 0) {
            return StepResult.reject("Negative price");
        }
        return StepResult.accept(row);
    }
}
Un precio de cero se acepta: puede ser un producto de regalo. Ninguna de estas clases sabe qué filtros existen antes o después, ni si la fila acabará guardada o mostrada en una previsualización. Cada una tiene un único motivo para cambiar, la idea de responsabilidad única de SOLID aplicada a una etapa.
La tubería conecta los filtros
Ahora necesitamos la pieza que pasa cada fila por los filtros en orden y anota el resultado. Primero, el informe:
class ImportReport {
    private final List<ProductRow> accepted = new ArrayList<>();
    private final List<String> rejections = new ArrayList<>();

    public void accept(ProductRow row) {
        accepted.add(row);
    }

    public void reject(ProductRow original, String reason) {
        rejections.add("'" + original.getSku() + "': " + reason);
    }

    public List<ProductRow> getAccepted() {
        return new ArrayList<>(accepted);
    }

    public List<String> getRejections() {
        return new ArrayList<>(rejections);
    }
}
El rechazo guarda la referencia original, con sus espacios incluidos, y el motivo. Así el proveedor puede localizar la fila exacta que tiene que corregir. Los métodos de consulta devuelven copias para que nadie modifique el informe desde fuera.
Y la tubería:
class ImportPipeline {
    private final List<RowFilter> filters;

    public ImportPipeline(List<RowFilter> filters) {
        this.filters = new ArrayList<>(filters);
    }

    public ImportReport process(List<ProductRow> rows) {
        ImportReport report = new ImportReport();
        for (ProductRow original : rows) {
            ProductRow current = original;
            String rejectionReason = null;
            for (RowFilter filter : filters) {
                StepResult result = filter.apply(current);
                if (!result.isAccepted()) {
                    rejectionReason = result.getRejectionReason();
                    break;
                }
                current = result.getRow();
            }
            if (rejectionReason == null) {
                report.accept(current);
            } else {
                report.reject(original, rejectionReason);
            }
        }
        return report;
    }
}
El bucle exterior recorre las filas. El interior pasa la fila actual por cada filtro: si un filtro la acepta, su resultado se convierte en la entrada del siguiente; si la rechaza, break detiene el recorrido de esa fila. Al terminar, la fila va a la lista de aceptadas o a la de rechazos.
Seguir tres filas por la tubería
Montamos la tubería con los filtros en orden y le damos tres filas:
ImportPipeline pipeline = new ImportPipeline(Arrays.asList(
        new TrimSku(), new RequireSku(), new RejectNegativePrice()));

ImportReport report = pipeline.process(Arrays.asList(
        new ProductRow(" BOOK-01 ", 1999),
        new ProductRow("BOOK-02", -10),
        new ProductRow("   ", 500)));

report.getAccepted();   // one row: "BOOK-01", 1999
report.getRejections(); // ["'BOOK-02': Negative price", "'   ': Missing SKU"]
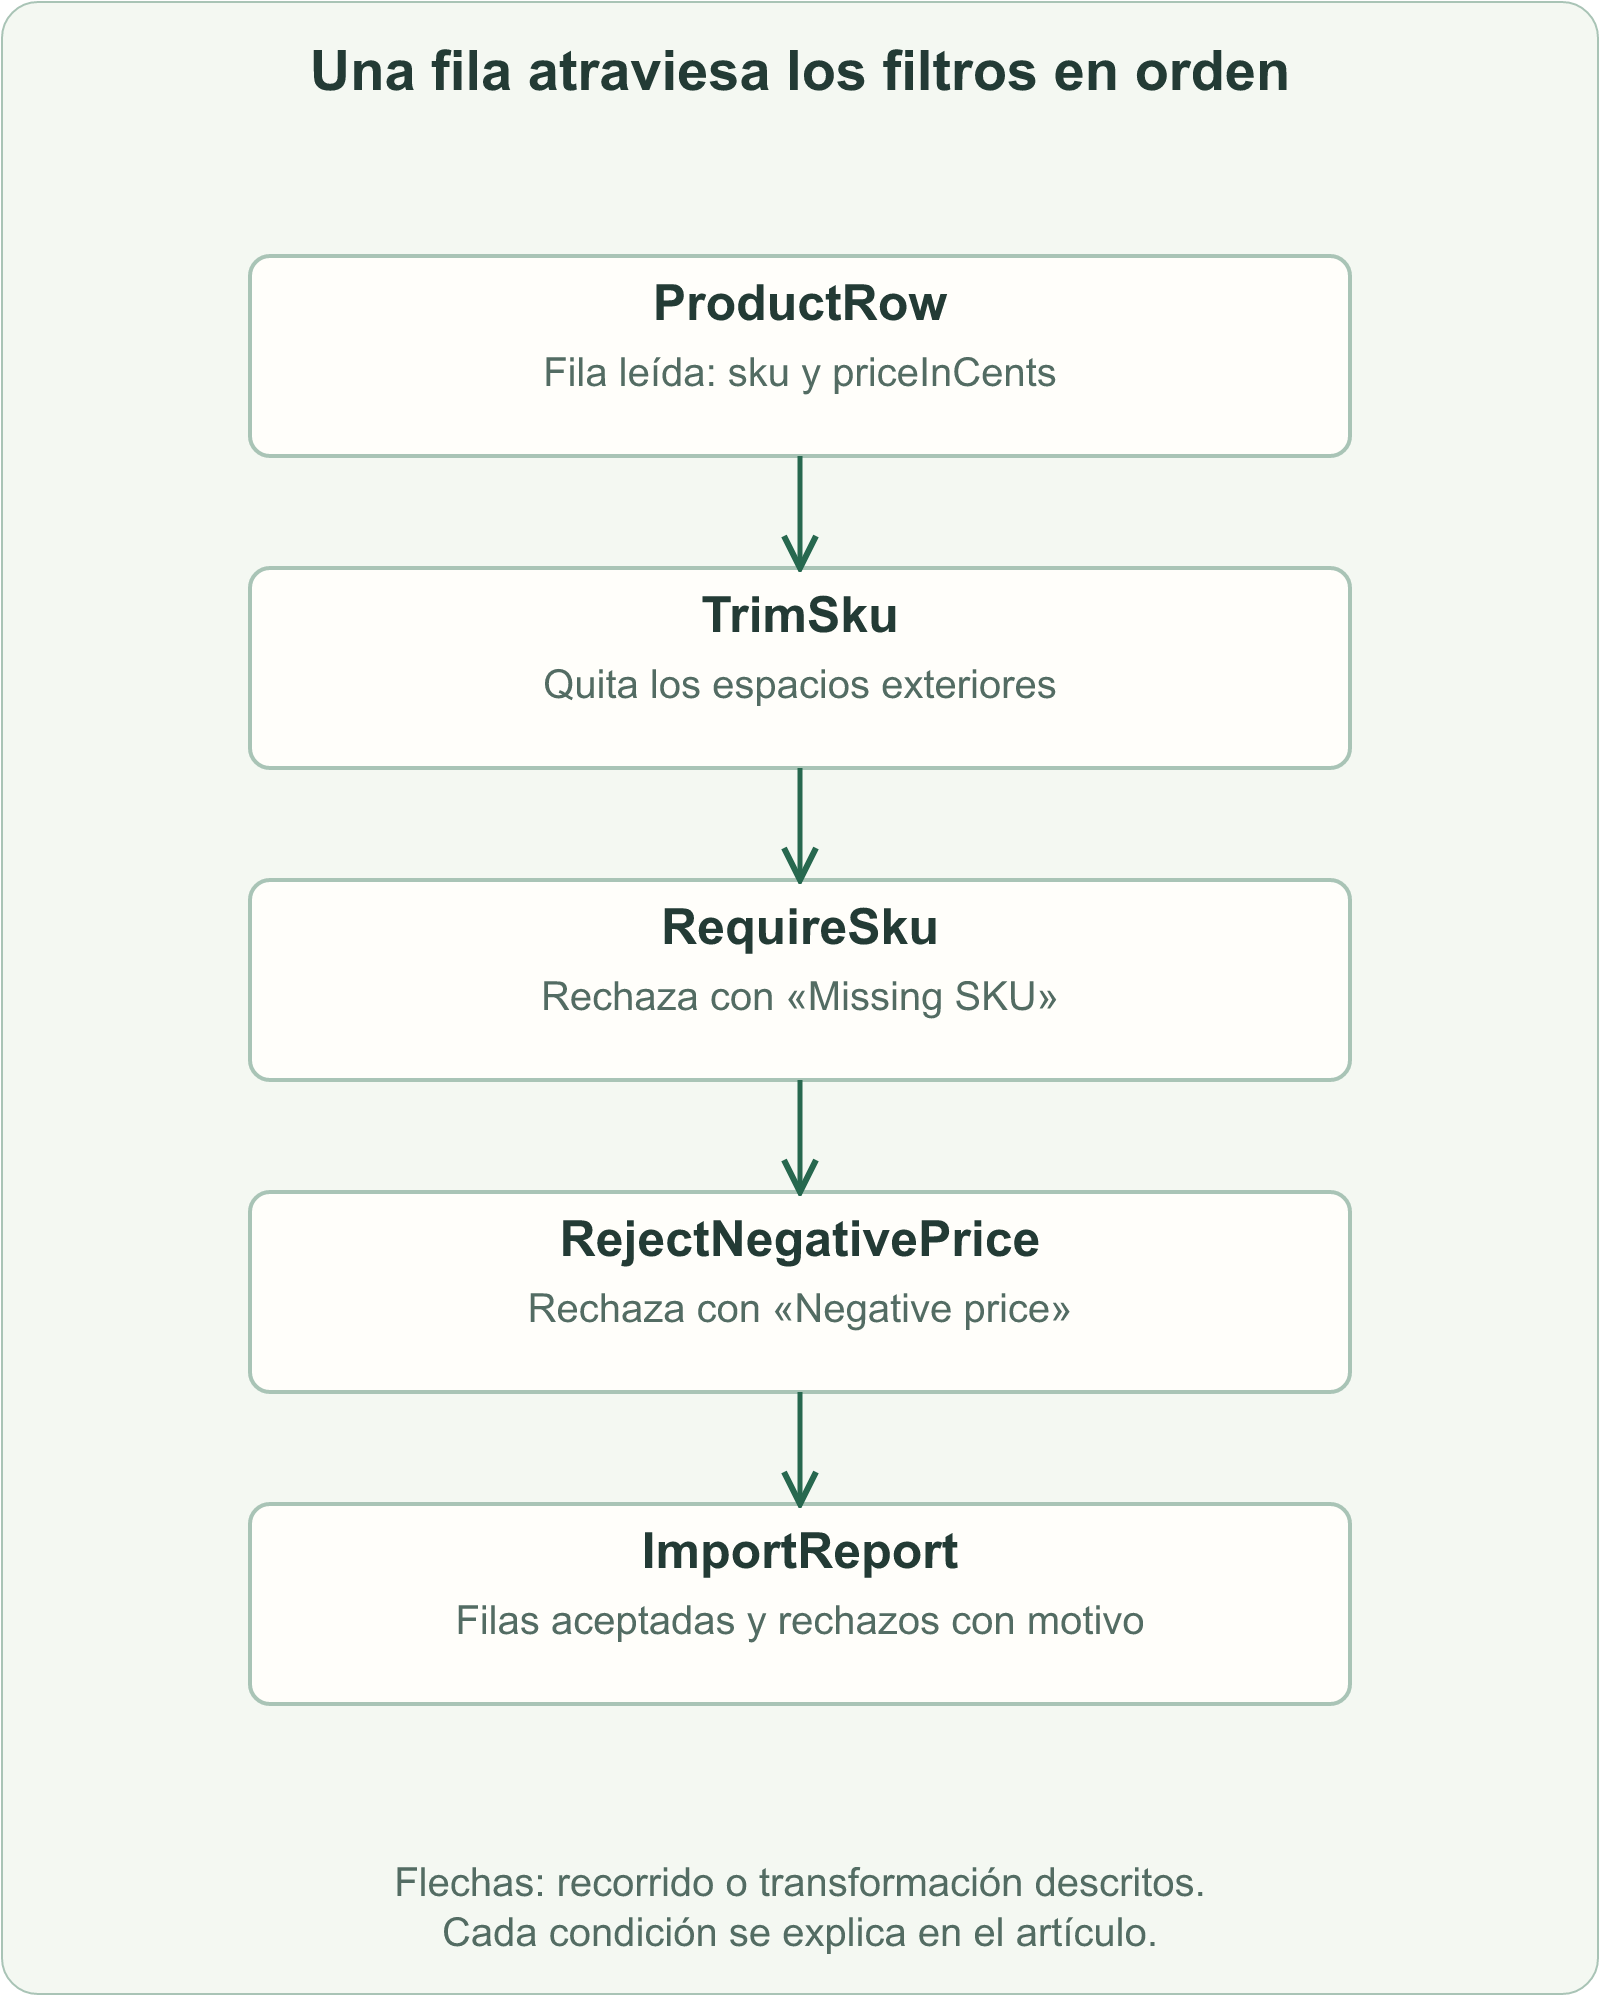
Las flechas del diagrama representan el recorrido de los datos, no dependencias entre clases: ningún filtro conoce al siguiente.
" BOOK-01 "pierde sus espacios enTrimSku, tiene referencia y su precio es positivo. Llega al final como"BOOK-01", con 1999 céntimos."BOOK-02"supera las dos primeras etapas y se detiene enRejectNegativePrice. No desaparece: queda en el informe con su motivo." "sale deTrimSkucomo una cadena vacía, yRequireSkula rechaza.
Cada fila tiene un recorrido que podemos explicar. Si un proveedor pregunta por qué falta un producto, el informe le da una respuesta concreta, no un «error de importación».
El orden forma parte de la regla
Probemos a cambiar el orden y colocar RequireSku antes de TrimSku. La fila " " no está vacía: tiene tres espacios. RequireSku la deja pasar, TrimSku la convierte después en "" y el producto se acepta sin referencia.
Ningún filtro tiene un error por separado, y aun así el resultado es incorrecto. Por eso el orden también hay que decidirlo y documentarlo: una tubería no es una bolsa de comprobaciones en la que todo encaja de cualquier manera.
Con las normalizaciones conviene ser igual de cuidadosos. Convertir las referencias a mayúsculas parece una limpieza inocente, pero solo es correcto si el catálogo considera que book-01 y BOOK-01 son el mismo producto. Si los distingue, ese filtro cambia identidades. Antes de añadir una etapa que «arregla» datos, merece la pena escribir qué significa el cambio.
Combinar las piezas para otro proveedor
Ahora llega ese segundo proveedor. Envía las referencias en minúsculas, y en nuestro catálogo sí son equivalentes a las mayúsculas. Creamos un filtro más:
class UppercaseSku implements RowFilter {
    public StepResult apply(ProductRow row) {
        String uppercase = row.getSku().toUpperCase(Locale.ROOT);
        return StepResult.accept(new ProductRow(uppercase, row.getPriceInCents()));
    }
}
Locale.ROOT hace que la conversión no dependa del idioma configurado en el equipo, que en algunos idiomas cambia el resultado de ciertas letras.
La tubería de este proveedor reutiliza los filtros existentes y añade el nuevo:
ImportPipeline secondSupplier = new ImportPipeline(Arrays.asList(
        new TrimSku(), new UppercaseSku(), new RequireSku(), new RejectNegativePrice()));
Con " book-03 " y 1250 céntimos, el resultado aceptado es "BOOK-03". No hemos modificado TrimSku ni RejectNegativePrice, y la tubería del primer proveedor sigue igual. La composición funciona porque todas las etapas cumplen el mismo contrato, no solo porque todas reciban algo parecido a una fila.
Esta separación también facilita comprobar el comportamiento. Podemos probar RejectNegativePrice con tres filas: -1, 0 y 1 céntimo. No hace falta preparar un archivo completo ni una base de datos.
Guardar es otra responsabilidad
Los filtros calculan y no escriben fuera. Si procesamos dos veces las mismas filas, obtenemos el mismo informe. Guardar productos, en cambio, modifica el estado del catálogo, así que lo dejamos para una pieza final que recibe las filas aceptadas:
class ProductCatalog {
    private final Map<String, Integer> pricesBySku = new HashMap<>();

    public void save(ProductRow row) {
        pricesBySku.put(row.getSku(), row.getPriceInCents());
    }

    public Integer findPrice(String sku) {
        return pricesBySku.get(sku);
    }
}
ProductCatalog catalog = new ProductCatalog();
for (ProductRow row : report.getAccepted()) {
    catalog.save(row);
}

catalog.findPrice("BOOK-01"); // 1999
catalog.findPrice("BOOK-02"); // null: it was rejected
put() guarda el precio con la referencia como clave. Si la referencia ya existe, sustituye el valor anterior. Gracias a eso, repetir la importación del mismo archivo no duplica productos: el catálogo termina igual. Este catálogo vive en memoria y desaparece al cerrar el programa; una base de datos real necesitaría la misma decisión, expresada con una clave única.
Separar el cálculo de los efectos también nos permite montar una previsualización: ejecutar la tubería, enseñar el informe y no llamar a save() hasta que alguien confirme. Con todo en el mismo bucle, esa función pediría duplicar la lógica o añadir un parámetro dryRun por todas partes.
Si el proceso se interrumpe después de guardar 500 filas, la recuperación ya es un problema de estado y no de transformación. Habrá que decidir si se confirma el archivo completo o por lotes, y cómo sabemos qué quedó guardado. Un contador en memoria no sirve como prueba: desaparece con el proceso.
Cuándo encaja este estilo
La tubería encaja cuando el trabajo se puede describir como una secuencia de transformaciones sobre un dato: importaciones, conversiones de formato, preparación de textos o procesamiento de imágenes. Cada etapa se entiende, se prueba y se reutiliza por separado.
Encaja peor cuando lo importante es un estado que cambia durante mucho tiempo y puede fallar a medias, como una compra que espera un pago y quizá tenga que deshacerse. Convertir ese proceso en una lista de filtros escondería precisamente lo difícil.
Para revisar una tubería, elige una fila rechazada y recórrela de principio a fin. Deberías poder señalar dónde cambió, qué condición incumplió y qué se guardó. Si esa explicación cabe en tres frases, las etapas están cumpliendo su trabajo.