Una persona busca «Quiero dar de baja mi inscripción». El documento que necesita dice «Puedes cancelar tu matrícula escribiendo a secretaría». Hablan de lo mismo con palabras distintas. Un buscador que solo cuente coincidencias puede pasar por alto ese texto y elegir otro que comparte una palabra poco útil, como «de».
Podemos abordar el problema utilizando un modelo que transforme cada texto en una representación numérica. Hacemos lo mismo con la consulta y comparamos sus representaciones. El objetivo es encontrar textos relacionados por su significado aunque no repitan las mismas palabras.
El recorrido es pequeño:
- Obtener una representación numérica de cada texto que queremos buscar.
- Obtener la de la consulta con el mismo modelo.
- Compararlas y elegir la más similar.
- Devolver el texto original que corresponde a esa representación.
Vamos a hacerlo en Python con tres textos. El modelo se ejecutará en nuestro equipo y devolverá números; no redactará una respuesta ni realizará una baja.
Una consulta y tres textos
Este será nuestro conjunto de documentos ficticios:
| Tema | Texto |
|---|---|
| Cancelación de matrícula | Puedes cancelar tu matrícula escribiendo a secretaría. |
| Horario | La biblioteca abre de lunes a viernes, de nueve a veinte horas. |
| Equipamiento | Las aulas disponen de proyector y conexión wifi. |
La consulta es «Quiero dar de baja mi inscripción». El texto que buscamos es el primero: indica cómo solicitar la cancelación. Al ejecutar el ejemplo de este artículo, ese es el resultado que se obtiene:
Puedes cancelar tu matrícula escribiendo a secretaría.
El buscador ha localizado una fuente. Todavía no ha comprobado la situación de una persona ni ha redactado una respuesta adaptada a su caso. Para entender cómo ha elegido ese texto, abramos ahora la representación y la comparación.
Qué es un embedding
Un embedding es una representación de un texto mediante una lista ordenada de números, llamada vector. Un modelo entrenado para comparar textos intenta situar cerca las representaciones de contenidos relacionados. La cercanía útil depende de cómo se haya entrenado y de las consultas con las que lo utilicemos.
Para este ejemplo usaremos intfloat/multilingual-e5-small, un modelo multilingüe que genera vectores de 384 componentes. Al representar nuestra consulta, las primeras cuatro componentes obtenidas fueron, redondeadas:
[0.0331, 0.0061, 0.0044, -0.0750, ...]
Los puntos indican que faltan otras 380 componentes; el programa utiliza las 384. No hemos asignado manualmente un número a «cancelar» y otro a «horario». Esas componentes son el resultado del modelo y trabajan juntas. No conviene interpretar cada una como una categoría comprensible por separado.
La consulta y los documentos deben representarse con un modelo y una configuración compatibles. Tener dos listas de 384 números no basta para poder compararlas si proceden de modelos diferentes: sus posiciones pueden representar relaciones distintas.
Esta forma de representar y recuperar textos permite construir búsqueda semántica. La documentación de Sentence Transformers explica el recorrido de representar documentos y consultas para recuperar los más próximos.
Comparar las representaciones
Utilizaremos la similitud del coseno, que compara la orientación de dos vectores. Podemos pensar en ellos como direcciones en un espacio numérico: cuanto más alineadas están, mayor es el coseno. No necesitamos interpretar una por una sus componentes para calcularlo.
Su valor está entre −1 y 1. Para ordenar candidatos, un valor mayor indica más similitud según esta medida y este modelo. No es un porcentaje de verdad ni de confianza.
Estas son las puntuaciones obtenidas al ejecutar el ejemplo en local, redondeadas a tres decimales:
| Texto identificado por su tema | Similitud con la consulta |
|---|---|
| Cancelación de matrícula | 0.878 |
| Horario | 0.810 |
| Equipamiento | 0.797 |
Elegimos el primero porque tiene la puntuación más alta. El contraste con la búsqueda sencilla por palabras es útil: el texto de cancelación no comparte ninguna palabra con la consulta; los otros dos comparten «de». La representación aprendida aporta una relación que ese recuento no tenía.
Incluso los textos poco pertinentes reciben puntuaciones relativamente altas. Por eso no podemos convertir 0.810 en «un 81 % de probabilidad de que responda bien». La escala depende del modelo y del tipo de textos. Estos tres resultados muestran un caso concreto, no una evaluación general de su calidad.
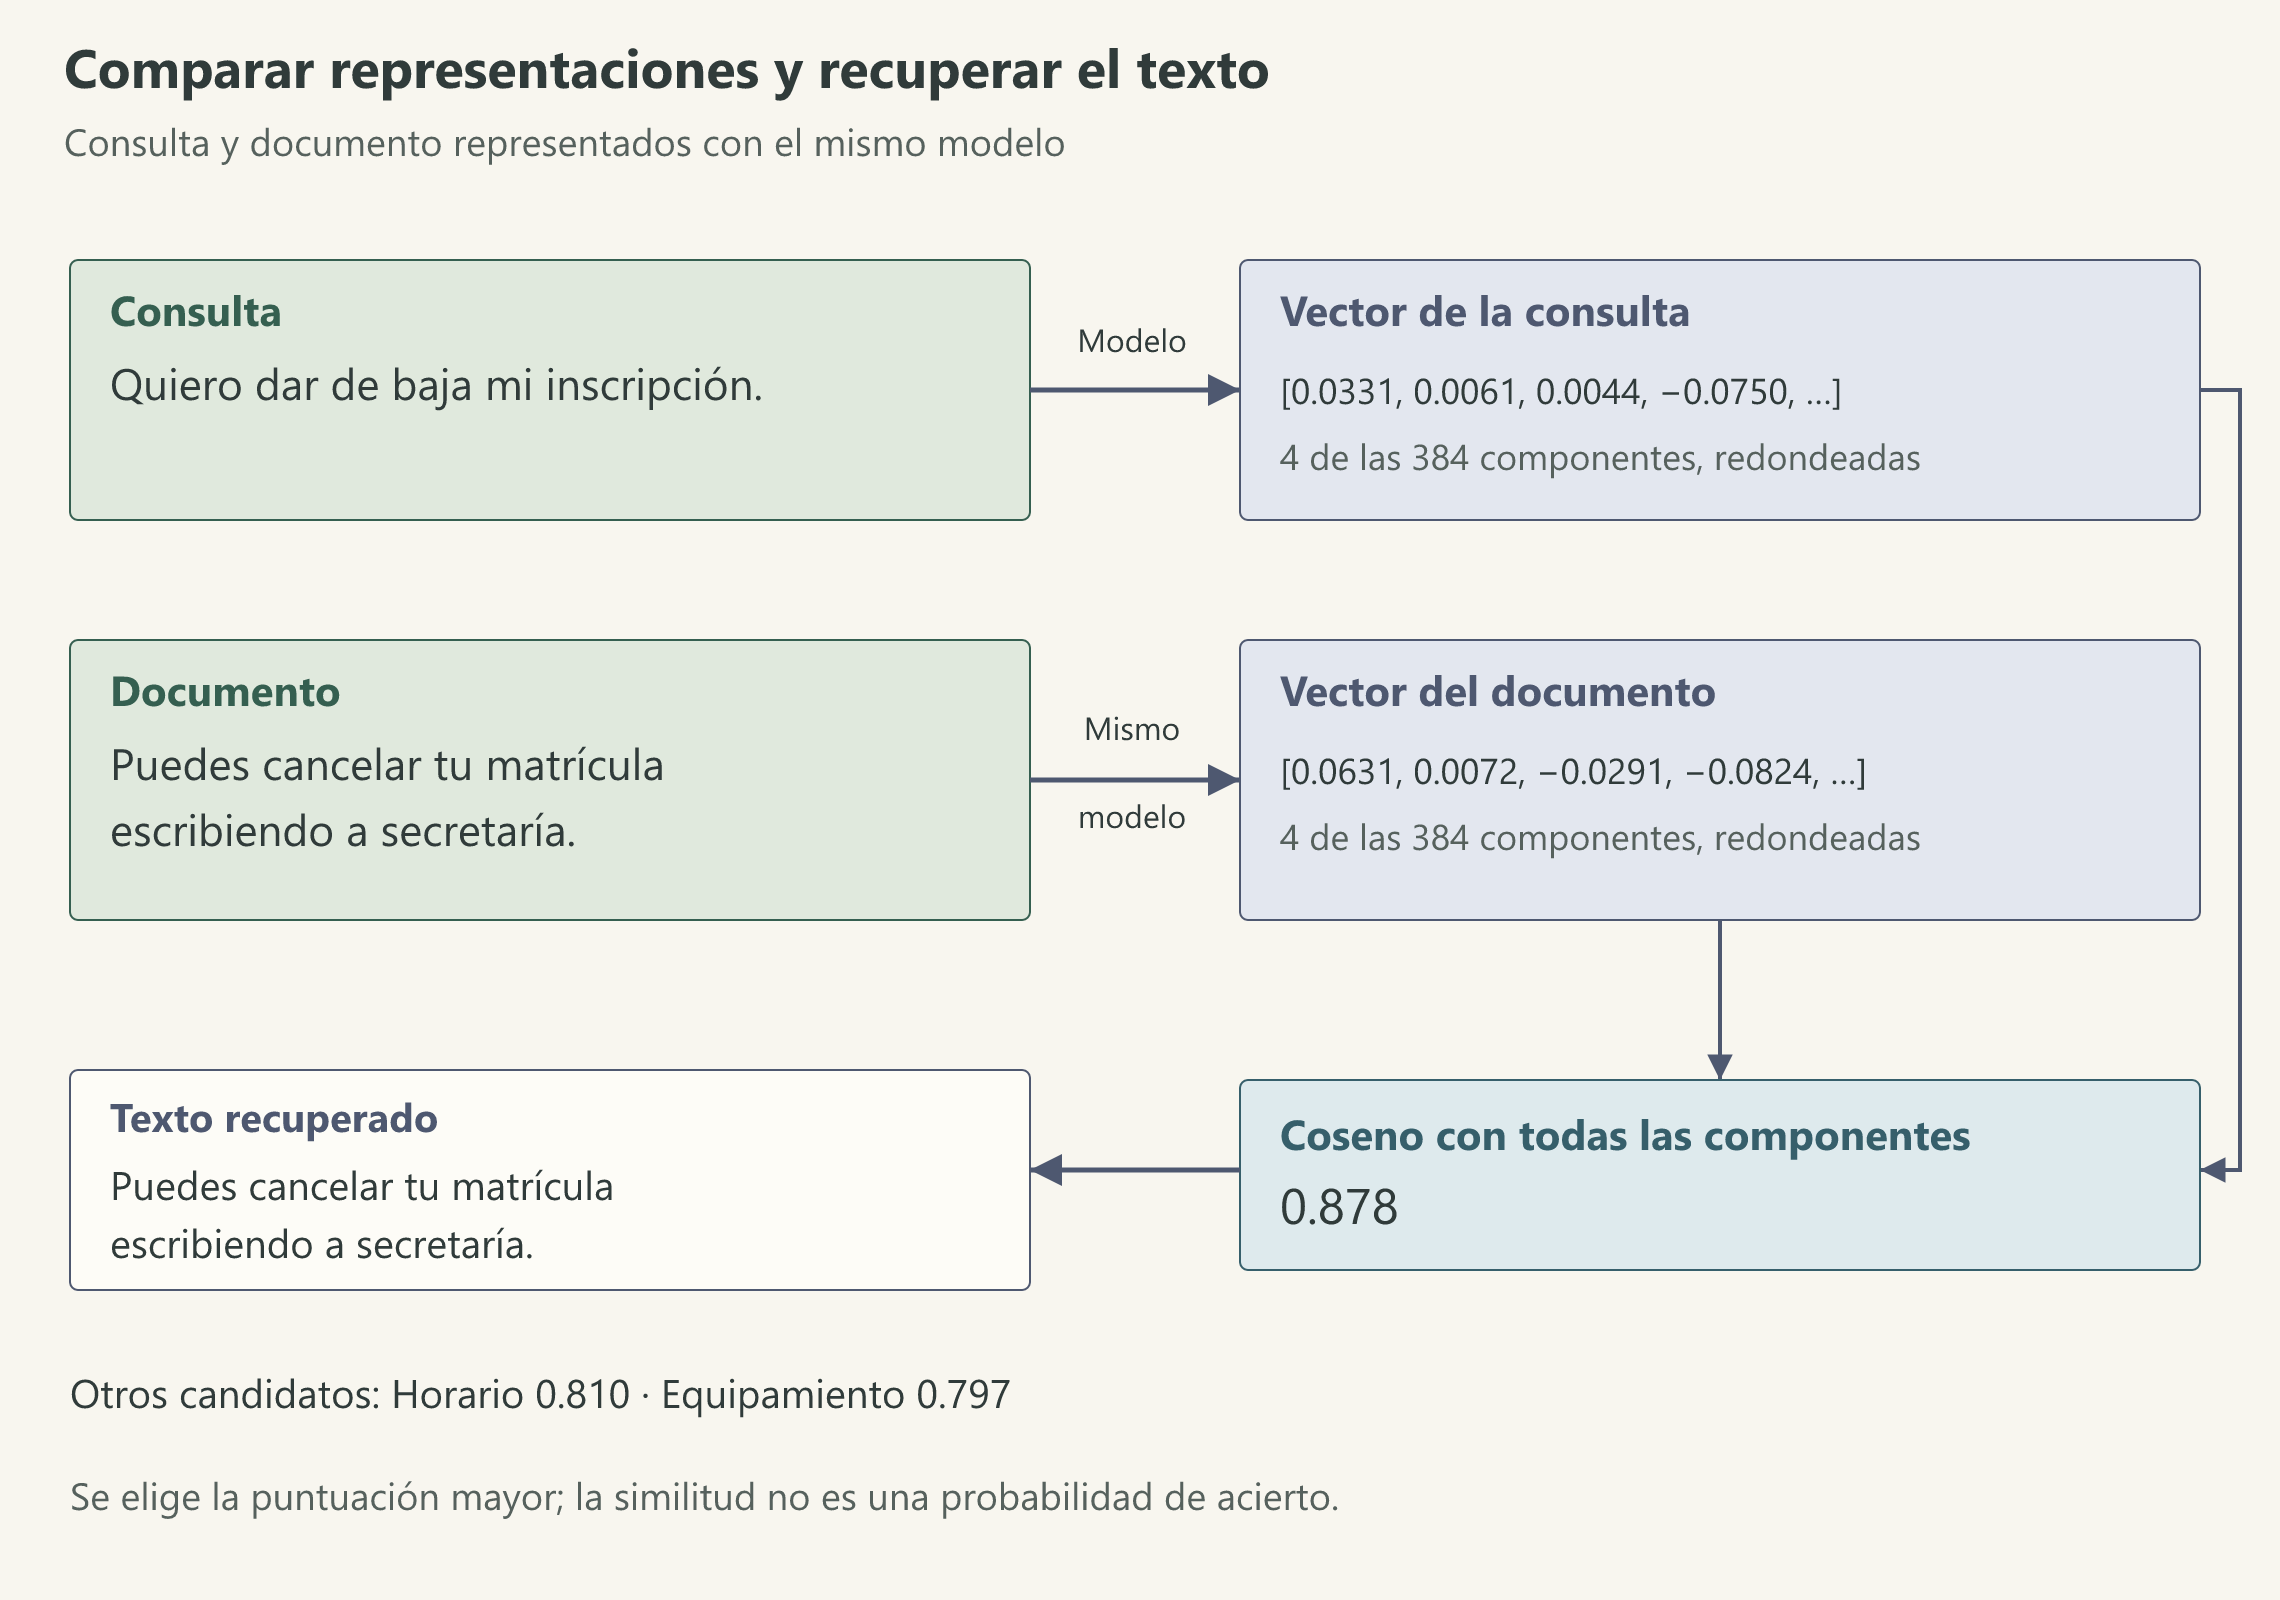
Ver el diagrama a tamaño completo.

La figura muestra fragmentos de los vectores reales del ejemplo. La comparación utiliza todas sus componentes y el resultado se vincula al texto del que salió el vector.
Obtener los embeddings en Python
Necesitamos el paquete sentence-transformers, que permite cargar el modelo y representar los textos. La primera carga descarga sus archivos; después puede reutilizarlos desde la caché local. No necesita una clave de una API para ejecutar este modelo público en el equipo.
Empezamos con los mismos tres textos, en el mismo orden:
from sentence_transformers import SentenceTransformer

passages = [
    "Puedes cancelar tu matrícula escribiendo a secretaría.",
    "La biblioteca abre de lunes a viernes, de nueve a veinte horas.",
    "Las aulas disponen de proyector y conexión wifi.",
]

model = SentenceTransformer(
    "intfloat/multilingual-e5-small",
    similarity_fn_name="cosine",
)
SentenceTransformer carga el modelo. Con similarity_fn_name="cosine" elegimos la medida que acabamos de explicar. La lista passages conserva los textos originales: los necesitaremos para devolver el resultado.
Este modelo E5 utiliza el prefijo passage: para los documentos y query: para las consultas, también cuando el contenido está en español. Son indicaciones de cómo debe tratar cada entrada. Seguimos esa convención de su ficha oficial; no es una regla universal para todos los modelos de embeddings.
passage_inputs = []
for text in passages:
    passage_inputs.append("passage: " + text)

passage_vectors = model.encode(passage_inputs)

query = "Quiero dar de baja mi inscripción."
query_vector = model.encode("query: " + query)
encode transforma las entradas en arrays numéricos. passage_vectors contiene tres filas, una por texto, y 384 números en cada fila. La primera corresponde a cancelación, la segunda a horario y la tercera a equipamiento. query_vector contiene los 384 números de la consulta.
Añadir el prefijo no modifica nuestra colección original. passages sigue conteniendo las frases que queremos mostrar, sin esas marcas técnicas.
Elegir el texto y devolverlo
Ahora comparamos el vector de la consulta con los tres vectores de los documentos:
scores = model.similarity(query_vector, passage_vectors)[0]
best_index = int(scores.argmax())
result = passages[best_index]

print(result)
similarity devuelve una fila de puntuaciones por consulta. Como solo tenemos una, [0] toma esa fila: contiene los tres valores de la tabla. argmax encuentra la posición de la puntuación mayor; int la convierte en un entero que podemos usar como índice.
En esta ejecución la posición elegida es 0, la del primer texto. passages[best_index] recupera la frase original e imprime:
Puedes cancelar tu matrícula escribiendo a secretaría.
El vector ha servido para comparar. El resultado útil para la persona, o para un LLM que vaya a redactar con esa información, es el texto asociado. Guardar únicamente los números sin mantener esa relación nos impediría recuperar el contenido.
Qué reutilizar y qué comprobar
Los embeddings de los documentos pueden calcularse cuando preparamos la colección y reutilizarse en varias búsquedas. Cada consulta nueva necesita su propia representación. Con estos tres textos basta con conservar los arrays en memoria; no necesitamos introducir una base vectorial para observar el mecanismo.
Si cambia un documento, actualizamos su representación. Si cambiamos el modelo o su configuración, debemos mantener compatibles los vectores con los que vamos a comparar. No podemos sustituir solo el modelo de consultas y dar por hecho que seguirá funcionando con el índice anterior.
También hay un límite importante en el código: siempre escoge el mejor de los tres candidatos. Si preguntamos algo que ninguno responde, seguirá existiendo una puntuación máxima. Elegir el mayor valor no demuestra que haya información suficiente. Para decidir cuándo aceptar o rechazar resultados necesitamos casos representativos, incluidos ejemplos sin respuesta, y criterios medidos para esa colección.
La semejanza tampoco garantiza que un texto respalde una afirmación: «se permite cancelar» y «no se permite cancelar» pueden estar muy relacionados en tema. Hay que leer el contenido y sus condiciones.
En nuestro caso, la búsqueda encuentra una instrucción sobre cancelación utilizando una consulta redactada de otra manera. Esa es la aportación del embedding. Confirmar que la norma está vigente y que responde a la petición concreta sigue requiriendo examinar la fuente recuperada.