Buscas cómo «anular una inscripción» y el documento habla de «cancelar una matrícula». La búsqueda semántica puede reconocer esa relación. Pero la consulta incluye también MAT-17, un código que conviene localizar literalmente. Para ese detalle, la búsqueda por palabras sigue teniendo mucho que aportar.
Podemos utilizar las dos: buscar coincidencias de palabras y buscar textos con significado relacionado. Cada búsqueda produce una lista ordenada. Después reunimos sus candidatos y calculamos un orden común, conservando el texto original de cada resultado. Esta combinación se conoce como búsqueda híbrida.
La dificultad está en decidir ese orden. Un recuento de palabras y una similitud entre vectores miden cosas distintas. Sumarlos sin más puede dar ventaja al buscador cuya escala tenga números mayores.
Vamos a combinar las posiciones de los resultados en vez de sumar sus puntuaciones. Primero veremos un caso completo; después lo llevaremos a Python.
Dos búsquedas sobre los mismos textos
La consulta será «anular inscripción MAT-17». Tenemos estos tres textos ficticios:
| Id | Texto |
|---|---|
| A | MAT-17: antes de tramitar la baja, revisa los recibos pendientes con administración. |
| B | Para cancelar tu matrícula y pedir la devolución, envía una solicitud a secretaría. |
| C | MAT-17: consulta el estado de esta incidencia en el portal de soporte. |
Las letras identifican los textos y permiten reconocer el mismo resultado en las dos listas. MAT-17 es el código mencionado en la consulta y en los documentos, no su identificador dentro del programa.
Trabajaremos con dos listas ilustrativas de candidatos. Son datos preparados para explicar la combinación, no resultados medidos con un modelo concreto:
| Posición | Búsqueda por palabras | Búsqueda semántica |
|---|---|---|
| 1 | A | B |
| 2 | C | A |
La primera lista aporta textos que contienen el código. La segunda aporta el procedimiento de cancelación aunque utilice otras palabras. Cada buscador devuelve como máximo dos candidatos; por eso un texto puede faltar en una lista y aparecer en la otra.
Al reunirlas tenemos A, B y C. A aparece en ambas; B llega por la búsqueda semántica y C por la búsqueda por palabras. Queremos conservar cada texto una sola vez y ordenar estos candidatos teniendo en cuenta las dos listas.
En este ejemplo, el resultado final será A, B y C. Si nos quedamos con los dos primeros, recuperamos tanto la condición sobre los recibos pendientes como el procedimiento general de cancelación:
MAT-17: antes de tramitar la baja, revisa los recibos pendientes con administración.
Para cancelar tu matrícula y pedir la devolución, envía una solicitud a secretaría.
Son fuentes para consultar. El programa todavía no ha comprobado los recibos de nadie ni ha ejecutado una cancelación.
Dar puntos por posición
Usaremos Reciprocal Rank Fusion, normalmente abreviado como RRF. Cada lista aporta puntos a los textos que contiene según su posición. Sumamos esas aportaciones y ordenamos el total de mayor a menor.
La aportación tiene esta forma: 1 / (constante + posición). Las posiciones empiezan en 1. Si un texto no aparece en una lista, esa lista aporta cero para él. La documentación de Elasticsearch recoge este cálculo.
Elegiremos una constante de 1 para que las cuentas se puedan seguir con facilidad. Así, estar primero aporta 1 / (1 + 1) = 0.5; estar segundo aporta 1 / (1 + 2) ≈ 0.3333.
Aplicado a nuestras listas:
| Texto | Aportación por palabras | Aportación semántica | Total RRF |
|---|---|---|---|
| A | 0.5, por estar primero | 0.3333, por estar segundo | 0.8333 |
| B | 0, no aparece | 0.5, por estar primero | 0.5 |
| C | 0.3333, por estar segundo | 0, no aparece | 0.3333 |
A queda primero por su presencia destacada en las dos listas. B queda segundo y C, tercero. Las cuentas utilizan las fracciones completas; solo redondeamos al mostrarlas.
RRF conserva el orden que aporta cada buscador, pero descarta la distancia entre sus puntuaciones originales. Dos resultados muy próximos y dos muy separados reciben las mismas aportaciones si ocupan las mismas posiciones. Es una decisión del método, no una prueba de que las puntuaciones originales sean inútiles. La documentación de OpenSearch explica esa diferencia frente a combinar puntuaciones normalizadas, es decir, ajustadas para hacer comparables sus escalas.
La constante también cambia cuánto pesan las diferencias entre posiciones. El 1 de estas cuentas facilita leerlas; no es una recomendación universal. En las variantes de RRF que mantienen este cálculo, una constante mayor reduce la ventaja relativa de los primeros puestos. En una colección real hay que comprobar qué configuración funciona con sus consultas.
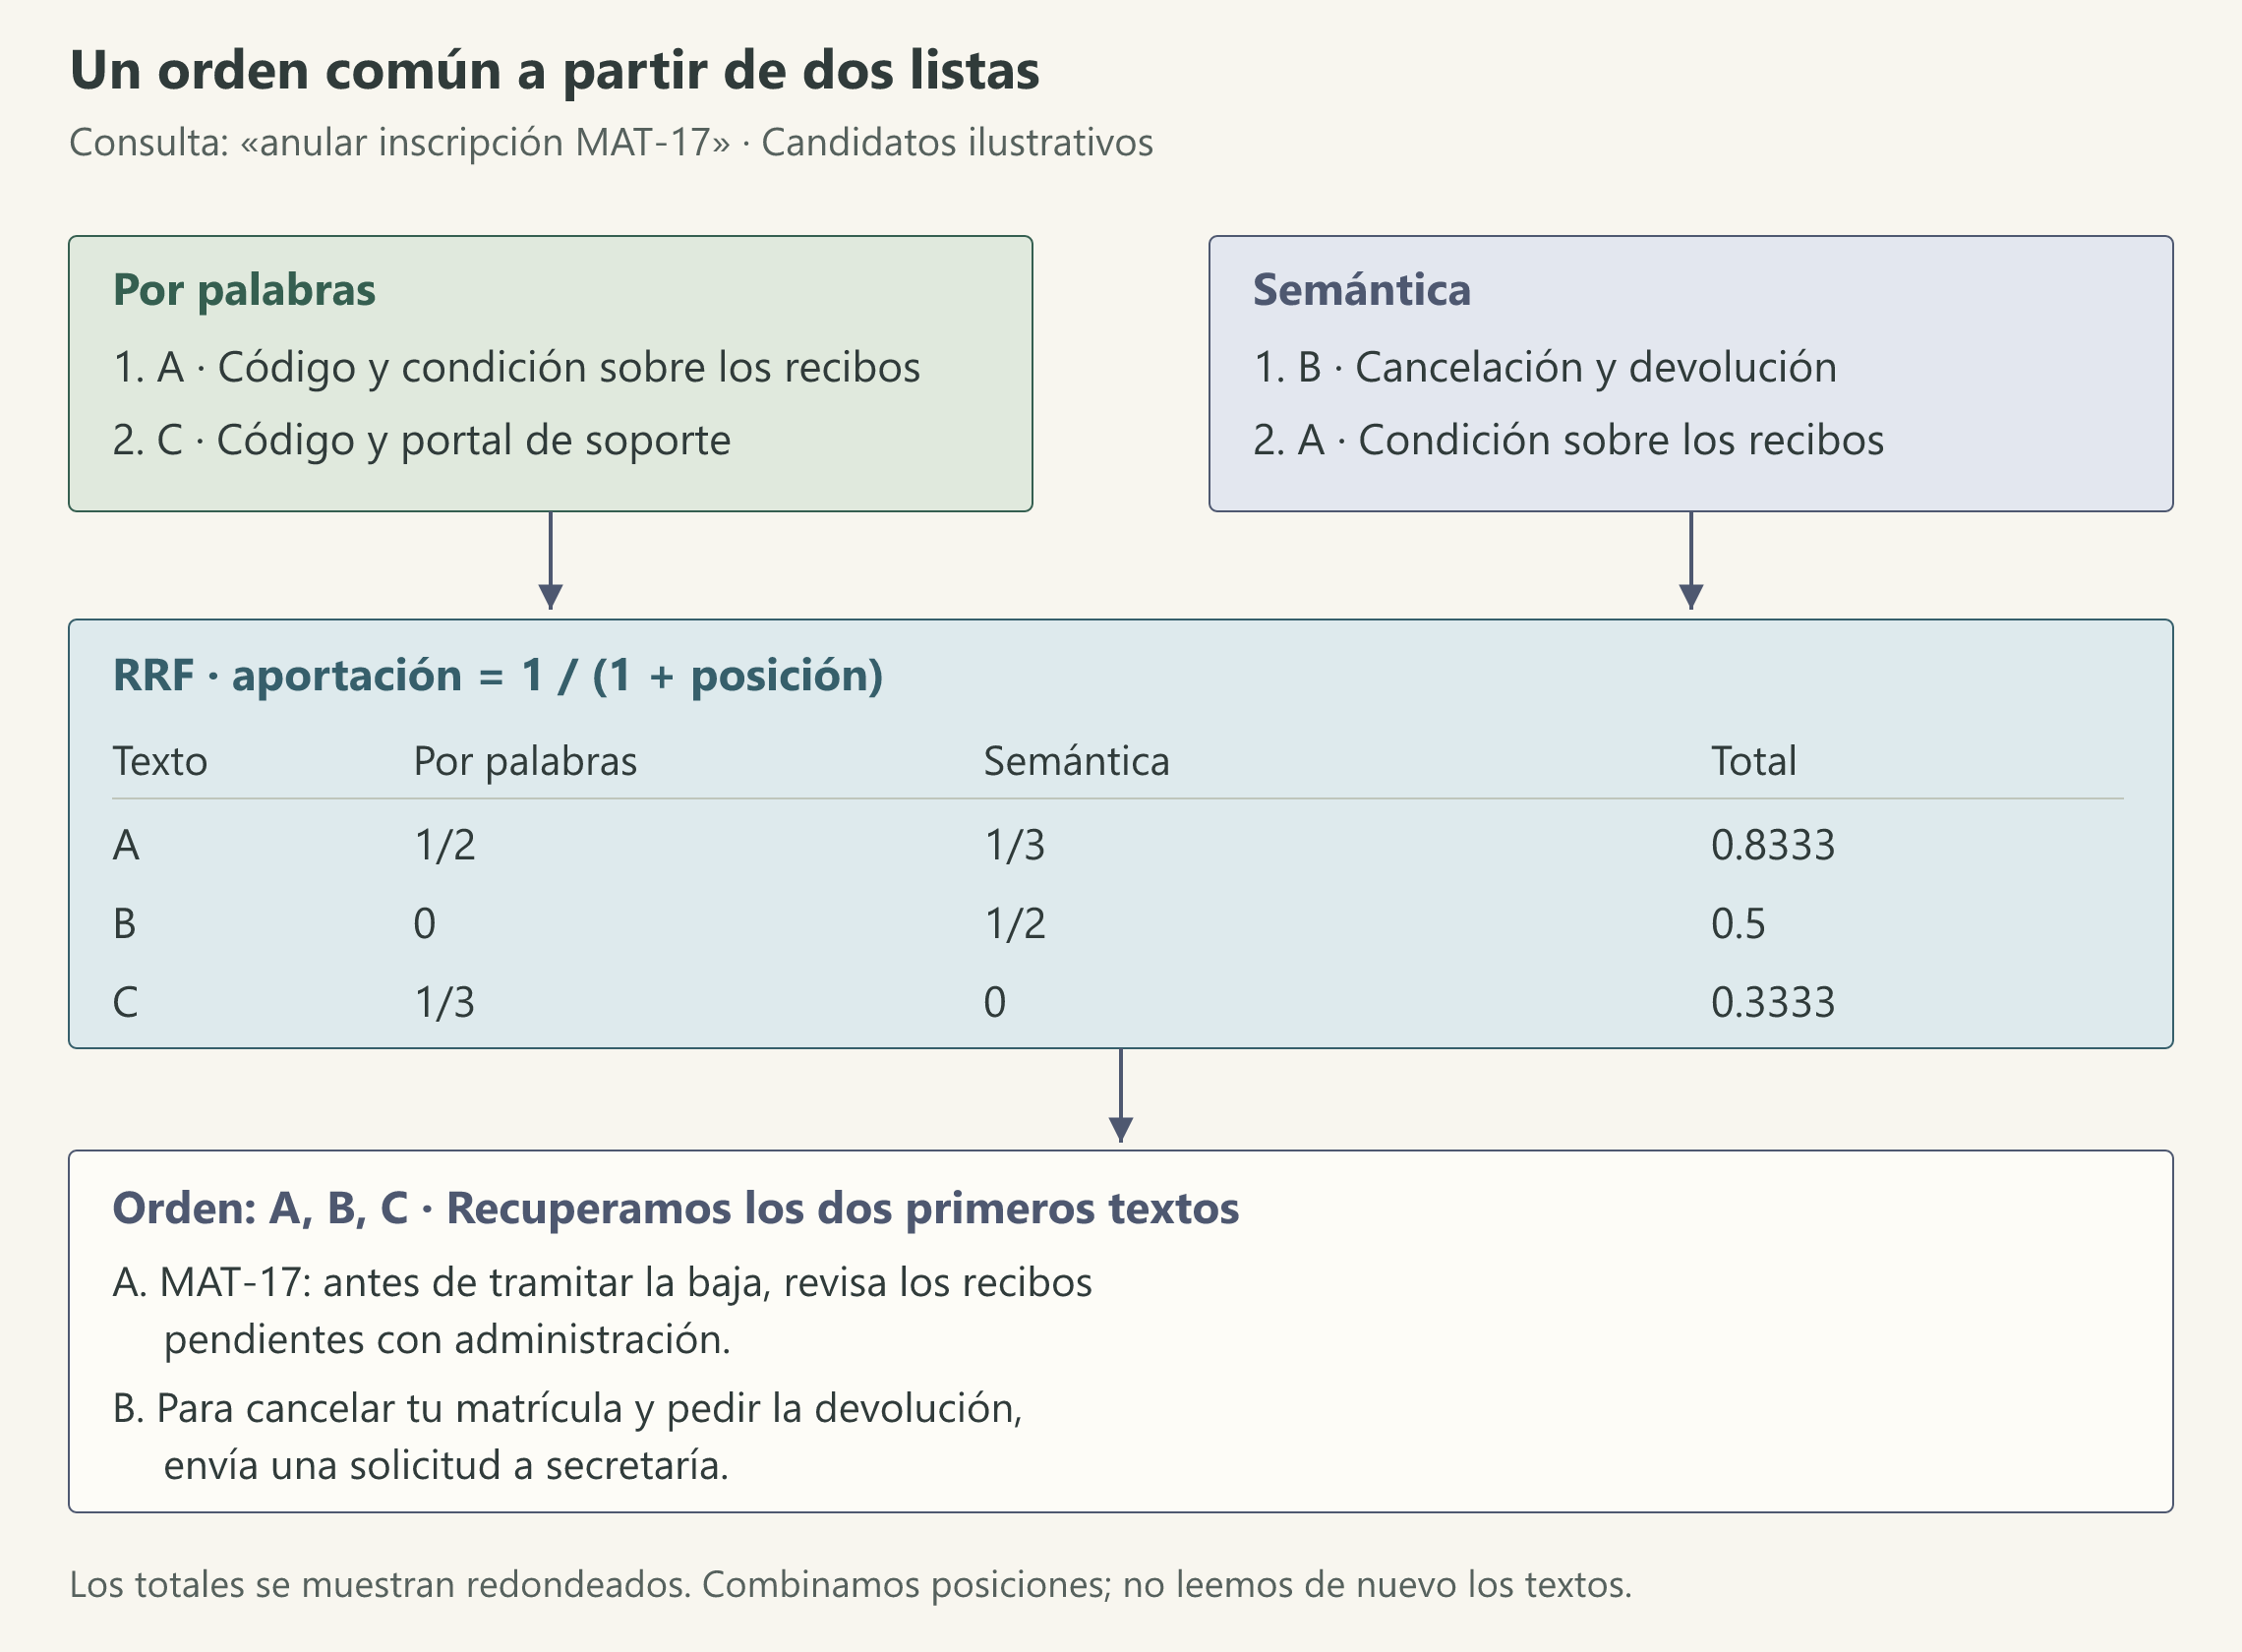
Ver el diagrama a tamaño completo.

Las dos listas de la figura son las entradas de la combinación. La tabla central permite seguir cada aportación; el bloque final muestra los textos recuperados, no solo sus identificadores.
Combinar las listas en Python
El código se centra en esa operación. Preparamos los textos y las dos listas anteriores; no volvemos a implementar aquí los buscadores. Un buscador por palabras podría utilizar BM25, una medida que considera la frecuencia de los términos, su presencia en la colección y la longitud de los documentos. El semántico podría comparar embeddings como en el ejemplo de búsqueda semántica.
passages = {
    "A": (
        "MAT-17: antes de tramitar la baja, revisa los recibos "
        "pendientes con administración."
    ),
    "B": (
        "Para cancelar tu matrícula y pedir la devolución, "
        "envía una solicitud a secretaría."
    ),
    "C": (
        "MAT-17: consulta el estado de esta incidencia "
        "en el portal de soporte."
    ),
}

keyword_ranking = ["A", "C"]
semantic_ranking = ["B", "A"]
La posición de cada ID en su lista expresa el orden del buscador. Las dos listas usan los mismos identificadores que passages, donde conservamos el contenido original.
La siguiente función recibe esas listas y devuelve los identificadores ordenados por su total RRF. Su contrato presupone que cada lista contiene IDs únicos; el mismo ID sí puede aparecer en listas distintas.
def fuse_rankings(rankings: list[list[str]]) -> list[str]:
    """Combine unique IDs from each ranking using reciprocal ranks."""
    rank_constant = 1
    scores: dict[str, float] = {}

    for ranking in rankings:
        for position, passage_id in enumerate(ranking, start=1):
            contribution = 1 / (rank_constant + position)
            scores[passage_id] = scores.get(passage_id, 0.0) + contribution

    def sorting_key(passage_id: str) -> tuple[float, str]:
        return (-scores[passage_id], passage_id)

    return sorted(scores, key=sorting_key)
enumerate(..., start=1) recorre cada lista junto con sus posiciones, empezando en 1. El diccionario scores acumula las aportaciones: A ocupa una sola entrada aunque reciba puntos de dos listas.
Para ordenar de mayor a menor usamos el total con signo negativo. Si hay empate, el ID fija un orden estable; ese desempate no añade información sobre relevancia. En nuestras cuentas no hay empates.
Finalmente elegimos dos resultados y recuperamos sus textos:
ranked_ids = fuse_rankings([keyword_ranking, semantic_ranking])
selected_ids = ranked_ids[:2]

for passage_id in selected_ids:
    print(passages[passage_id])
ranked_ids contiene ["A", "B", "C"]. El corte [:2] conserva A y B, y el bucle imprime los dos textos mostrados al principio. Elegir dos candidatos por buscador y mostrar dos resultados finales son decisiones distintas: aquí coinciden sus cantidades para mantener pequeño el ejemplo.
Fusionar y volver a evaluar son operaciones distintas
La fusión solo utiliza posiciones. No vuelve a leer la consulta ni el contenido para decidir si una frase responde mejor que otra.
Un reranker sí puede hacer esa segunda evaluación. Por ejemplo, un modelo de tipo cross-encoder recibe conjuntamente la consulta y cada texto candidato, calcula una puntuación para cada pareja y permite ordenarlas de nuevo. La documentación de Sentence Transformers describe este recorrido de recuperar primero y reevaluar después.
Así se relacionan las piezas: los buscadores encuentran candidatos, la fusión reúne sus señales de orden y un reranker opcional examina las parejas consulta-texto. Este último necesita una evaluación por pareja; aplicarlo a una selección pequeña evita hacerlo sobre toda la colección. No lo estamos ejecutando en el código anterior.
Hay un límite compartido: si un texto queda fuera de todos los candidatos iniciales, ni la fusión ni el reranker de esa selección podrán recuperarlo. También pueden colocar arriba textos poco útiles. Una puntuación RRF expresa una combinación de posiciones, no la probabilidad de que una respuesta sea correcta.
En nuestro caso hemos conservado una condición específica y un procedimiento general. Para saber si la combinación mejora un buscador real, necesitamos consultas representativas y revisar los textos que devuelve cada alternativa. Añadir una segunda búsqueda amplía las señales disponibles; que esas señales ayuden se comprueba con los resultados.