En un prospecto de un medicamento puede aparecer «Tome un comprimido cada ocho horas» y, en el párrafo siguiente, «En menores de doce años, consulte a su médico antes de usarlo». En una política de devoluciones, «Dispone de treinta días para devolver el producto» va seguido de «salvo en artículos personalizados». En un contrato, una cláusula de desistimiento suele tener su excepción unas líneas más abajo.
Si un asistente de IA busca en esos documentos y solo recupera la primera frase, responderá con una regla incompleta. Y lo hará con mucha seguridad, porque lo que ha leído es cierto. Lo que falta es justo la condición que cambia la respuesta.
Este problema aparece en cualquier aplicación que responda con documentos propios: atención al cliente con las condiciones de venta, asistentes internos con la normativa de la empresa o buscadores de documentación técnica. Lo habitual es partir los documentos en trozos para buscar, como vimos al preparar documentos en fragmentos con su origen, y cualquier corte puede dejar una regla a medias.
Lo veremos con un caso pequeño. Buscamos cómo cancelar una reserva de sala y encontramos esta frase: «Una reserva puede cancelarse hasta veinticuatro horas antes». Justo debajo había otro párrafo: si falta menos tiempo, debe solicitarse la cancelación en recepción. El buscador ha localizado la regla y ha dejado fuera su excepción. Si alguien tiene la reserva dentro de diez horas, el asistente le diría que ya no puede cancelar, cuando lo que debe hacer es ir a recepción.
¿Por qué no buscar directamente en apartados enteros? Porque un trozo pequeño se parece más a una pregunta concreta. Un apartado largo mezcla varios temas, y la parte que nos interesa pesa menos al compararlo con la consulta. La guía de LlamaIndex para RAG en producción lo plantea así: el trozo que mejor sirve para buscar no tiene por qué ser el que mejor sirve para responder.
La solución consiste en separar dos decisiones: qué tamaño de texto usamos para buscar y qué contenido devolvemos después. Buscamos entre fragmentos pequeños y guardamos en cada uno una referencia al apartado al que pertenece. Cuando encontramos un fragmento, seguimos esa referencia y devolvemos el apartado completo, con su regla y su excepción.
Lo haremos con LlamaIndex, una biblioteca de Python pensada para conectar documentos con aplicaciones de IA: incluye lectores para muchos formatos y fuentes, formas de partir los textos y distintos tipos de búsqueda. El ejemplo se detendrá en los textos recuperados: no llamaremos a un modelo para redactar una respuesta.
El manual del ejemplo
Nuestro manual ficticio room_rules.md contiene dos apartados:
## Cancelaciones
Una reserva puede cancelarse hasta veinticuatro horas antes.

Si faltan menos de veinticuatro horas, debe solicitarse la cancelación en recepción.

## Horario
El centro abre de lunes a viernes, de nueve a veinte horas.
Queremos que la consulta cancelar reserva encuentre el párrafo que mejor coincide y que la aplicación devuelva el apartado Cancelaciones completo. Antes de recorrer la búsqueda, veamos cómo guarda LlamaIndex este manual.
Cómo organiza LlamaIndex el manual
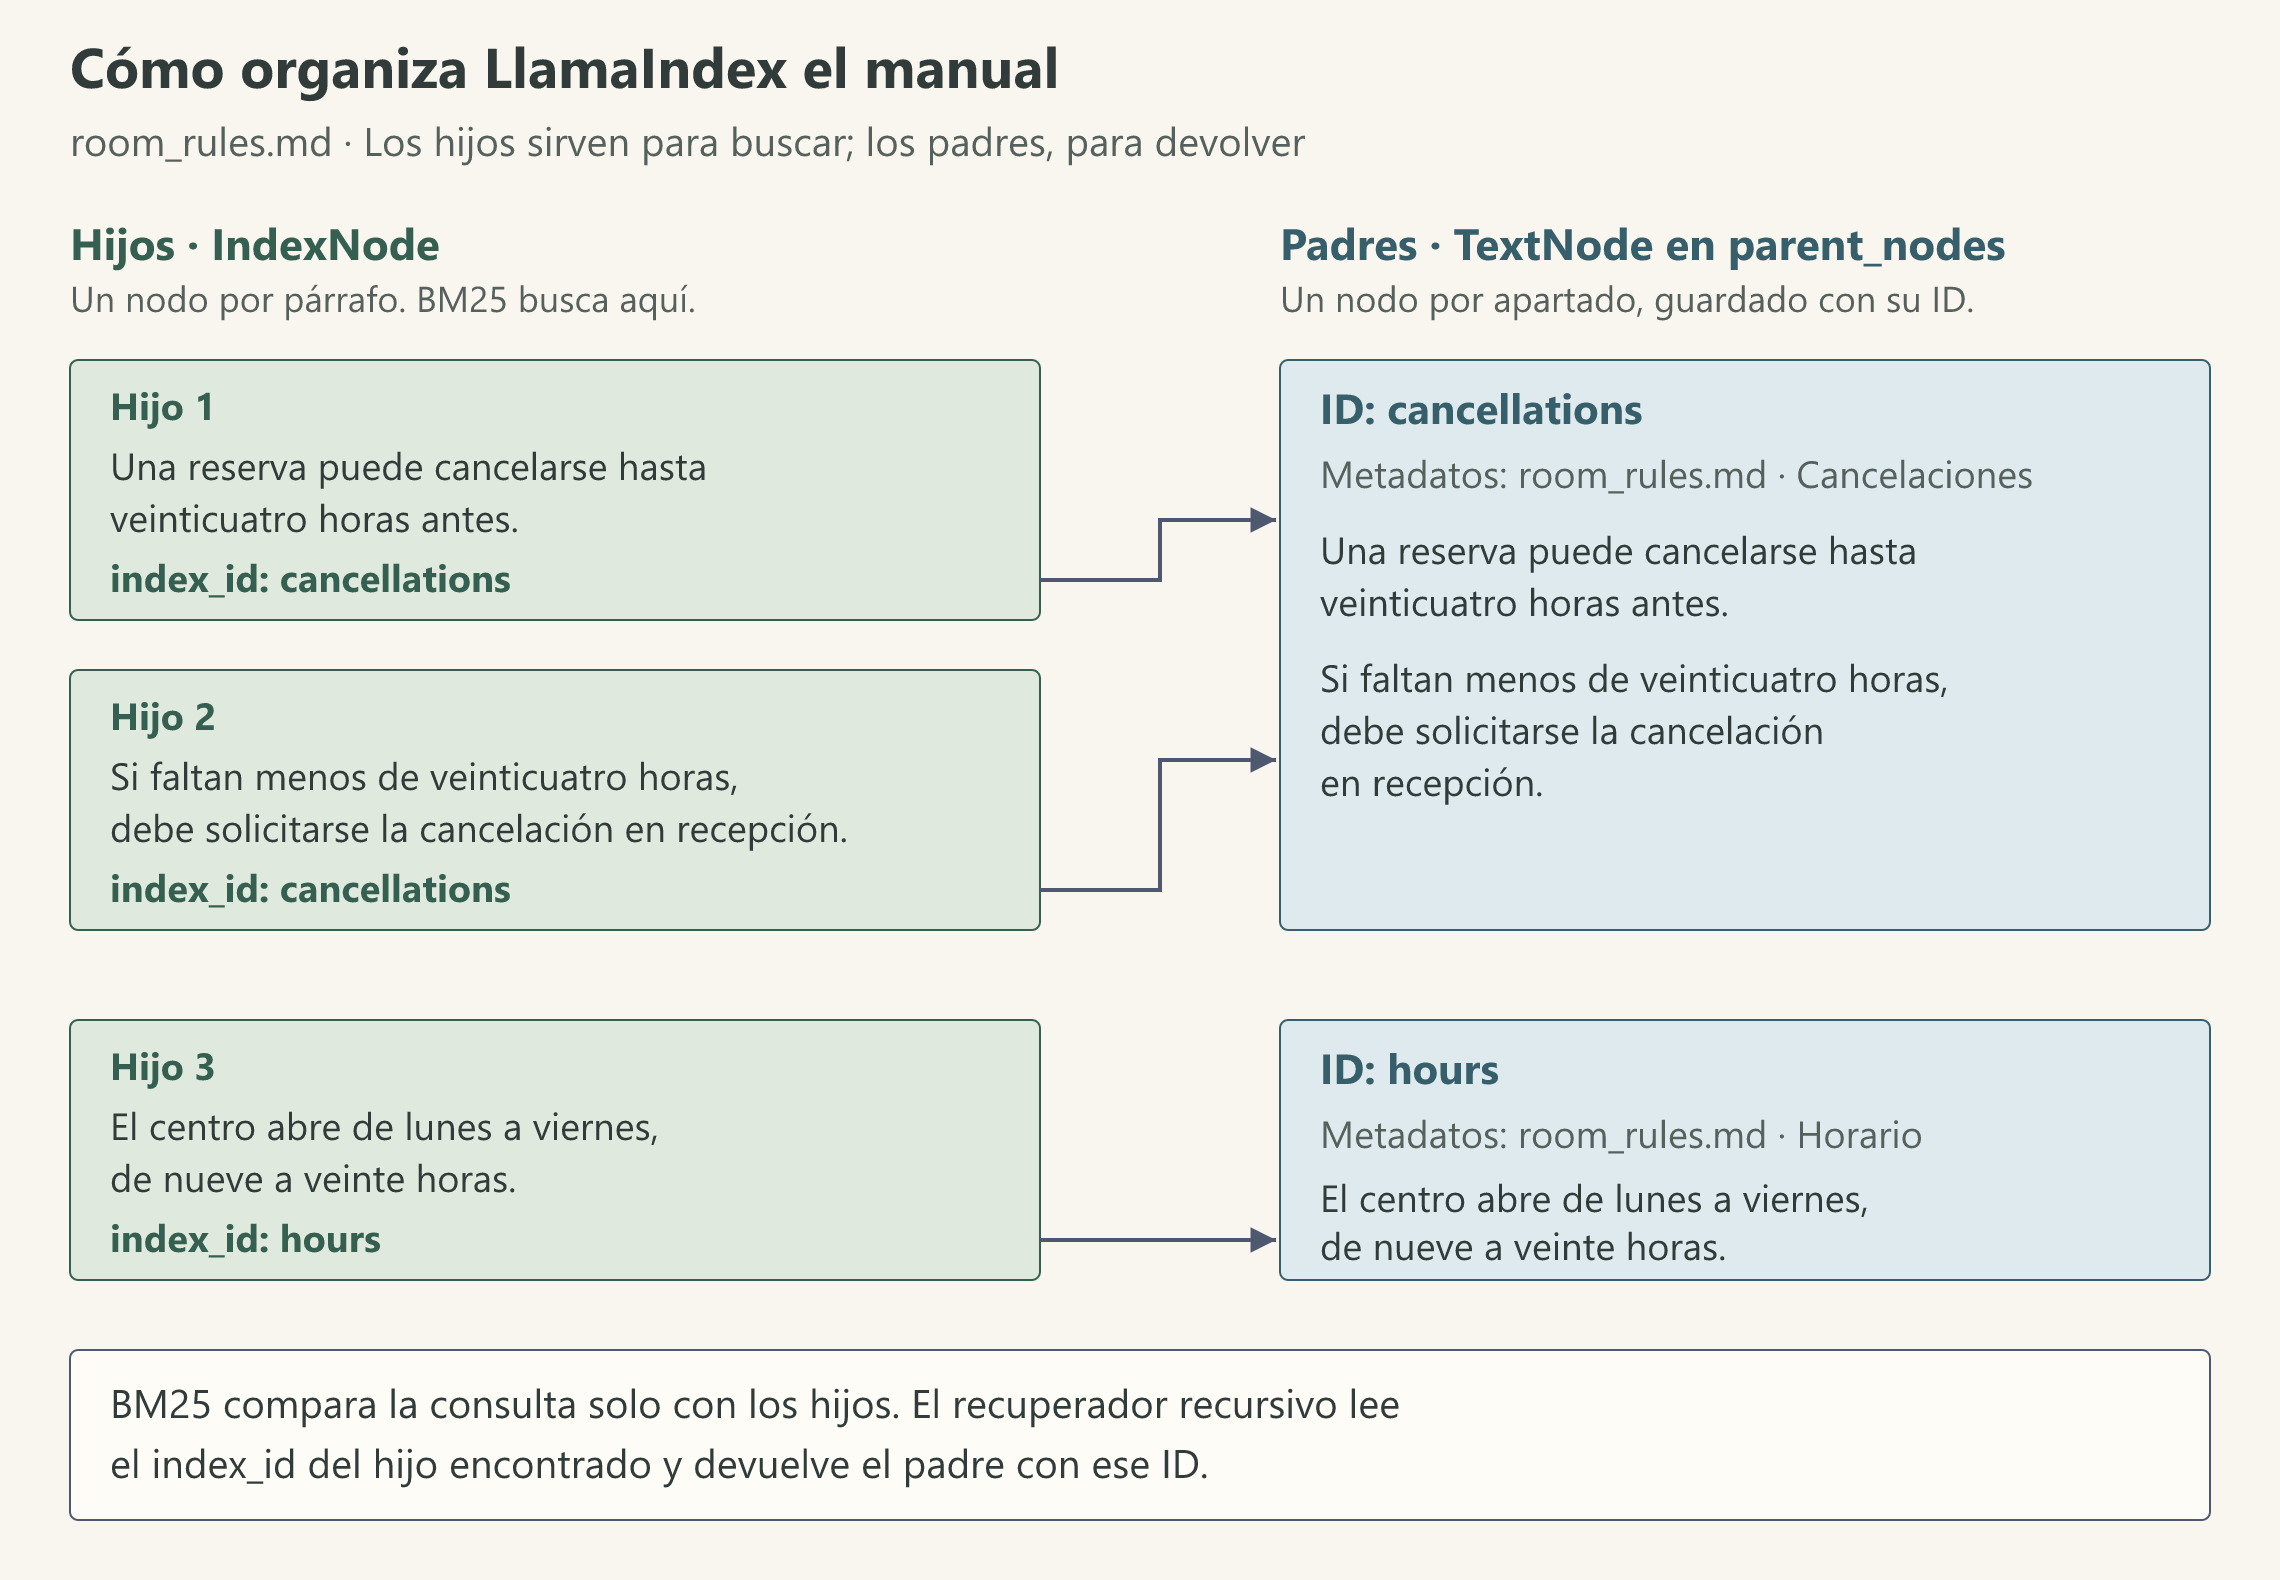
LlamaIndex no busca directamente en archivos, sino en nodos. Un nodo es un trozo de texto con dos datos añadidos: un identificador único (ID) y unos metadatos que cuentan de dónde sale, como el archivo y el título del apartado.
Con nuestro manual crearemos dos tipos de nodos:
- Padres. Un nodo por apartado, con su texto completo. LlamaIndex los representa con la clase
TextNode. Les damos nosotros el ID:cancellationspara Cancelaciones yhourspara Horario. Están en inglés porque son identificadores del código, como el nombre de una variable; serviría cualquier texto que no se repita, comoapartado-1. - Hijos. Un nodo por párrafo, que es lo que comparará la búsqueda. Usan la clase
IndexNode, que es unTextNodecon un campo más,index_id: la referencia al padre, en forma de su ID. Los dos párrafos de Cancelaciones guardanindex_id = "cancellations", y el de Horario,index_id = "hours".
Los padres se guardan aparte, en un diccionario de Python que asocia cada ID con su apartado. Lo llamaremos parent_nodes. Así queda organizado el manual:
Ver el diagrama a tamaño completo.

Funciona como el índice de un libro: el párrafo encontrado dice «ver el apartado cancellations» y el diccionario indica dónde está ese apartado. El ID solo sirve para localizarlo; no contiene sus normas. Padre e hijo describen a qué apartado apunta cada párrafo, no una jerarquía de clases.
En LlamaIndex, las piezas que reciben una consulta y devuelven nodos se llaman recuperadores (retrievers). Usaremos dos. El recuperador BM25, que ya apareció en la búsqueda híbrida, da a cada hijo una puntuación según las palabras que comparte con la consulta y devuelve los mejores. El recuperador recursivo (RecursiveRetriever) le pasa la consulta y, cuando recibe un hijo, lee su index_id y devuelve el padre con ese ID. Su ejemplo de recuperación con referencias entre nodos muestra este patrón de buscar contenido pequeño y recuperar contenido más amplio.
El recorrido de una consulta
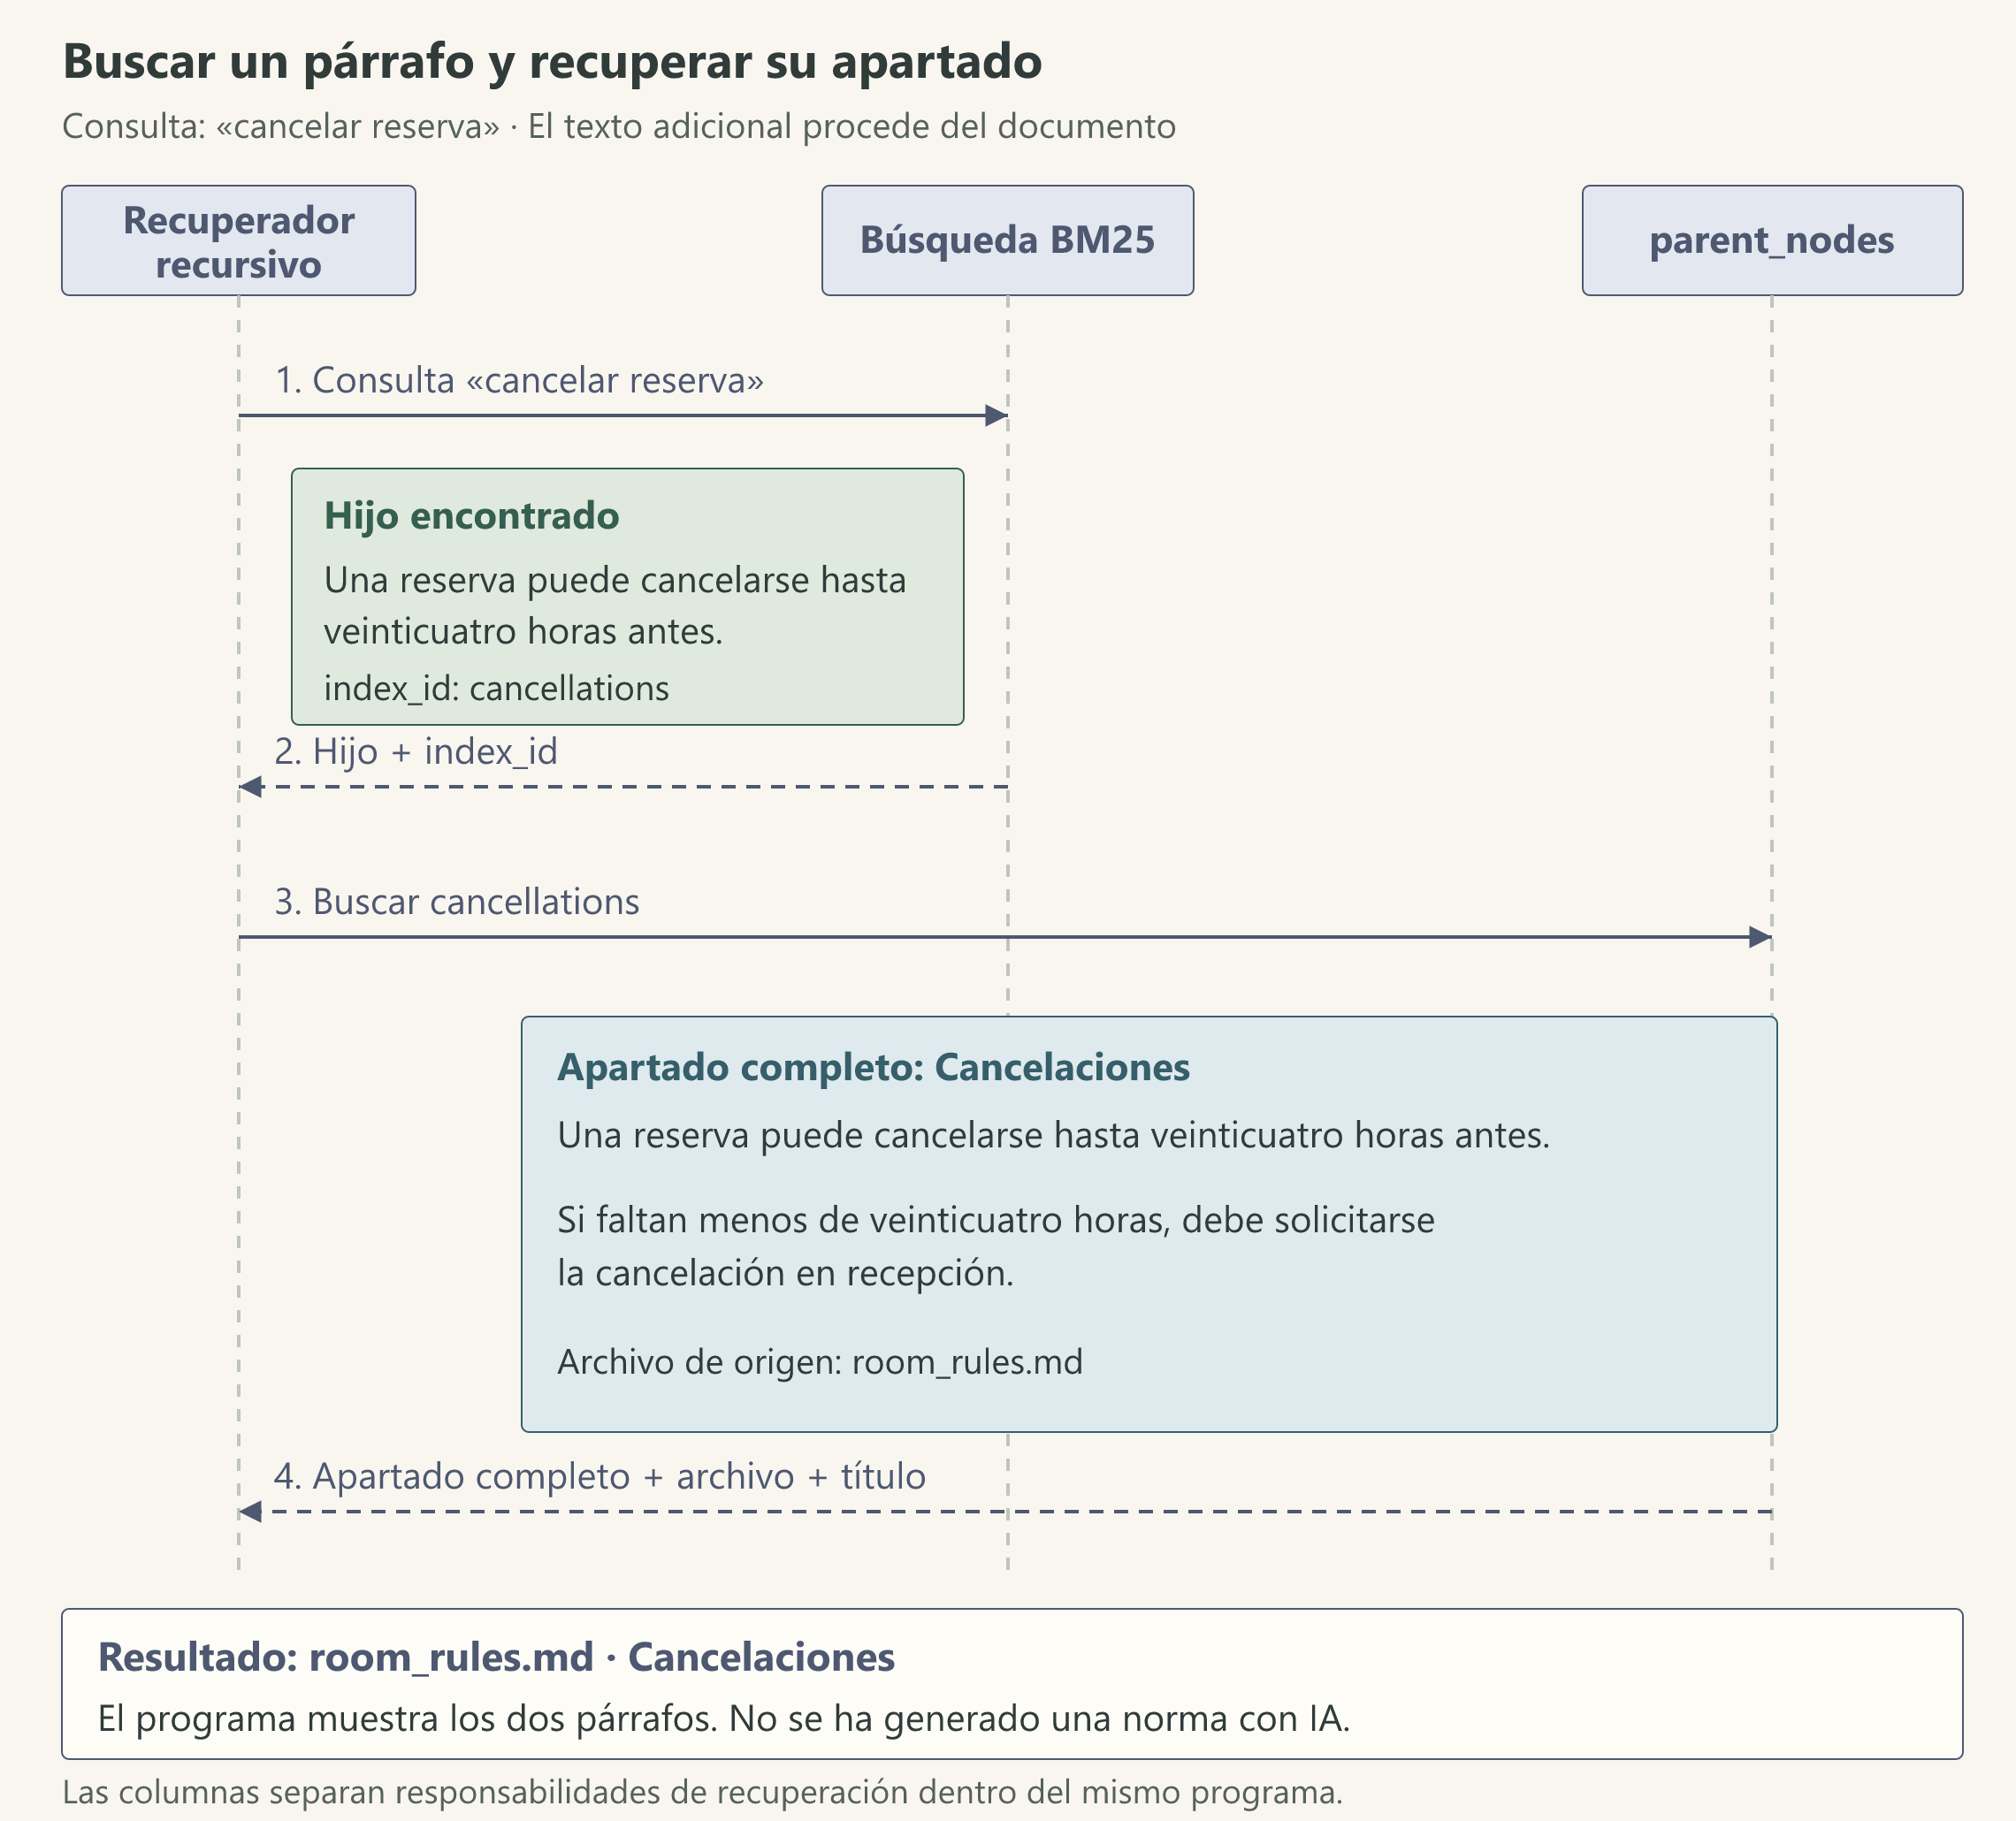
Con esa organización, la consulta cancelar reserva sigue estos pasos:
- El recuperador recursivo pasa la consulta a BM25, que puntúa los tres hijos y devuelve el primer párrafo de Cancelaciones.
- Ese hijo llega con su
index_id = "cancellations". - El recuperador recursivo busca
cancellationsenparent_nodes. - Obtiene el apartado completo, con sus dos párrafos, su archivo y su título.
El diagrama muestra esos cuatro pasos en orden. El tiempo avanza hacia abajo; las flechas discontinuas representan resultados.
Ver el diagrama a tamaño completo.

La aplicación muestra después el texto del padre junto con el archivo y el título que guardan sus metadatos:
room_rules.md · Cancelaciones
Una reserva puede cancelarse hasta veinticuatro horas antes.

Si faltan menos de veinticuatro horas, debe solicitarse la cancelación en recepción.
La búsqueda inicial puede encontrar solo una parte; la recuperación final conserva la regla y la excepción. No hemos reconstruido una frase con IA ni añadido una norma: devolvemos el texto que guardamos como apartado.
Guardar los apartados en Python
Necesitamos los paquetes llama-index-core, llama-index-retrievers-bm25 y PyStemmer. BM25 está disponible en una integración de LlamaIndex. Este ejemplo no calcula embeddings ni necesita una clave de un proveedor de IA.
Empezamos escribiendo los dos apartados como datos. No estamos leyendo un archivo en este código; source conserva el nombre del manual del ejemplo y section, el título que mostraremos al presentar el resultado.
import Stemmer
from llama_index.core.retrievers import RecursiveRetriever
from llama_index.core.schema import IndexNode, TextNode
from llama_index.retrievers.bm25 import BM25Retriever

sections = [
    TextNode(
        id_="cancellations",
        text=(
            "Una reserva puede cancelarse hasta veinticuatro horas antes."
            "\n\n"
            "Si faltan menos de veinticuatro horas, debe solicitarse "
            "la cancelación en recepción."
        ),
        metadata={"source": "room_rules.md", "section": "Cancelaciones"},
    ),
    TextNode(
        id_="hours",
        text="El centro abre de lunes a viernes, de nueve a veinte horas.",
        metadata={"source": "room_rules.md", "section": "Horario"},
    ),
]

parent_nodes = {section.node_id: section for section in sections}
id_ permite asignar un identificador al crear el nodo y node_id permite leerlo; la última línea construye parent_nodes con esos IDs como claves.
Crear fragmentos que apunten al apartado
En este manual una línea en blanco separa los párrafos. Los utilizaremos como fragmentos pequeños. Para cada uno guardamos en index_id el ID del apartado del que sale:
child_nodes = []

for section in sections:
    for paragraph in section.text.split("\n\n"):
        child_nodes.append(
            IndexNode(
                text=paragraph,
                index_id=section.node_id,
            )
        )
Obtenemos los tres hijos del diagrama de organización. No pegamos el segundo párrafo al primero después de buscar: el apartado completo existe desde la preparación y cada hijo guarda cómo llegar a él.
Buscar en los hijos y recuperar el padre
Configuramos BM25 para buscar en los tres hijos y devolver un candidato. Utilizamos un stemmer de español, que reduce ciertas variantes de una palabra a una forma común, y stopwords de español, palabras frecuentes que se descartan durante la búsqueda; las activa language="spanish". Por ejemplo, cancelar, cancelarse y cancelación se reducen a la misma raíz, cancel. Por eso los dos párrafos de Cancelaciones coinciden con la consulta, pero solo el primero contiene también reserva, y gana.
paragraph_retriever = BM25Retriever.from_defaults(
    nodes=child_nodes,
    similarity_top_k=1,
    stemmer=Stemmer.Stemmer("spanish"),
    language="spanish",
)

retriever = RecursiveRetriever(
    "paragraphs",
    retriever_dict={"paragraphs": paragraph_retriever},
    node_dict=parent_nodes,
)
paragraph_retriever es el recuperador BM25 y retriever, el recursivo. La etiqueta paragraphs identifica el recuperador inicial: coincide con la clave utilizada en retriever_dict. No es el nombre de un archivo ni del apartado que esperamos encontrar.
node_dict=parent_nodes es el diccionario donde el recursivo busca cada index_id. La documentación de la integración BM25 explica el resto de opciones de paragraph_retriever.
Ahora ejecutamos la consulta y mostramos cada apartado devuelto:
matches = retriever.retrieve("cancelar reserva")

for match in matches:
    node = match.node
    print(node.metadata["source"], "·", node.metadata["section"])
    print(node.get_content())
Con estos datos se obtiene el resultado de Cancelaciones mostrado en el recorrido. Cada match reúne un nodo (match.node) y su puntuación (match.score). Aquí match.node es el padre recuperado: de él leemos los metadatos y el contenido completo, no solo el párrafo que puntuó mejor en la búsqueda.
Dónde compensa esta técnica
Buscar en fragmentos pequeños y devolver su apartado completo tiene sentido cuando los documentos tienen una estructura clara y las reglas dependen de su contexto:
- Condiciones de venta y atención al cliente. Plazos, excepciones y requisitos suelen ir en párrafos consecutivos. Devolver el apartado de devoluciones entero evita prometer un plazo sin su excepción.
- Normativa interna y convenios. Un artículo de un convenio puede tener una regla general y varios supuestos especiales. La persona necesita el artículo completo, no la frase que más se parece a su pregunta.
- Documentación técnica. Una consulta como «límite de peticiones por minuto» encuentra una línea concreta, pero la respuesta útil es la sección de ese endpoint, con sus condiciones y sus errores.
- Manuales de procedimiento. En un procedimiento de mantenimiento o de seguridad, un paso y su advertencia suelen ir en párrafos separados («desconecte el equipo» y, debajo, «espere cinco minutos antes de abrirlo»). Devolver solo el paso es dar media instrucción.
En el manual del ejemplo, con dos apartados diminutos, podríamos buscar directamente en ellos; la separación compensa cuando los apartados contienen bastante más información. Y si los documentos son textos cortos e independientes, como fichas de producto o preguntas frecuentes de una línea, no hace falta: cada trozo ya es su propio apartado.
Qué conserva esta técnica y qué hay que revisar
El tamaño de búsqueda y el tamaño de recuperación son decisiones distintas. Si aumentamos el número de candidatos, varios hijos pueden conducir al mismo padre: con similarity_top_k=2, nuestra consulta encuentra los dos párrafos de Cancelaciones y el recuperador recursivo devuelve un único apartado. Más candidatos no equivalen necesariamente a más fuentes diferentes.
El padre tampoco debe convertirse en un documento enorme que arrastre información ajena. Necesitamos una unidad que amplíe la explicación sin perder el foco. En este caso es un apartado con una regla y su condición especial. En otros documentos puede ser una subsección o un bloque de varios párrafos relacionados.
Hay alternativas para ampliar contexto. Una ventana de oraciones añade frases vecinas alrededor del resultado. La fusión automática de nodos puede reunir varios hijos en su padre cuando se cumple un criterio de recuperación. Son mecanismos diferentes: nuestro ejemplo sigue directamente una referencia desde el fragmento encontrado, sin esperar a recuperar una mayoría de sus hermanos.
Si una norma cambia, hay que actualizar el padre y los fragmentos que se utilizan para buscar. También debemos conservar las referencias válidas: si un hijo apunta a un apartado que no existe, la recuperación falla con un error.
Con esta configuración, una consulta sin coincidencias puede devolver un candidato con puntuación cero. Y hay un detalle que conviene conocer: al seguir la referencia, RecursiveRetriever sustituye esa puntuación cero por 1.0 en el padre que devuelve. Si queremos descartar resultados sin coincidencias, hay que hacerlo antes del salto: consultar primero paragraph_retriever, descartar los fragmentos con puntuación cero y solo entonces buscar su padre en parent_nodes. Filtrar por match.score al final no sirve.
Un apartado útil puede enviarse después a un modelo junto con la pregunta, como contexto de una aplicación RAG, que busca en nuestros documentos y redacta con lo encontrado (RAG paso a paso). Haberlo recuperado completo no garantiza que conteste cualquier consulta ni que su contenido esté actualizado: seguimos necesitando revisar las fuentes y evaluar las preguntas que realmente queremos resolver.
Para nuestra búsqueda, la diferencia es visible: la frase encontrada habla de veinticuatro horas y el apartado recuperado conserva también qué hacer cuando falta menos tiempo. Esa segunda indicación procede del documento, no de una suposición del modelo.