Queremos que una aplicación encuentre cómo cancelar una reserva dentro de un manual. Si guarda todo el documento como un único texto, cada resultado puede arrastrar horarios, normas de uso y páginas que no necesitamos. Si lo corta sin cuidado, puede separar una regla de la excepción que cambia su significado.
La solución consiste en leer el documento, dividirlo en apartados que conserven una idea completa y guardar de dónde sale cada uno. Después, el buscador compara la consulta con esos fragmentos y devuelve el texto que encuentra más pertinente junto con su origen.
Ese es el recorrido que vamos a construir en Python:
- Leer un manual pequeño.
- Crear un fragmento por apartado, conservando su título y el nombre del archivo.
- Buscar mediante coincidencias de palabras.
- Devolver el apartado elegido con su contenido completo.
Es la preparación y recuperación documental que puede utilizar una aplicación RAG antes de enviar información al modelo. Aquí seguiremos esa búsqueda hasta su resultado, sin realizar llamadas a una IA.
Del manual al texto que queremos encontrar
Nuestro archivo room_rules.md contiene estas normas ficticias. Está escrito en Markdown: las líneas que comienzan por ## identifican los títulos de sus apartados.
## Reservas
Las salas se reservan para sesiones de sesenta minutos.
Una persona solo puede mantener una reserva activa.

## Cancelaciones
Una reserva puede cancelarse hasta veinticuatro horas antes.

Si faltan menos de veinticuatro horas, debe solicitarse la cancelación en recepción.

## Horario
El centro abre de lunes a viernes, de nueve a veinte horas.
La persona escribe en el buscador cancelación reserva. Nuestro programa prepara tres fragmentos: Reservas, Cancelaciones y Horario. En este ejemplo un fragmento es el texto de un apartado, acompañado de su título y del archivo del que procede.
Para elegir uno, contamos cuántas palabras distintas de la consulta aparecen en su texto:
| Apartado | Palabras de la consulta que aparecen | Puntuación |
|---|---|---|
| Reservas | reserva |
1 |
| Cancelaciones | cancelación, reserva |
2 |
| Horario | Ninguna. | 0 |
Gana Cancelaciones. El resultado que queremos devolver contiene:
room_rules.md
Cancelaciones
Una reserva puede cancelarse hasta veinticuatro horas antes.

Si faltan menos de veinticuatro horas, debe solicitarse la cancelación en recepción.
La segunda frase permanece junto a la primera. Así quien utilice el resultado conocerá también qué hacer cuando falta menos tiempo. La puntuación sirve para elegir el apartado; el contenido que necesitamos es su texto, no el número dos.
Elegir fragmentos que conserven el sentido
Dividir documentos se conoce como fragmentación o chunking. El criterio de corte importa: un límite fijo de caracteres podría terminar justo después de la primera norma de cancelación y dejar la segunda en otro fragmento.
En nuestro manual aprovechamos una estructura que ya existe: cada encabezado agrupa un tema. Por eso mantenemos juntos sus párrafos. Un apartado puede tener varias frases y seguir siendo una unidad pequeña y comprensible.
Esto no convierte el encabezado en una regla universal. Un capítulo de cien páginas exigiría cortes más pequeños; dos líneas que se refieren al apartado anterior pueden necesitar contexto adicional. El tamaño debe permitir recuperar una explicación útil sin arrastrar demasiado contenido ajeno. La explicación de recuperación contextual de Anthropic muestra cómo perder el contexto de un fragmento puede dificultar su interpretación y recuperación.
Junto al contenido guardamos dos metadatos: el nombre del archivo y el título del apartado. Los utilizaremos al presentar el resultado, para que la persona pueda localizarlo en la fuente. No intervienen en nuestra puntuación, que solo cuenta palabras del texto.
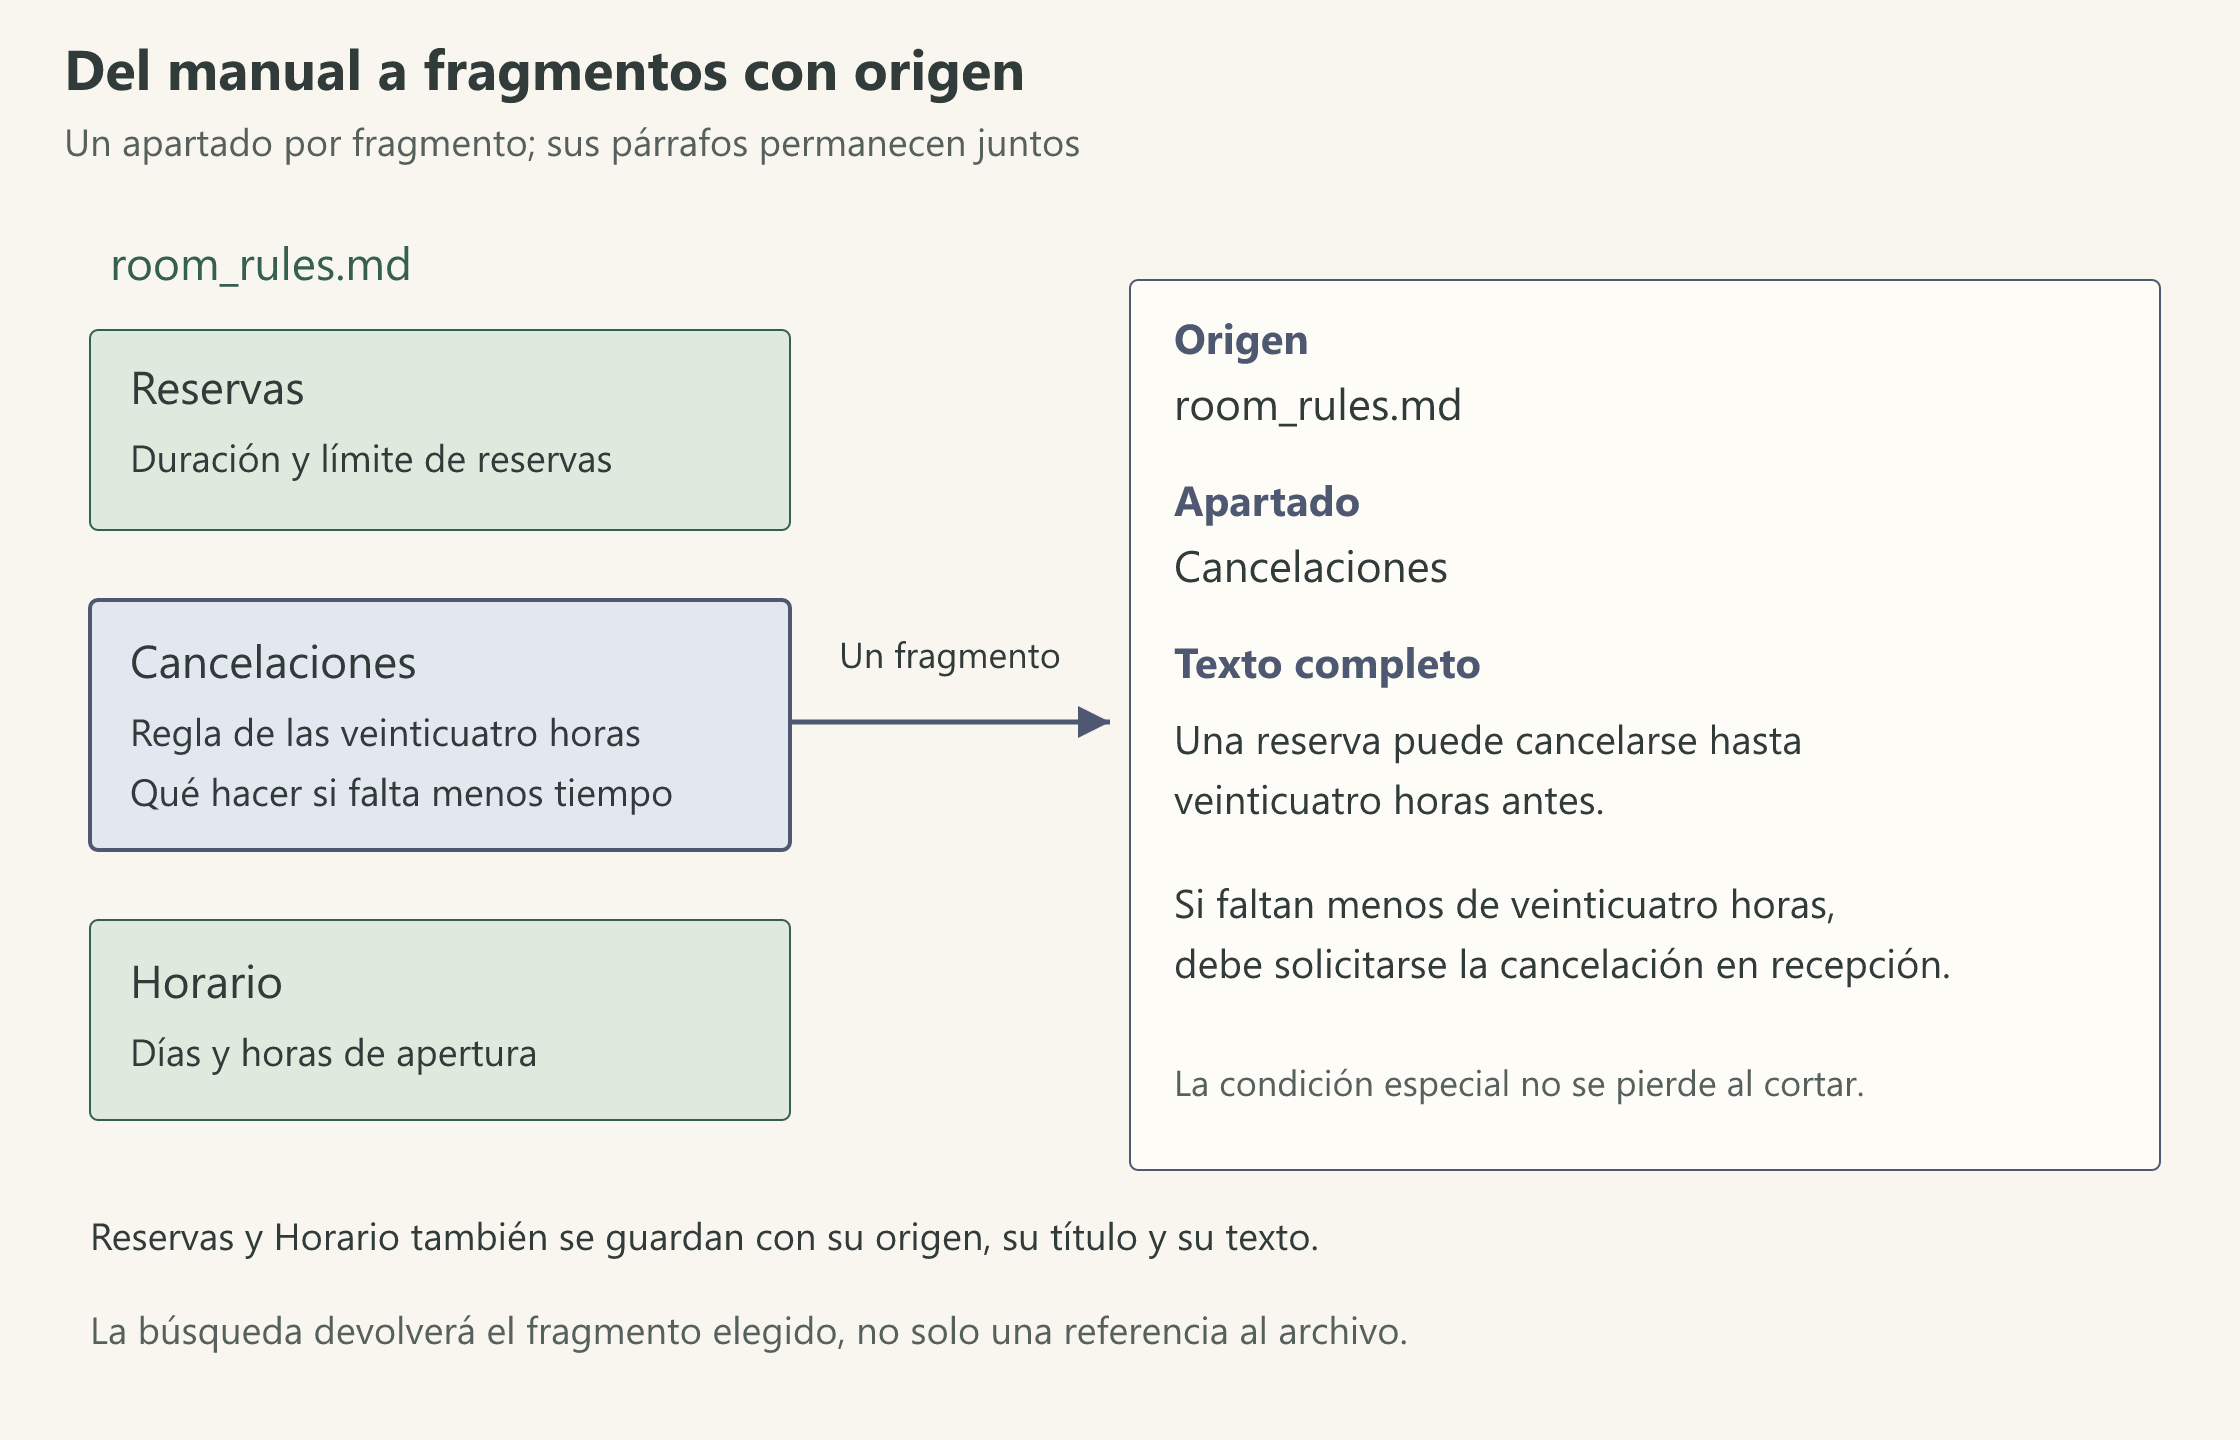
Abrir el diagrama a tamaño completo.

La figura muestra la separación del manual y amplía el fragmento de cancelaciones. Tanto el texto de la regla como su condición especial viajan con el resultado.
Representar un fragmento en Python
Podemos describirlo con una clase pequeña. source_name guarda el nombre del archivo, heading el título del apartado y text su contenido:
from dataclasses import dataclass


@dataclass(frozen=True)
class Passage:
    """Keep a section's text together with its source."""

    source_name: str
    heading: str
    text: str
La guardamos en passage.py. dataclass genera la inicialización de los campos; frozen=True impide reasignarlos después de crear el objeto. Esta clase sirve para transportar el resultado de leer un apartado. No busca ni llama a un modelo.
El fragmento de nuestro ejemplo tendrá "room_rules.md" como origen, "Cancelaciones" como título y las dos frases como contenido.
Leer el archivo y separar sus apartados
La función siguiente recibe la ruta del archivo y devuelve una lista de Passage. Primero lee el texto; después identifica los encabezados y conserva lo que hay bajo cada uno.
import re
from pathlib import Path

from passage import Passage


def read_passages(path: Path) -> list[Passage]:
    """Read sections from the simple Markdown format used here."""
    source_text = path.read_text(encoding="utf-8")
    blocks = re.split(r"^## ", source_text, flags=re.MULTILINE)
    passages = []

    introduction = blocks[0].strip()
    if introduction:
        passages.append(Passage(path.name, "Introducción", introduction))

    for block in blocks[1:]:
        heading, _, body = block.partition("\n")
        if body.strip():
            passages.append(Passage(path.name, heading.strip(), body.strip()))

    return passages
read_text carga el archivo como texto usando UTF-8 y cierra el archivo después de leerlo, tal como describe la documentación de Python. Si no existe o no podemos leerlo, la operación genera un error; no lo sustituimos por una colección vacía.
re.split separa por las líneas que empiezan por ## . Cada bloque resultante contiene un título en su primera línea y el contenido debajo. partition("\n") separa ambas partes por el primer salto de línea. El guion bajo recoge el separador, que no necesitamos utilizar.
Si hay texto antes del primer apartado lo conservamos como introducción. Los apartados vacíos se omiten. Los párrafos de Cancelaciones quedan dentro del mismo body, incluido el salto de línea que los separa.
Este lector está pensado para el formato sencillo del ejemplo. No es un parser completo de Markdown: habría que distinguir, por ejemplo, un encabezado real de un ## escrito dentro de un bloque de código. Para documentos arbitrarios conviene utilizar un parser que reconozca su estructura. La especificación de CommonMark describe esas reglas.
Buscar entre los fragmentos preparados
Ya sabemos cómo elegir el resultado: contar coincidencias y quedarnos con la puntuación más alta. Esta función recibe los fragmentos y las palabras de búsqueda; devuelve el mejor fragmento o None si ninguno coincide.
def find_passage(passages: list[Passage], query: str) -> Passage | None:
    """Return the first passage with the highest positive overlap."""
    query_terms = set(re.findall(r"\w+", query.casefold()))
    best_passage = None
    best_score = 0

    for passage in passages:
        passage_terms = set(re.findall(r"\w+", passage.text.casefold()))
        score = len(query_terms & passage_terms)
        if score > best_score:
            best_passage = passage
            best_score = score

    return best_passage
Podemos guardar esta función junto a read_passages, en document_search.py, utilizando los mismos imports. casefold permite comparar sin distinguir mayúsculas y minúsculas. re.findall obtiene las palabras y set elimina las repeticiones. La intersección & contiene las palabras comunes; len las cuenta.
Solo cambiamos el resultado cuando la puntuación mejora. En caso de empate conservamos el primero del archivo. Si todas las puntuaciones son cero, devolvemos None.
Para usar el recorrido completo, otro módulo carga el manual, busca y presenta lo encontrado:
from pathlib import Path

from document_search import find_passage, read_passages

passages = read_passages(Path("room_rules.md"))
result = find_passage(passages, "cancelación reserva")

if result is None:
    print("No matching section found.")
else:
    print(result.source_name)
    print(result.heading)
    print(result.text)
Con el archivo mostrado, esas líneas producen el resultado de Cancelaciones que vimos al principio. Se utilizan los tres campos del fragmento: origen y título para localizarlo, y texto para leer las normas. El archivo original sigue intacto.
Qué hemos encontrado y qué queda por comprobar
Nuestra búsqueda es léxica: compara palabras. No interpreta que «anular» pueda tener relación con «cancelar», no iguala singular y plural y conserva las diferencias de acentos. Las puntuaciones tampoco representan probabilidades de acierto. Es un procedimiento pequeño cuyo funcionamiento podemos seguir con los datos del ejemplo.
Probaríamos que devuelve Cancelaciones para cancelación reserva, que mantiene juntos sus dos párrafos y que no devuelve un resultado para aparcamiento. También revisaríamos qué pasa al modificar una norma o añadir un apartado: hay que volver a preparar los fragmentos para buscar sobre el contenido actualizado.
Si este resultado se utiliza después para redactar con un LLM, la aplicación tendrá que enviarle el texto recuperado y la pregunta. Tener el nombre del archivo o una puntuación no proporciona al modelo las normas. Y un apartado encontrado por coincidencias todavía puede ser insuficiente para responder otra consulta.
En este caso el resultado útil conserva la regla de las veinticuatro horas, la indicación de acudir a recepción y el lugar del manual donde ambas aparecen. Ese contenido permite comprobar qué dice la fuente antes de utilizarlo en una respuesta.